DeepSeek-V4.1-Flash 规格速查
552B MoE、1M 上下文、输入 8B / 输出 16B 非对称激活,配分级定价与一笔真实调用成本账。把 V4.1-Flash 的规格、结构变化与适用边界整理成可核对的条目。
规格 SPECIFICATION
- 厂商
- 深度求索(DeepSeek)
- 参数规模
- 552B(MoE 总参数,输入激活约 8B / 输出激活约 16B)
- 上下文长度
- 1M tokens(最大输出 384K)
- 模态
- 多模态
- 许可
- 开放权重
- 版本
- DeepSeek-V4.1-Flash-1017
- 参考价格
- 缓存命中 0.02–0.04 元;未命中 1–2 元;输出 4–8 元(每百万 tokens,空闲为高峰半价)
- 发布日期
- 2026-09-10
- 官网 / 文档
- 打开 ↗
- 收录时间
- 2026年11月9日
评测 BENCHMARK
- 官方称在 Agentic Benchmark 上超过含 V4-Pro 在内的旗舰;KV Cache 对 HBM 需求降至上一代 1/4、SSD 降至 1/8,较初代缩小 437 倍。
说明 NOTES
DeepSeek-V4.1-Flash 是深度求索在 2026 年 9 月发布的新一代主力模型,API 调用名已统一为 deepseek-flash。它换掉了上一代的 Dense-MoE 结构,改用非对称的 Causal-Encoder-Decoder,并把上下文从 128K 拉到 1M。这篇笔记把规格、结构变化、缓存压缩和价格整理成可核对的条目,末尾给一笔实际的调用成本账。
一、规格一览
| 项目 | 取值 |
|---|---|
| 厂商 | 深度求索(DeepSeek) |
| 模型版本 | DeepSeek-V4.1-Flash-1017 |
| 参数规模 | 552B(MoE 总参数) |
| 激活参数 | 输入约 8B,输出约 16B |
| 上下文长度 | 1M tokens |
| 最大输出 | 384K tokens |
| 模态 | 文本 + 原生图像理解(不含图像生成) |
| 许可 | 开放权重(权重发布于 Hugging Face,具体条款以仓库标注为准) |
| 发布时间 | 2026 年 9 月 10 日;权重于 10 月 17 日刷新为 1017 版本 |
| API 模型名 | deepseek-flash |
| 并发上限 | 2500 |
接口能力上,JSON 输出、Tool Calls、Responses API、Anthropic 兼容接口均支持;对话前缀续写与 FIM 补全仅在非思考模式下可用。思考模式默认开启,可在请求里关闭。
二、非对称结构改变了什么
这一代最实质的改动不在参数总量,而在输入与输出走了不同的路径。传统 Decoder-only 模型对输入和输出使用同一套参数,prefill 阶段要一次性处理整段提示,激活量随上下文线性增长。V4.1-Flash 把输入侧压到约 8B 激活,输出侧保留约 16B,形成 Causal-Encoder-Decoder 的不对称结构。
差异来自两段计算的特性。prefill 是并行的矩阵运算,算力密度高、对参数规模不敏感;decode 是逐 token 生成,每一步都要重新决策,更需要表达能力。
把两侧分开,等于按实际负载分配算力,而不是让同一组参数同时承担两种任务。这也是「小激活、大总参」路线能成立的前提。
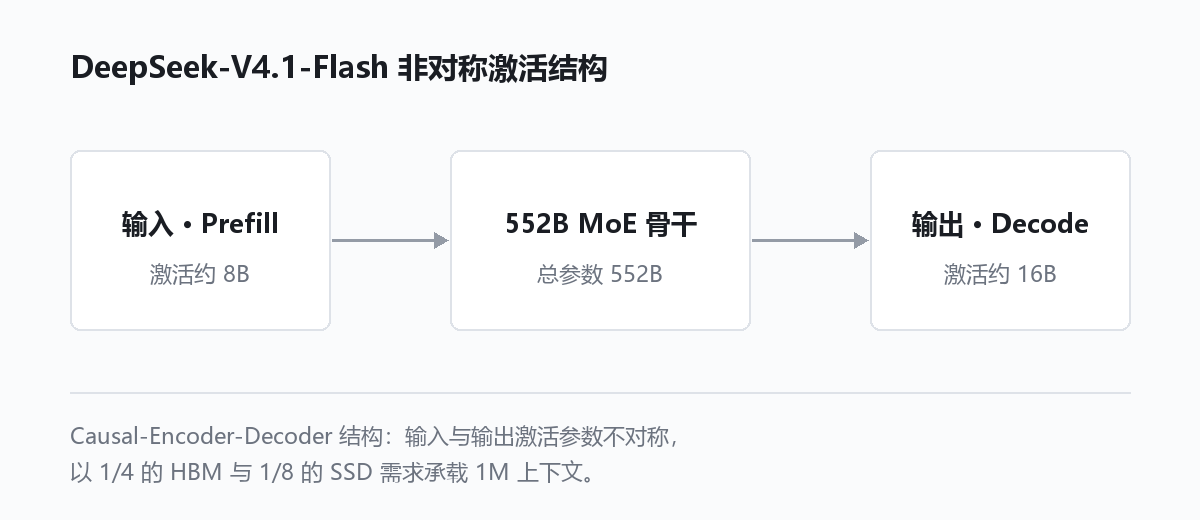
官方给出的结果是:在 Agentic Benchmark 上,V4.1-Flash 超过了包括 V4-Pro 在内的一批旗舰模型。这类自评成绩需要谨慎对待,但结合「更小激活 + 更长上下文」的组合来看,它指向的方向是明确的——用结构效率换成本,而不是用参数堆能力。
三、KV Cache 压缩与 1M 上下文的真实含义
长上下文的成本大头往往不是注意力计算,而是 KV Cache 的存储。序列越长,缓存越占显存,并发就被压得越低。V4.1-Flash 在这一项上做了两件事:相对上一代把 HBM 需求降到四分之一、SSD 需求降到八分之一;相对初代模型,KV Cache 整体缩小了 437 倍。
这个数字对 Agent 类任务更有意义。Agent 通常要在多轮工具调用间保持长对话,缓存命中费在总成本中占比很高。
缓存小了,同样的显存能挂更多并发,命中率也更容易维持。这是它能把 1M 上下文做成默认配置、而不是高级选项的原因。
需要保留一个判断:1M 上下文是容量上限,不等于有效长度。中段信息召回、跨文档引用这类能力,仍建议用自己的文档做三位置对照测试,不要直接按标称值规划架构。
四、价格、调用与适用边界
官方定价按空闲与高峰两个时段计价,空闲时段为高峰的一半。高峰指北京时间周一至周五(不含法定节假日)9:00–12:00 与 14:00–18:00。
| 计费项(元 / 百万 tokens) | 空闲时段 | 高峰时段 |
|---|---|---|
| 输入(缓存命中) | 0.02 | 0.04 |
| 输入(缓存未命中) | 1 | 2 |
| 输出 | 4 | 8 |
按 1000 次请求、每次 2000 输入 token 与 500 输出 token、缓存命中率 80% 估算:命中部分 1.6M tokens 计 0.064 元,未命中部分 0.4M tokens 计 0.8 元,输出 0.5M tokens 计 4 元。
高峰时段合计约 4.86 元;放到空闲时段约 2.43 元。输出占了大头,压缩输出长度比压缩输入更省钱——这也是为什么「先想清楚再输出」在成本上是有回报的。
调用方式与旧版一致,只改模型名:base_url 用 https://api.deepseek.com,model 传 deepseek-flash。旧模型名 deepseek-v4-flash 与 deepseek-v4-flash-vision-exp 仍可调用,但会被路由到 V4.1-Flash 并按 Flash 价格计费。V4-Pro 自 2026 年 9 月 14 日起也已路由至该模型。
不适用的场景有两类:需要明确许可证条款才能商用的合规审查,应去 Hugging Face 仓库核对具体许可,而不是依赖本文概述;需要图像生成的任务,这个模型只做理解,不做生成。
模型迭代速度快,本文数据取自官方发布说明与 API 定价页。做选型决策前,建议再核对一次定价页上的时段与单价,确认没有新的调价。
登录后可点赞、收藏与反馈。