换个 Agent 就得从头交代项目?AGENTS.md 三层知识库抄作业:四工具兼容与翻车急救
同一份项目约定别给每个 Agent 各养一份。AGENTS.md 当唯一事实源,L1 入口 / L2 模块文档 / L3 源码注释三层分工,四款工具具体接入命令(含 CLAUDE.local.md 抢占、.mdc 静默忽略等坑),知识随代码更新的两条回写闭环与八条翻车急救清单。
全网教程默认你只用一个 AI 编码工具:教 Claude Code 的只讲 CLAUDE.md,教 Cursor 的只讲 .cursor/rules,教 Codex 的只讲 AGENTS.md。现实是团队里你用 Codex、同事用 Cursor、你自己在终端又开 Claude Code——同一个仓库,「这个项目怎么干活」这件事,每个人每个工具都得从头交代一遍。
更隐蔽的浪费在排查结论上。某次会话里你确认了「/v1/orders 还被支持期内的旧版 App 调用,不能删」,Agent 停手恢复代码,任务结束。但这条兼容约束只停在那次聊天记录里——下个会话扫废弃代码,Agent 看到的还是同一组搜索结果,照样建议删除。约束没有落进仓库,就等于不存在。
好消息是这条路线走得通,而且已经有人把路铺好了:agents.md 官网显示 6 万多个开源项目在用这份文件,官方页面列出 20 多款工具原生支持;得物技术 2026 年 11 月公开的 Akashic 实践,把仓库约定做成了随代码自动更新的三层知识库。本文所有配置都给到具体文件和命令,文末附一张翻车急救表。
为什么 CLAUDE.md、.cursor/rules 各养一份,最后一定乱
先把各家「项目记忆」文件的真实加载逻辑摆在一起看(均为官方文档口径):
| 文件 | 谁在读 | 加载逻辑(官方口径) |
|---|---|---|
| AGENTS.md | Codex / Cursor / Gemini CLI 等 20+ 工具原生 | 根目录 + 子目录嵌套,离当前目录越近的越优先 |
| CLAUDE.md | Claude Code | 四层拼接不覆盖:组织策略 → 用户级 → 项目级 → 本地级 |
| .cursor/rules/*.mdc | Cursor | frontmatter(alwaysApply / globs / description)控制四种生效方式 |
| GEMINI.md | Gemini CLI | 默认文件名,可在 settings.json 里改指向 |
问题不在这些机制本身,而在于同一份项目约定被复制了 N 份。测试命令换了、分支策略改了,你得记得同步四处;漏掉任何一处,那个工具就会永远用旧命令、守旧规矩。漂移不是会不会发生的问题,是什么时候发生的问题。
正解是把方向反过来:AGENTS.md 当唯一事实源,其它文件全部指回它。约定只写一遍,各工具用自己的方式把它装进上下文。
三层结构怎么抄:入口只做路由,细节按需下钻
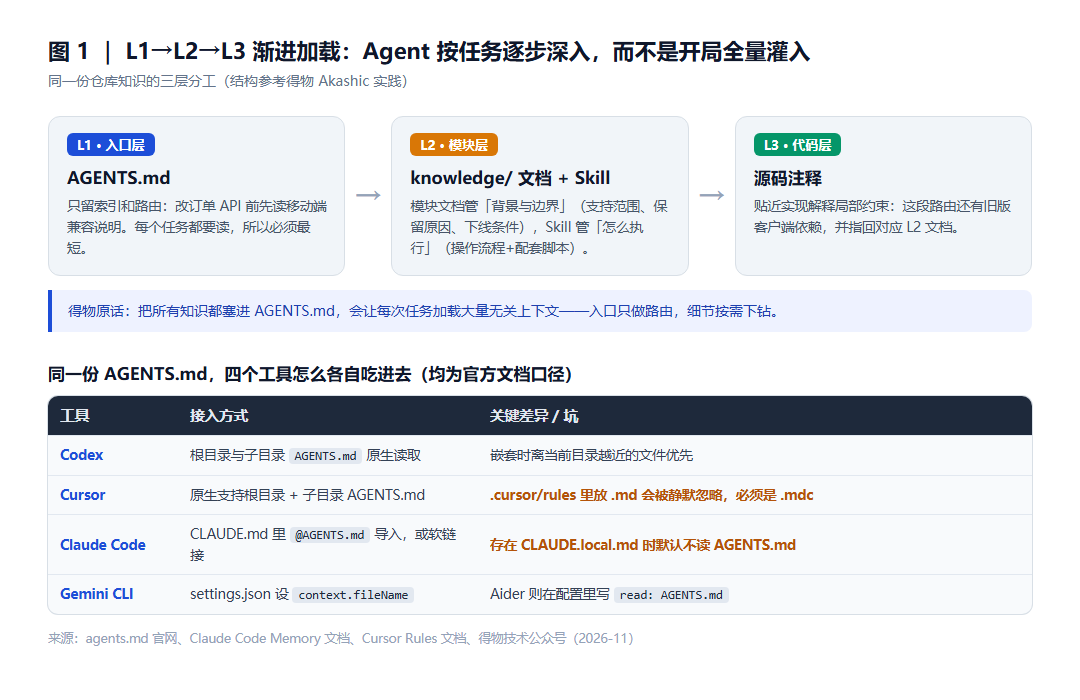
直接把约定全塞进 AGENTS.md 也不行。得物在 Akashic 实践里说得很直白:仓库知识的使用频率、适用范围、变化频率都不一样,全塞进入口文件,每次任务都要加载大量无关上下文,维护成本跟着涨。他们的解法是按「什么时候读」分三层:
- L1 · AGENTS.md 入口层:只留索引和路由,比如「改订单 API 前先读移动端兼容说明」。每个任务都要读,所以必须最短;
- L2 · knowledge/ 模块文档 + Skill:模块文档管背景与边界(支持范围、保留原因、下线条件),Skill 管执行流程(怎么做、怎么验证);
- L3 · 源码注释:贴近代码解释局部约束——这段路由还有旧版客户端依赖,并指回对应 L2 文档。
落到那个 /v1/orders 的例子里:Agent 清理废弃代码时,从 L1 入口被引到移动端兼容说明,看到「旧版 App 还在支持期内」,自然停手——不用任何人坐在旁边重新解释。
L2 目录结构可以直接抄这个骨架:
knowledge/
├── README.md            # L2 总索引
├── docs/
│   ├── 02-整体架构.md
│   └── modules/         # 每个模块一份:职责、边界、下线条件
│       └── orders.md    # 例:/v1/orders 兼容说明就放这里
└── skills/              # 面向任务的操作流程
    └── legacy-route-cleanup/
        └── SKILL.md
个人或小团队不必照搬全套:L2 用 docs/ 目录加几篇模块说明就够,Skill 没有就先写成文档里的「操作流程」小节。分层的关键是入口最短、细节按需读,而不是目录多漂亮。
四个工具吃同一份 AGENTS.md:具体接入配置
Codex:零配置
仓库根放 AGENTS.md 即可,原生读取。monorepo 在子包里再放一份,离当前工作目录越近的文件优先——agents.md 官网举例说,OpenAI 自己的主仓库放了 88 个 AGENTS.md。
Cursor:原生支持,但有个静默坑
Cursor 原生支持根目录和子目录的 AGENTS.md。只有当你需要「按文件路径生效」这类结构化规则时才写 .cursor/rules,并且文件必须是 .mdc 扩展名、带 frontmatter——普通 .md 放进去会被规则系统静默忽略,没有任何报错。
Claude Code:一行 import,两个坑
项目根的 CLAUDE.md 里写一行即可:
@AGENTS.md或者用软链接:`ln -s AGENTS.md CLAUDE.md`。两个官方文档里写明的坑:
- @ 导入路径含空格要加反斜杠(@My\ Docs/a.md),被引号包裹的路径不会被导入;
- 存在 CLAUDE.local.md 时,Claude Code 默认不读 AGENTS.md——本地文件把开放标准文件「抢占」了。要么把个人偏好并进用户级 ~/.claude/CLAUDE.md,要么把项目指令来源设为 claude-md-and-agents-md。
Gemini CLI 与 Aider:改一下默认文件名
// .gemini/settings.json
{ "context": { "fileName": "AGENTS.md" } }
Aider 则在配置文件里写一行 read: AGENTS.md。各家接入方式汇总见下图:
一个要提前打好的预防针:Claude Code 官方文档明确说,@ 导入只是组织方式,不减少上下文开销。三层结构省的是「无关上下文被误加载」的隐性成本,不是 token 总量——入口写得越克制,这个差值越明显。
关键一步:让知识跟着代码更新,而不是写完就过期
分层只解决了「读得到」,还有一半难题是「不过期」。反面案例很典型:一条没有日期、没有结束条件的「保留 /v1/orders」注释,等旧版 App 早就退出支持范围了,Agent 每次清理照样跳过它——过期的约束比没有约束更误导。
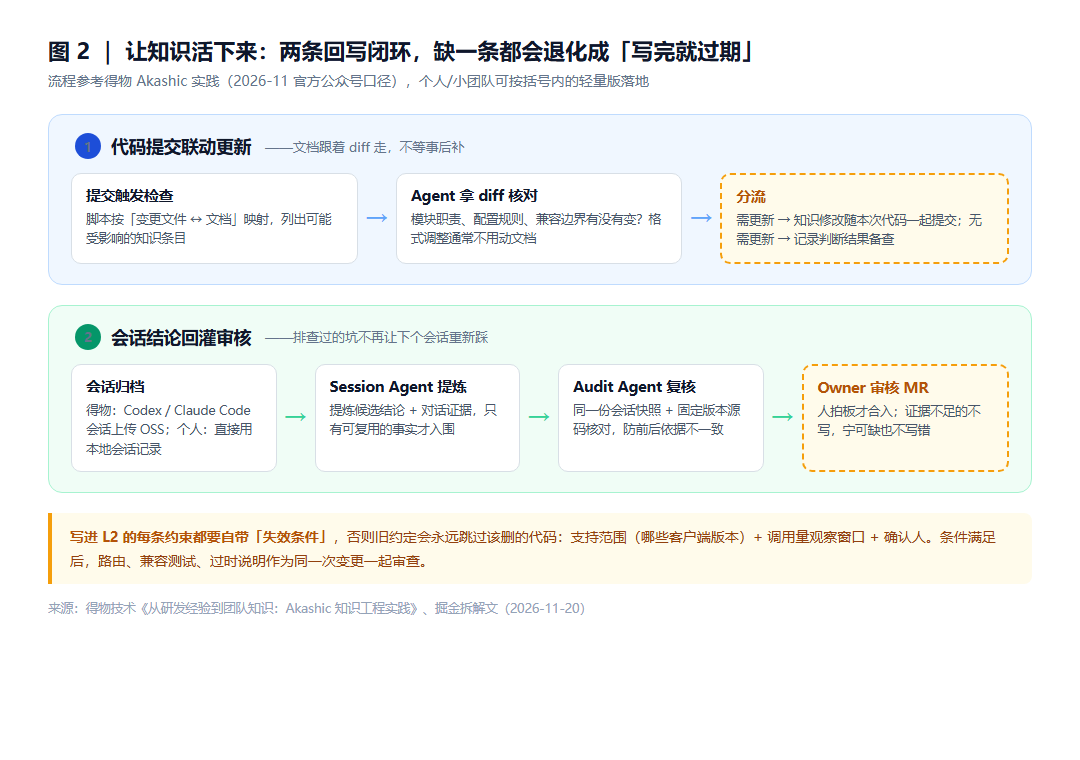
写进 L2 的每条约束都要自带失效条件:支持范围(哪些客户端版本)+ 调用量观察窗口 + 确认人。三个条件凑齐,路由、兼容测试、过时说明作为同一次变更一起审查下线。
更新怎么不靠人肉记?得物的做法是把检查挂进提交流程:脚本按「变更文件 ↔ 知识条目」的映射,列出本轮 diff 可能影响的文档,Agent 再核对模块职责、配置规则、兼容边界是否真的变了——要改就随本次代码一起提交,不用改也记录判断结果。小团队不需要这么重的基建:在 PR 模板里加一条「本次改动是否触及 docs/ 下的约定文档」,review 时多看一眼,就已经能拦住大半漂移。
会话里的结论,审核通过再写进仓库
代码变更检查有个盲区:很多排查结论根本不产生代码变更。比如确认了「旧版 App 的请求经过另一层网关,服务日志看不到全量」——没有提交,就不会触发文档同步,下个会话照样拿着不完整的日志下结论。
得物的 Akashic 从归档会话里回收这部分知识:Git 提交后自动扫描上传 Codex 和 Claude Code 的研发会话(近三天窗口内可形成新快照);Session Agent 读原始对话提炼候选结论和证据;Audit Agent 用同一份会话快照、固定版本的源码复核,防止前后依据不一致;最后以 MR 形式交 Owner 审核。Agent 权限被限定在读取、检索、编辑,外部交互全由程序完成,人只做最终拍板——没有可靠结论就不改知识库。
个人版两步就够:每次会话确认了可复用的事实,随手贴进仓库的 issue 或 PR 描述存档;每周挑一次,把存档里值得留下的结论整理成 L2 文档,自己过目后再 commit。原则不变:模型负责提炼,人负责拍板,没证据的不入库。
常见翻车报错与急救清单
| 症状 | 原因 | 解法 |
|---|---|---|
| Claude Code 完全不读 AGENTS.md | 工作目录或上层存在 CLAUDE.local.md,抢占默认行为 | 删除或改名 local 文件,或把项目指令来源设为 claude-md-and-agents-md |
| Cursor 规则怎么都不生效 | 普通 .md 放进了 .cursor/rules | 改用 .mdc 扩展名并写 frontmatter(alwaysApply / globs / description) |
| @AGENTS.md 没被导入 | 路径被引号包裹 | 去掉引号;路径含空格用反斜杠转义 |
| import 报层级过深 | 超过 4 跳嵌套上限 | 拍平目录结构,减少中间层 |
| 子目录 CLAUDE.md「没加载」 | 子目录记忆是懒加载 | 正常现象:Agent 读写该目录文件时才注入,启动时不加载 |
| /compact 之后约定丢失 | 压缩会清上下文 | 根目录 CLAUDE.md 会自动重读;子目录文件需重新触发读写 |
| AGENTS.md 越写越长,每个任务都变慢 | 把 L2 内容塞进了入口 | 入口只留路由和索引,细节下沉到模块文档 |
| 两个成员的会话结论互相矛盾 | 各存各的、依据版本不一致 | 统一归档,复核时锁定同一份快照和源码版本 |
边界:什么情况别上这套
适合上三层的:多人多工具混用、monorepo、AI 参与度高的仓库——重复解释的成本大于维护成本,才值得建结构。单人小项目劝退:一个 AGENTS.md 写清楚构建命令和规范就够了,为三五个文件建 knowledge/ 目录是过度工程。
两句诚实话:一,Akashic 是得物的内部实践,不是开源产品,CLI、OSS 归档那套基建没法直接装,能复用的是分层和回灌的思路;二,各工具的记忆机制迭代很快,本文口径以 2026 年 11 月官方文档为准,动手前建议再对一眼对应工具的最新文档。
总结成一句话:AGENTS.md 是给所有 Agent 共用的项目说明书,L1 只做路由、L2 管模块边界、L3 贴着代码走;再配上「提交联动检查 + 会话结论审核回灌」两条闭环,约定才不会写成一次性文档。
你的仓库现在养着几份 Agent 配置文件?换工具时最常被重新解释的是哪类约定——构建命令、兼容边界还是部署流程?评论区报一下你的工具组合,我把对应的接入命令贴给你。
登录后可点赞、收藏与反馈。


