AgentScope Durable 避坑实录:Java 企业 Agent 断线续跑的最小接入与 8 条急救
Maven Central 拉不到 agentscope-durable?官方教程代码照抄即翻车。本文直核版本口径,给出 LocalBackend 离线最小接入、submit/steer/respond 正确用法、工具中断五种恢复状态与 8 条急救清单。
先说结论:Java 企业 Agent 的断线续跑,AgentScope Durable 这条路是通的——但它现在还不在 Maven Central 里。全网讲 Agent 断点恢复的教程,十篇有九篇默认你写 Python、装 LangGraph 的 checkpoint;Java 企业开发者照抄,第一步就撞墙:连 io.agentscope:agentscope-durable 这个依赖都拉不下来,IDE 里 DurableRuntime 直接标红。
这条路我替你踩完了。本文基于 2026-11-20 阿里云云原生团队发布的 Durable 官方长文、java.agentscope.io 官方文档、GitHub 仓库与 Maven Central 逐项直核:JDK 17+ 的离线 Quickstart 三步跑通,任务跨重启保留进度,第二次启动不再调用模型直接取回原 Turn 结果。下面把最小接入、排队/插话/审批的正确姿势、工具中断的五种恢复状态一次讲清,文末附 8 条翻车急救清单。
版本口径先钉死:写稿时(2026-11-20)AgentScope Java 最新发布版是 v2.0.5(11 月 14 日发布,官方 release note 明确“无新增模块”),Central 上 agentscope-core 最高到 2.1.0-BETA1。Durable 代码在 main 分支的 agentscope-durable 模块里,尚未随任何 2.0.x 版本发布——这是后面所有坑的源头,先记住它。
为什么 LangGraph 的 checkpoint 教程救不了 Java 企业 Agent?
企业 Agent 的任务寿命,经常超过浏览器连接、HTTP 请求和执行实例的寿命:一个研发 Agent 定位故障、改代码、跑 20 分钟回归测试,审批可能第二天才来;中间用户关了页面、服务滚动发布、实例被平台替换。这些场景里“保存会话历史”救不了你——“已经决定运行测试”和“测试已经完成”是两个不同的事实,仅凭一条“正在测试”的消息,系统无法决定下一步该查询、等待还是重新执行。
LangGraph 的 checkpoint 解决的是 Python 进程内的状态快照与时间旅行,Java 企业应用要的是另一件事:任务身份、执行进度、等待条件全部存到进程之外,实例挂了由兼容的执行者接管。两者最容易混淆的点如下表:
| 对比项 | LangGraph checkpoint(Python 生态主流教程) | AgentScope Durable(Java 企业侧) |
|---|---|---|
| 恢复单位 | 图执行状态快照(graph state) | Turn(任务),Session→Thread→Turn 三级身份 |
| 检查点来源 | 框架在节点边界写入 checkpoint | HarnessAdapter 接入原生检查点,存入 SessionBackend |
| 长工具执行 | 多在进程内 await,实例挂则丢 | 工具交给 Hands 独立沙箱执行,executionId 持久保存,结果先落库再接回 |
| 多实例接管 | 官方方案不覆盖,需自建 | 租约到期 + 兼容实例认领 + Fencing 拦过期写入,RocketMQ 唤醒 |
| 审批/插话 | 需自行设计中断点 | steer 插话、pendingInteractions() 审批,均持久受理 |
三层抽象别混着看:ReActAgent、HarnessAgent、DurableRuntime 各管什么
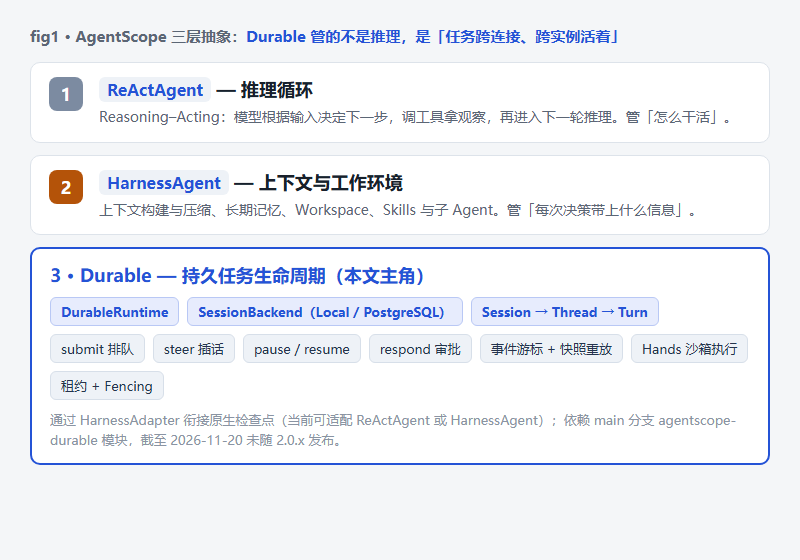
AgentScope 的三层各管一段:ReActAgent 管推理循环(怎么干活),HarnessAgent 管上下文与工作环境(每次决策带上什么信息),Durable 管任务在时间和实例之间的延续(输入怎么受理、任务怎么排队、谁能在哪恢复、等什么结果)。Durable 通过 HarnessAdapter 衔接原生检查点,当前可适配 ReActAgent 或 HarnessAgent,可以独立嵌入应用,不依赖托管平台服务。
内部职责一句话串起来:请求进来先由 DurableRuntime 落库受理,再安排 Agent 执行;遇到需要独立执行的工具,Runtime 通过 Executor 交给 Hands,结果回来后恢复原 Turn 让 Agent 消费。这些组件可以装在同一个 JVM,也可以按需拆分部署。
最小接入三步:LocalBackend 离线也能跑通,不花一分钱 API 费
最小接入需要三样东西:Agent 工厂、持久 Backend、Runtime。下面用官方示例的关键调用(应用自备 model),把第一次调查保存为一个 Turn:
var backend = LocalBackend.open(Path.of("./durable-data"));
var adapter = AgentScopeAdapter.forReAct(
        binding -> ReActAgent.builder()
                .name("dev-assistant")
                .model(model),
        Map.of());
var runtime = DurableRuntime.builder()
        .backend(backend)
        .harness("dev-assistant", "v1", adapter)
        .build();
var session = runtime.createSession(
        new SessionKey("demo", "incident-42"), "dev-assistant");
var investigation = session.submit(
        "investigate-1", "分析订单服务超时的原因");
runtime.start();
var turnId = investigation.turnId(); // 保存这个身份,重连全靠它三个要点:Session、Thread、Turn 身份要由应用自己保存;宿主保持 Runtime 运行,退出时依次关闭 Runtime 与 Backend;同一请求重试时沿用原 requestId 和原输入,就会拿到原来那个 Turn,不会创建新任务。完整离线 Quickstart 从仓库根目录跑:
bash agentscope-examples/durable/integrated/quickstart/run.sh它启动两个独立进程、复用同一请求身份:第二次启动直接取得原 Turn 的结果,不再调用模型——这是观察“任务跨重启保留”最直观的方式。默认离线模型不需要 API Key、数据库或 Node.js,JDK 17+ 和 Maven 就够。
关键一步:Maven Central 拉不到 agentscope-durable,照抄教程必翻车
上面代码里所有的 DurableRuntime、LocalBackend、AgentScopeAdapter,在已发布的 2.0.x 里都不存在。直核结果(2026-11-20):repo1.maven.org 的 io.agentscope 组下共 130 个构件,没有任何一个叫 durable;最新 release v2.0.5 的官方说明写明是维护版、“无新增模块”;官方 session-chat 示例博客也明确注明 DurableRuntime 实现未包含在已发布版本中。编译时的报错特征就是经典的:
Could not find artifact io.agentscope:agentscope-durable解法两条:其一,从 main 分支源码构建(仓库已含 agentscope-durable 模块和 durable-jdbc / durable-rocketmq / durable-sandbox / durable-http / durable-mcp / durable-objects 六个扩展,本地 mvn install 后引用);其二,等 2.1 正式版进 Central(目前只有 2.1.0-BETA1,且 Central 上同样没有 durable 构件)。版本迭代快,动手前先去 Central 搜一遍再决定构建方式,别硬背本文口径。
submit、steer、respond 别用混:排队、插话、审批三件事的正确姿势
用户在调查进行中说“结束后整理一份报告”是新任务,走 submit 排队;补充“先不要改生产配置”是对当前任务的调整,走 steer 插话;第二天到的审批走 respond 接回原任务。三者语义完全不同:
// 新工作:在主 Thread 中按受理顺序排队
var report = session.submit(
        "report-1", "根据调查结果整理一份故障报告");
// 插话:送入当前正在执行的调查,不创建新任务
investigation.steer(
        "constraint-1", "重点检查数据库访问,先不要修改生产配置");
// 排队的任务不要了:取消尚在排队的 Turn
report.cancel("cancel-report-1");两个容易翻车的细节:插话是先落库、再在原生执行的安全边界进入 Agent——已经发出的工具调用不会被撤回,正在生成的响应也不会被强行改写,应用要通过 signal.applied 等事件确认要求已生效;审批要用 pendingInteractions() 找到待处理审批,再调 respond(requestId, interactionId, approved) 回应,这样第二天到达的批准才能接到原操作上。
断线重连靠“游标 + 快照”,别拿原生日志当界面状态
用户测试跑到一半关了页面,第二天回来要看到原任务和进度。正确姿势是用保存的身份找回原 Session,只读不重发:
var session = runtime.getSession(
        new SessionKey("demo", "incident-42"));
var thread = session.getThread("main");
var investigation = thread.getTurn(savedTurnId);
var current = investigation.status();
var history = thread.history(null, 100);
// 从上次消费的游标继续读事件
var options = EventStreamOptions.builder()
        .after(savedCursor)
.build();官方文档有一句容易被忽略的警告:原生日志(Thread journal)和 JournalProjection 只用来读消息与执行事实,不承担 UI 恢复——恢复界面要用 Durable 的 snapshot()、history() 和事件 API;历史游标失效时用快照替换当前视图。会话重放重建的是用户看到的过程,不会重新调用模型或执行工具;浏览器断线、观察超时、关闭订阅,都不会隐式取消后台任务。
20 分钟的测试不用干等:五种中断状态对应五种恢复动作
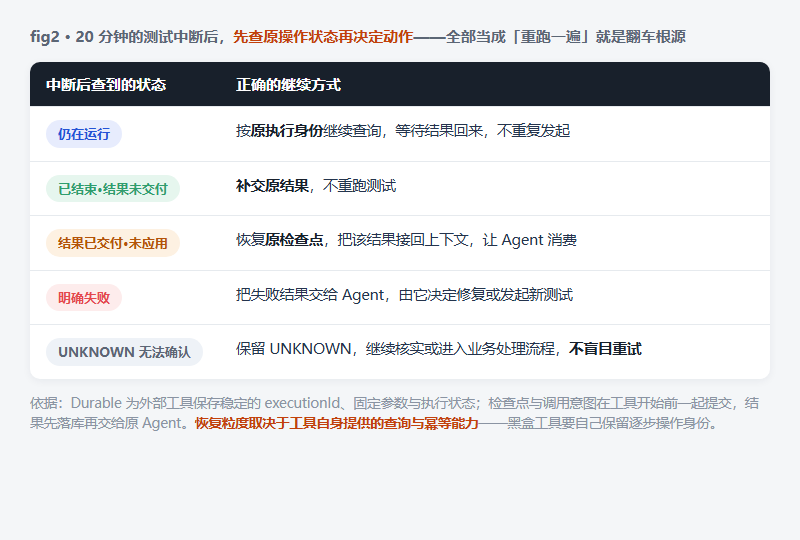
长耗时工具是 Durable 价值最大的地方。工具开始前,Agent 检查点与调用意图一起提交;Durable 为外部工具保存稳定的 executionId、固定参数和执行状态;工具结果返回后先落库,再交给原 Agent,与新检查点一起提交确认。所谓“精准恢复”,是找到原操作和缺失的交接步骤,而不是把一切处理成“再执行一遍”——重复副作用就是这么来的。
多实例部署再加三件套:PostgreSQL 共享 Backend 配 RocketMqWakeups 传递会话变更通知;实例 A 失联后租约到期,兼容的实例 B 认领未完成工作、加载检查点继续原 Turn;旧实例即使复活,过期执行权也会被 Fencing 拦住。注意 MQ 通知会延迟、重复甚至丢失,Runtime 会定期扫描过期租约兜底,通知不是恢复的唯一依据。
常见翻车报错与急救清单
以下 8 条覆盖从编译到生产最容易卡住的地方:
| # | 现象 / 报错特征 | 解法 |
|---|---|---|
| 1 | Could not find artifact io.agentscope:agentscope-durable,或 import DurableRuntime 编译报错 | 写稿时 2.0.x 不含 Durable:从 main 分支源码构建,或等 2.1 正式版;动手前先查 Central 确认最新口径 |
| 2 | 同一请求重试后出现两个 Turn、模型被调用两次 | 重试必须复用原 requestId + 原输入,才会返回原 Submission;新工作才用新 requestId |
| 3 | steer 发出去了,Agent 却“没听见” | 插话先落库,在原生安全边界才进入 Agent;订阅事件等 signal.applied 确认,已发出的工具调用不会被撤回 |
| 4 | WebFlux 应用里调 history / journal 读接口卡死 | 官方明确:原生查询与存储 SPI 是阻塞调用,WebFlux 必须调度到合适的 blocking worker,不能放在网络事件循环里 |
| 5 | 多实例升级后,旧实例看不到新队列消息 | v2.0.5 行为变更:文件消息布局改为 {id}.payload + {id}.ready;先升级所有消费侧实例再放行写入,或升级期间暂停队列 |
| 6 | 旧实例“复活”后覆盖了新实例的进度 | Fencing 只拦过期执行权:重启旧实例前确认其租约已到期或释放,别抢在接管完成前拉起旧进程 |
| 7 | 把恢复当成“恰好执行一次”,邮件重复发送 | Durable 不承诺业务动作恰好一次:邮件已发、回执丢失要靠工具自身的查询与幂等能力核实;黑盒工具自己保存逐步操作身份 |
| 8 | 升级后带 namespace 的调用读不到 MEMORY.md | v2.0.5 起 namespace 调用不再回退读根目录,把记忆文件迁进对应 namespace 目录 |
诚实边界:这三类场景别急着上 Durable
第一,分钟级内完成、无审批等待的短任务:直接 agent.call / streamEvents 就够,为它引入持久化 Backend 和事件游标是纯负担。第二,不打算碰源码构建的团队:写稿时必须从 main 分支构建,等 2.1 正式版进 Central 再上车更稳;只想快速体验的,离线 Quickstart 跑通再评估。第三,工具不提供查询与幂等能力、又不愿意改造的:Durable 保存的是身份与状态,不会替你把“发邮件”变成恰好一次;本地 Sandbox 示例还是用宿主权限执行命令,生产必须另配隔离环境。另外跨主机接管需要共享存储、兼容的 Agent 定义、工具绑定和原工作区访问权限,少一样都会卡在恢复链路上。
如果你的 Agent 已经被“重启丢进度”折磨过,评论区报一下配置:卡在重启、断线还是审批等待哪一步?用的是 LocalBackend 还是 PostgreSQL?贴上报错和版本号,我帮你顺着恢复链路排查。
登录后可点赞、收藏与反馈。


