AI 翻译 PDF 文档:公式、表格和版式怎么保住
翻译一篇 PDF 论文,最麻烦的不是语言,是公式被打散、表格错位、双栏变乱码。这篇讲清三类 PDF 的处理策略和五个检查点。
把一篇英文论文丢进翻译工具,几秒钟后得到一份中文文档。看起来很方便,但打开之后常见的问题是:公式变成了乱码,表格少了半列,双栏排版被拼成一句话。
翻译本身已经足够好,真正的成本在版式还原和信息结构。
先判断它是什么类型的 PDF
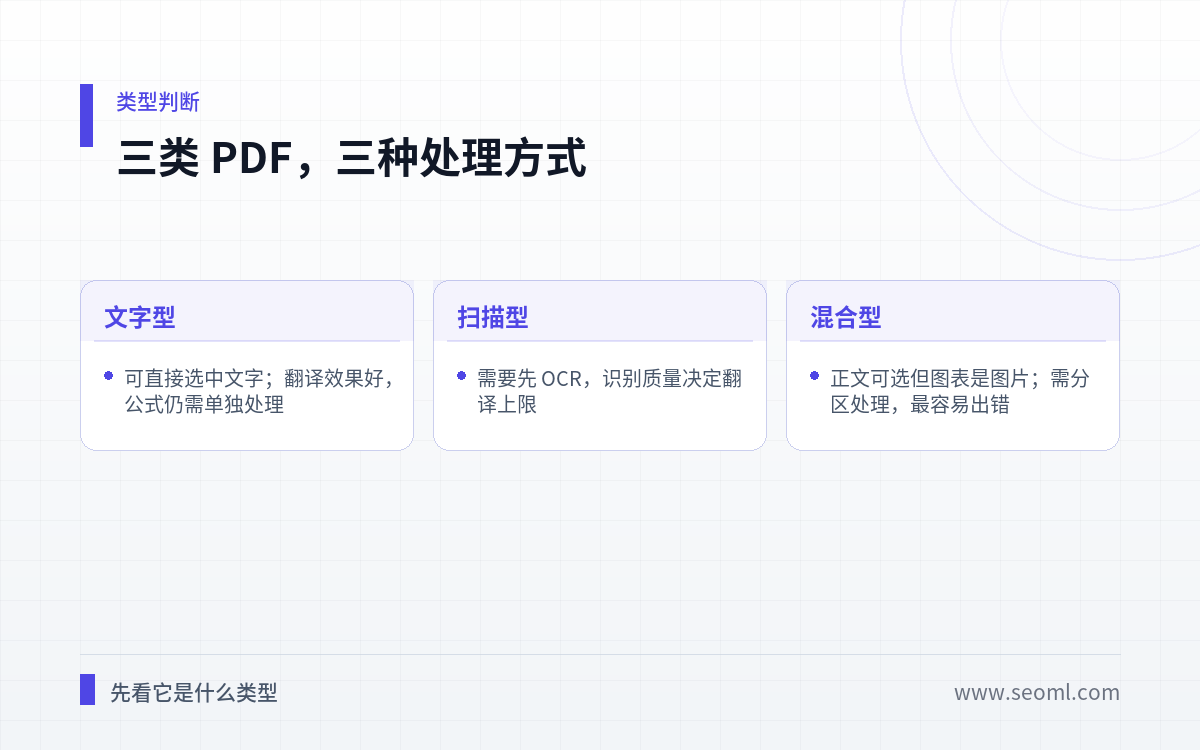
文字型 PDF 最省事,文字可选、结构清晰,翻译工具能保留段落和标题层级。这类文档的主要问题是公式和内嵌符号。
扫描型 PDF 需要先做 OCR。识别质量直接决定翻译上限——错一个字,整句意思可能反转。学术扫描件尤其要注意上下标和希腊字母。
混合型最麻烦:正文可选中,但图表是图片。这类文档必须分区处理,正文走翻译流程,图表单独截图重排。
四类元素要单独检查
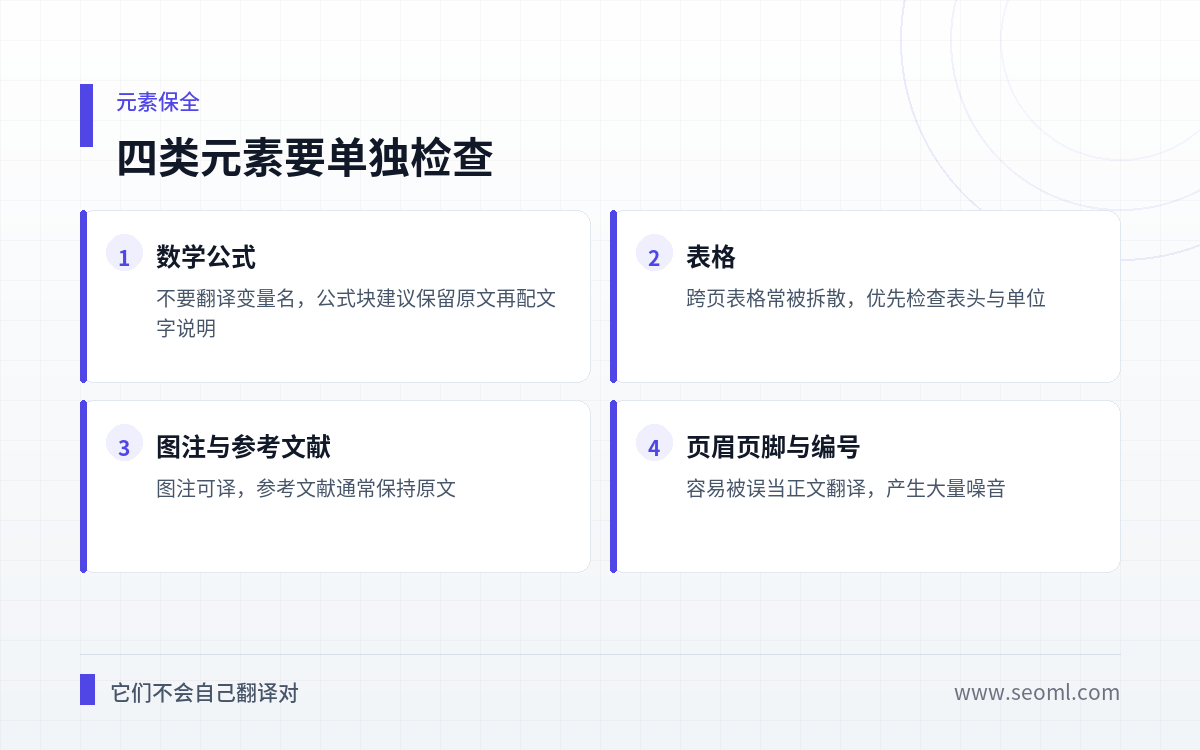
数学公式是第一位的。变量名不应该被翻译,公式块建议保留原文,在下方加一句中文说明。很多工具会把 x 和 × 混掉,把上标当地址。
表格是第二位的。跨页表格经常被拆散,表头和单位错位。译后第一件事是核对行列数。
图注与参考文献是第三位的。图注可以译,参考文献通常保持原文,否则无法检索。
页眉页脚与页码是第四位的。它们最容易被误当正文翻译,产生大量重复噪音。
译后必查的五个位置
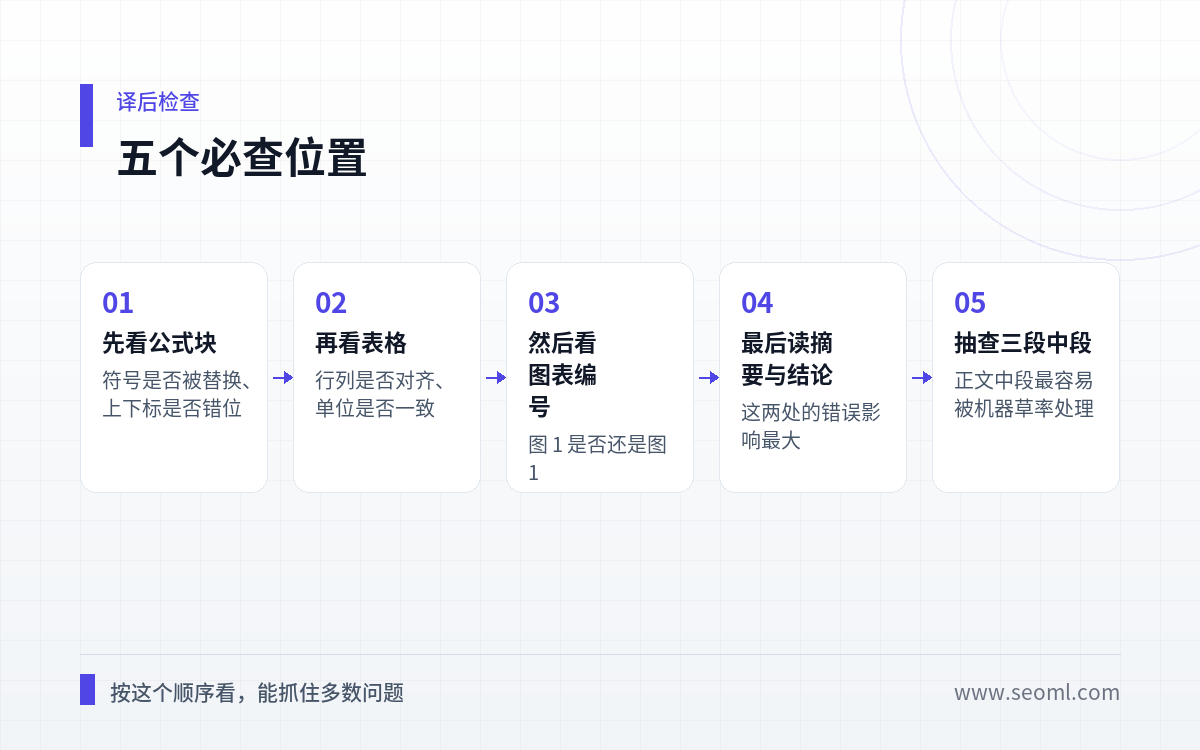
先看公式块,检查符号是否被替换、上下标是否错位。
再看表格,检查行列是否对齐、单位是否一致。这一步能抓住大部分结构性错误。
然后看图表编号。图 1 是否还是图 1,引用是否同步。
最后读摘要与结论。这两处的错误影响最大,因为多数读者只读这两段。
再抽查三段中段正文。中段最容易被草率处理,长句被压缩、逻辑连接词丢失都发生在那里。
常见问题
有能保留公式的工具吗? 部分工具支持公式块保留,但需要手动确认。全自动方案目前仍不可靠。
扫描件效果差怎么办? 先提高 OCR 质量:调分辨率、去噪、纠正倾斜。这一步的收益远大于换翻译工具。
整本译还是只译需要的章节? 建议按章节译。全书翻译的返工成本高,且多数人只需要其中两三章。
术语前后不一致怎么办? 建一个术语表,先译术语,再译正文。这是专业翻译的标准做法。
一句话判断: 把 PDF 翻译当成一次排版工程,而不是一次语言转换——预期对了,返工就少。
登录后可点赞、收藏与反馈。