AIGC 检测是怎么回事:原理、误差与应对
被判为「AI 生成」的文本,可能完全是人写的。这篇讲清检测工具到底在算什么,误判率有多高,以及被误判时该怎么处理。
「AI 检测」这个名字容易造成误解,它并不鉴定真伪,更像是在算一段文字有多「规整」。规整到某种程度,就被判定为机器生成。
理解这一点很关键:被判为 AI 生成,不等于你用了 AI;被判定为人工,也不等于你没用。
检测在算什么
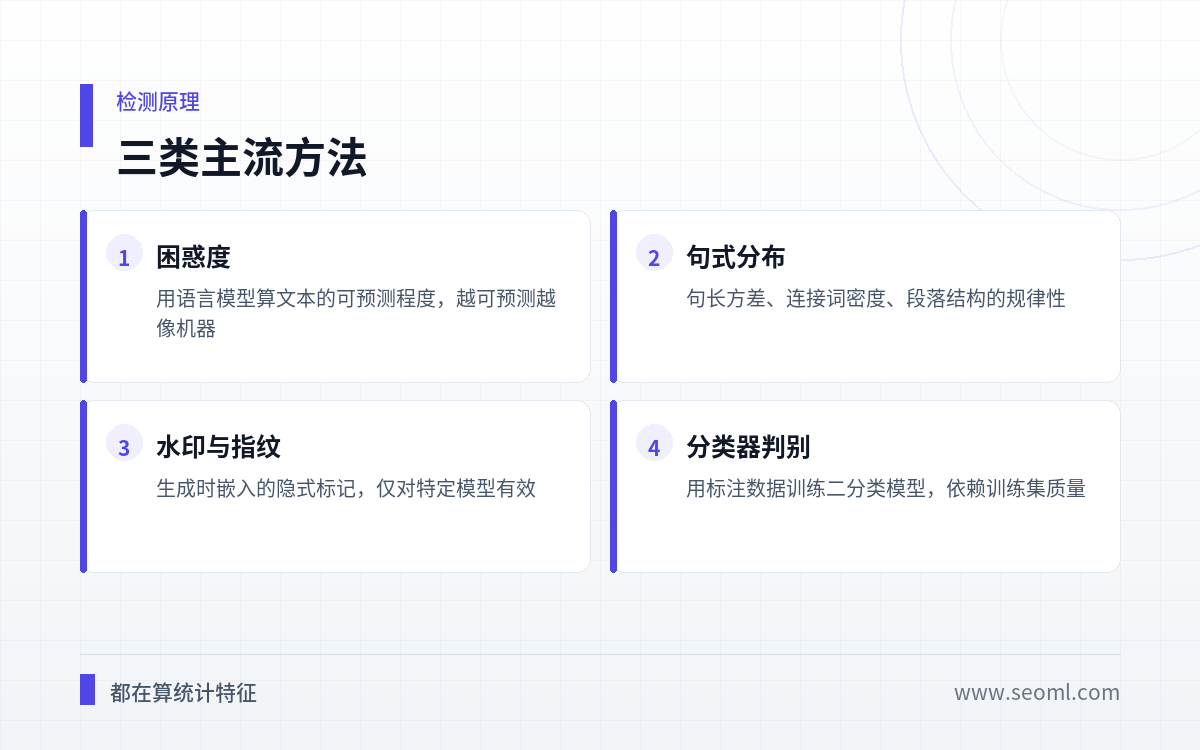
第一类是困惑度。用语言模型计算文本的可预测程度,每个词越容易被预测,困惑度越低,越像机器写的。这套方法对模板化文本极不友好。
第二类是句式分布。句长方差小、连接词密度高、段落总是「总-分-总」,这些都是机器文本的统计特征。
第三类是水印与指纹。部分模型在生成时嵌入隐式标记,这类检测只对特定模型有效,换个模型就失效。
第四类是分类器判别。用人工标注的样本训练二分类模型,效果高度依赖训练集,跨领域时准确率下降明显。
哪些文本容易被误判
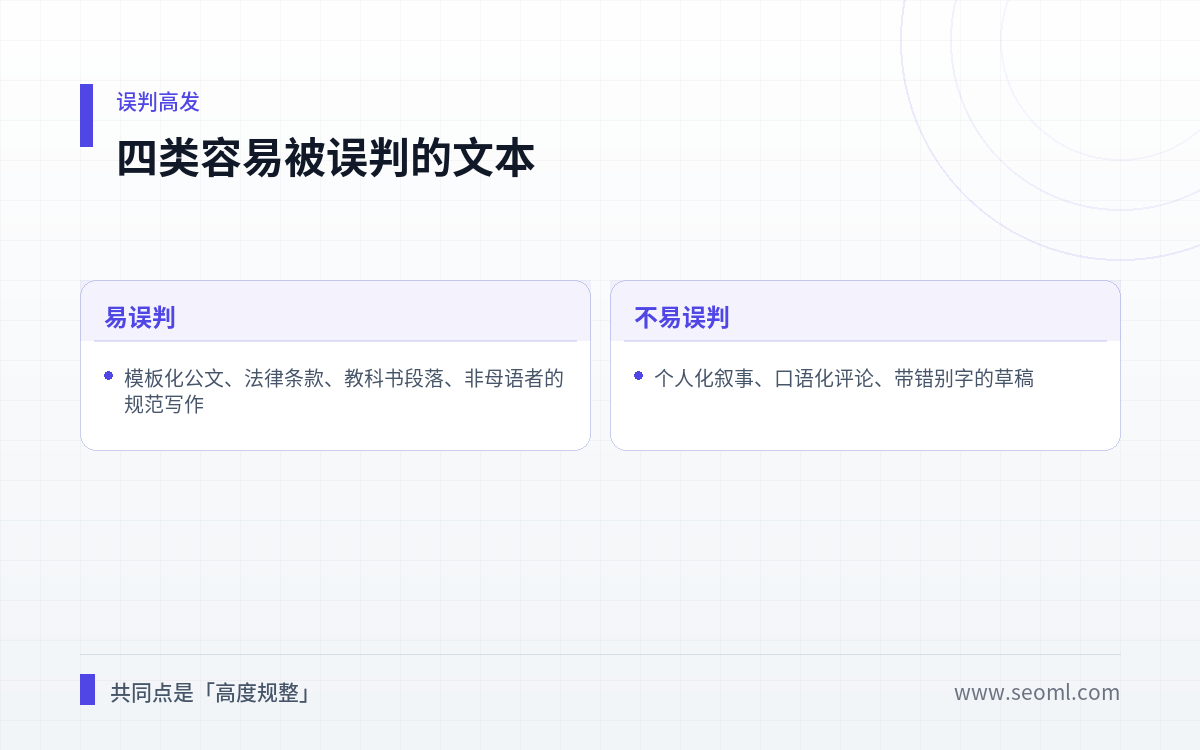
第一类是模板化公文。格式固定、句式统一,统计特征和机器文本高度重合。
第二类是法律条款与合同。为了消除歧义,这类文本刻意追求规整,恰好命中检测的判定逻辑。
第三类是教科书段落。定义、分类、举例,结构高度标准化。
第四类是非母语者的规范写作。写作者刻意避免口语化、句式完整、连接词齐全,这些在检测看来都是机器痕迹。
反过来,个人化叙事、口语化评论、带错别字的草稿反而不容易被误判,因为它们「不规整」。
被误判了怎么办
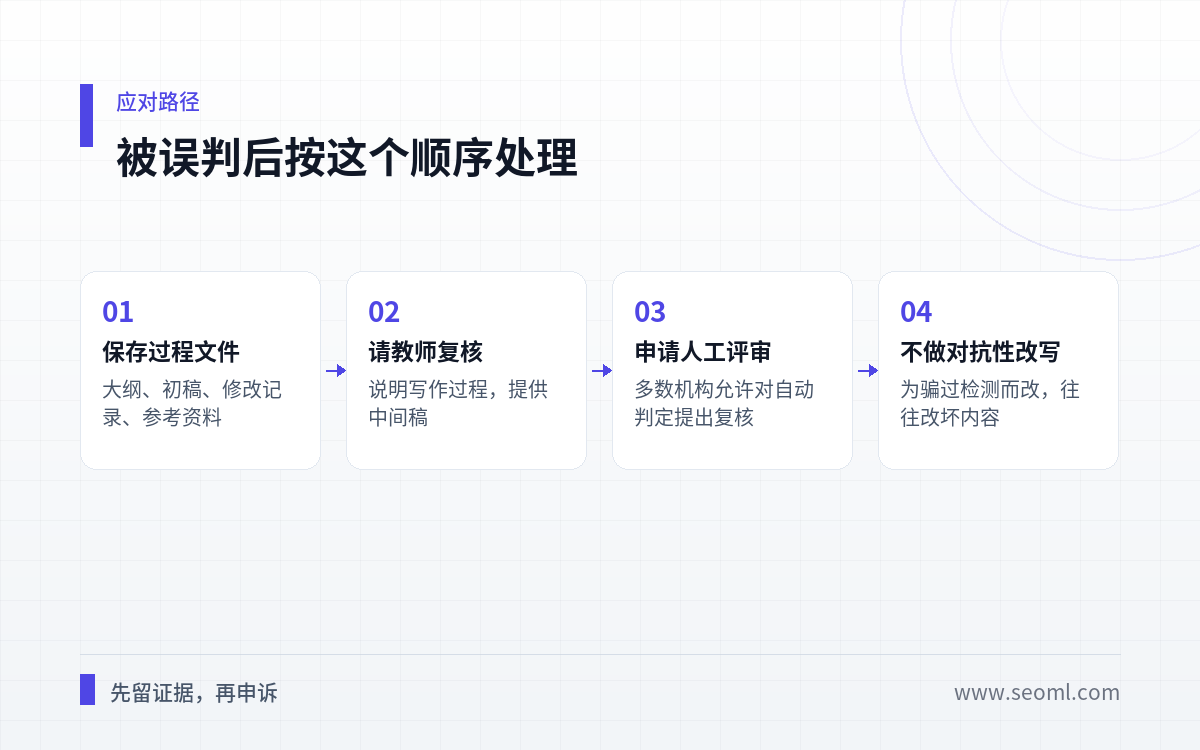
第一步,保存过程文件。大纲、初稿、修改记录、参考资料,这些是证明写作过程最有效的材料。
第二步,请教师复核。说明你的写作过程,提供中间稿。多数老师愿意看过程,而不是只看一个分数。
第三步,申请人工评审。多数机构允许对自动判定提出复核,这是制度内的正规路径。
第四步,不要做对抗性改写。为了骗过检测而刻意加入口语、错别字、不规则句式,往往把内容改坏,得不偿失。
常见问题
检测准确率有多高? 公开研究差异很大,短文本误判率更高。把它当参考信号,不当判决。
中文检测比英文差吗? 通常更差。中文语料复杂、训练数据参差,误判率相对更高。
自己写的会不会被判? 会,尤其是上面那四类文本。这就是为什么过程材料很重要。
降 AI 率有用吗? 部分有效,但本质上是在对抗统计特征,容易把文本改得不自然。
一句话判断: 检测工具测的是「像不像机器」,你要证明的是「这是我写的」——后者靠过程材料,不靠改写。
登录后可点赞、收藏与反馈。