RX 7900 XTX 跑 125B:Linger 不认 A 卡,引擎这五关怎么过才不踩坑
Linger 的 125B 默认只给 N 卡和苹果芯片,A 卡得走 PolyStrata 引擎:gfx 白名单、ROCm 版本、64GB 内存与 150GB 磁盘、AVX2、70GB 下载,五关都要过。附国内源与 9 条报错对照。
11 月 19 日 Linger 开源,转述里最抓眼的一句是:12GB 显卡跑 125B,45.5 tokens/s。A 卡用户照着去下安装包,会在硬件要求那一栏停住——写的是「Apple 芯片,或 8GB 以上显存的 NVIDIA 显卡」,AMD 一个字都没提。
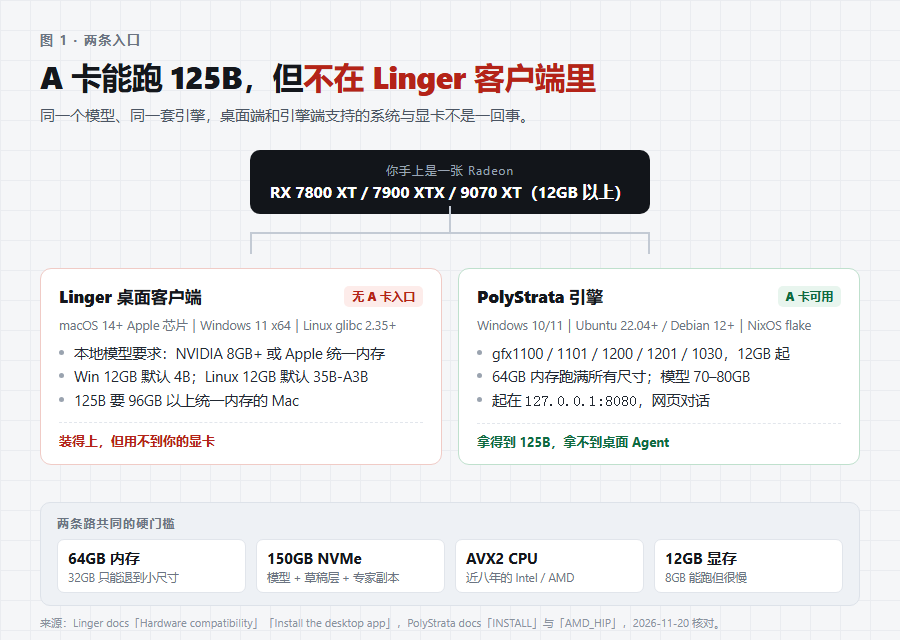
那个 45.5 也不是随便一台 12GB 机器能复现。README 把 45.5 写在 12GB RTX 3060 那一格,同一段给的前提是 64GB 内存;同一份分档表里,12GB 显卡配 32GB 内存是 21.3 tokens/s,62K 提示词之后首字约 3 分钟。更反常识的是默认档:Windows 上 8GB 和 12GB 显卡的自动方案是 4B 的 Spark(Spark-X2.6-4B),Linux 12GB 是 35B-A3B,默认路径里根本走不到 125B。
先把范围划清:客户端接 Claude Code、Codex 订阅或 BYOK 都能用,卡住的只有「在本机跑 125B」这一件事。引擎这边认 A 卡——Linger 用的 PolyStrata 单独开源,AMD 白名单按 gfx 架构列了五个主力架构,Windows 10/11 都能跑,模型还能从 ModelScope 拉。代价要先说清:你拿到的是同一个 125B 的本地推理和一个 8080 端口的网页,拿不到 Linger 那套会点桌面、会写 Wiki 的 Agent。下面按五关拆,末尾给报错对照表。
先把「12GB 跑 125B」的条件摆全
Linger 的硬件兼容页写得很直:本地模型只跑在 Apple 芯片的 Mac,或 Windows / Linux 上的 NVIDIA 显卡。下面这张表是它给出的默认方案,注意「默认」两个字——Windows 和 Linux 的默认档里根本没有 125B,只有 96GB 以上的 Mac 会自动选它。
| 平台与显存 / 统一内存 | 默认模型 | 共享上下文 |
|---|---|---|
| Windows 8GB | Spark-X2.6-4B Q8_0 | 64K |
| Windows 12GB | Spark-X2.6-4B Q8_0 | 200,000 tokens |
| Linux 8GB(32GB 内存) | Qwen3.6-35B-A3B UD-Q3_K_M | 64K |
| Linux 12GB(32GB 内存) | Qwen3.6-35B-A3B UD-Q4_K_M | 64K |
| Windows / Linux 16GB | Qwen3.8-27B UD-IQ3_S | 64K |
| Windows / Linux 24GB | Qwen3.8-27B UD-Q4_K_M | 128K |
| Windows / Linux 32GB 以上 | Qwen3.8-27B UD-Q4_K_M | 200,000 tokens |
| Mac 16GB | Spark-X2.6-4B Q4_K_M | 64K |
| Mac 24GB | Qwen3.8-27B UD-IQ3_S | 64K |
| Mac 32–64GB | Qwen3.8-27B UD-Q4_K_M | 128K–200,000 |
| Mac 96GB 以上 | Qwen3.8-Flash-Next | 200,000 tokens |
表里 8–16GB 那几行,官方假设的是 32GB 内存、其中 28GB 可用。同一页还写了两句要紧的话:这些是模拟档位,没有新的速度实测,也没有真机验收结果;8GB 和 12GB 的 Windows 真机验收还在等,Spark 的目录状态仍是 candidate(候选状态)。所以 Windows 12GB 用户装完看到 4B,不是你设置错了。
125B 要手动选,而且要 64GB 内存。README 那句 45.5 对应的是 RTX 3060 12GB + 64GB 内存;分档表里「Linux 12GB + 32GB」这一行是 21.3 tokens/s(19.8–25.4),62K 提示词后 34.1,首字约 3 分钟,还被标注「不是这台机器的默认推荐」。三个数字放在一起,才是这条新闻的完整版本。
还有个容易忽略的细节:Windows 12GB 卡的默认 200,000-token 方案,估算需要 9.94 GiB 空闲显存;64K 方案只要 7.36 GiB。桌面、浏览器、游戏先占一点,安装向导就会判定装不下,于是给你换成更小的档。装之前先把显存腾干净。
第一关:A 卡不在客户端里,引擎有白名单
PolyStrata 的 AMD 支持按 gfx 架构列,不按商品名。这个区别很重要:同一个「RX 7800 XT」的名字,换一代就是另一个架构号,而 ROCm 的 wheel、编译目标、加速表全按架构走。
| gfx 架构 | 对应显卡 | 验证状态 |
|---|---|---|
gfx1100 | RX 7900 XT / 7900 XTX | 官方验证 |
gfx1201 | RX 9070 / 9070 XT / Radeon AI PRO R9700 | 官方验证 |
gfx1101 | RX 7800 XT / 7700 XT | 卡主验证 |
gfx1200 | RX 9060 XT | 卡主验证 |
gfx1030 | RX 6800 / 6900 系列 | 社区报告,未官方验证 |
gfx1151 | Ryzen AI Max(Strix Halo) | 仅 Linux 源码构建 |
| 其他核显 | 780M / 760M 只有 Linux 的 opt-in 构建 | 默认不支持 |
跑 125B 要 12GB 显存起,8GB 能跑但官方自己标了「慢」。核显不在名单里,这一点最容易白忙一晚:笔记本上那颗 Radeon 780M 再新,也不是这张表里的卡;只有 Ryzen AI Max 这类统一内存的 APU 例外,而且要在 Linux 上从源码构建。
买卡前先查 gfx 号,不要查商品名。Windows 上先跑一次 START-HERE.bat --check 让它自己判断;Linux 上 rocminfo 第一段就写着。查不到架构号的,基本可以当作不在名单里。
第二关:驱动与 ROCm,Windows 和 Linux 是两套剧本
Windows 这边省事:装最新的 Adrenalin 驱动就行,引擎有预编译的 HIP 版本,不要求你单独装 ROCm。真正会坑人的是「驱动自带一份 amdhip64_7.dll」这种情况——它会顶掉引擎捆绑的库,第一次提问就崩,日志里通常是一句 hipErrorInvalidDeviceFunction。
Linux 更简单也更麻烦。内核的 amdgpu 驱动就够,不需要预装 ROCm;setup.sh 会把 ROCm 7 装进项目的 .venv,约 10GB,不需要 sudo,然后为本机架构编译引擎,10–20 分钟,一次性。前提是有 build-essential 和 git。
版本要按架构对:gfx110X 用 7.10.0a20251120,gfx103X 从 7.13 起,gfx1151 用 7.14。setup 会自己挑,挑错了可以用 STRATA_ROCM_VERSION 覆盖。机器上同时插了 N 卡和 A 卡时,它默认选 N 卡;要用 A 卡必须 --backend hip,漏了这一步,日志里会出现 N 卡的名字。
第三关:真正卡人的是内存和磁盘
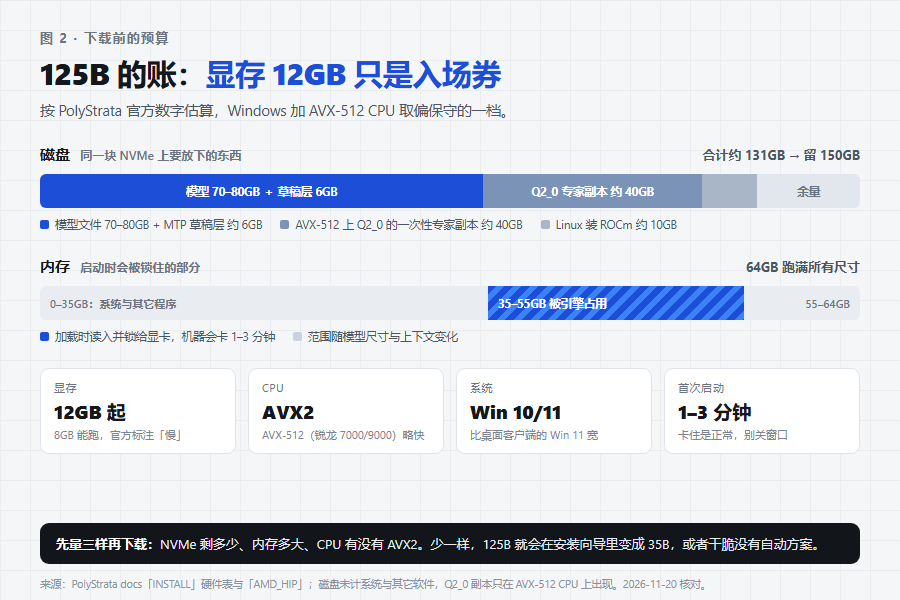
官方口径很干脆:64GB 内存跑满所有尺寸。启动那一刻,引擎会把 35–55GB 读进内存,并锁住一部分给显卡;这段时间机器可能卡 1–3 分钟,第一次最久。不是死机,别关窗口,窗口里会写它正在做什么。
32GB 不是不能跑:官方在「12GB 显存 + 32GB 内存」这一档给的是 21.3 tokens/s、首字约 3 分钟。能出字,但每一轮都要等,长上下文更明显。要更稳,就退到 27B 或 35B,或者用「大显存 + 小内存」的低内存模式。
磁盘比内存更容易被低估:模型文件 70–80GB,MTP 草稿层约 6GB,AVX-512 的 CPU 上 Q2_0 还会一次性写一份约 40GB 的专家副本,Linux 装 ROCm 再占 10GB。合起来 130GB 上下,留 150GB 的 NVMe 才稳;官方也写了「强烈建议 NVMe」,SATA 固态会让首次启动明显变慢。
第四关:系统和 CPU 的门槛比客户端低
客户端只写 Windows 11;引擎写 Windows 10/11,Linux 支持 Ubuntu 22.04/24.04 和 Debian 12/13,NixOS 还有 flake,一条 nix develop -c ./setup.sh 就能进环境。手上是 Win10 的,这一关反而过得比客户端容易。
CPU 要 x86-64 且支持 AVX2,大致是近八年的 Intel / AMD 桌面 U;AVX-512(锐龙 7000/9000)会快一点。没有 AVX2 的老平台(Sandy Bridge、Xeon E5 v1/v2、推土机)有一条实验性路径,但要在本机编译,官方自己标了「慢」。这类机器别折腾 125B,跑个 4B 或 27B 更实际。
第五关:70GB 怎么下下来(国内最容易卡在这)
默认从 Hugging Face 拉。官方支持两个国内出口:设 HF_ENDPOINT 走镜像,或者直接 --source modelscope。文档里记录过一次国内实测:11–14 MB/s,Q2_0 与 IQ3_S 的 SHA-256 与发布值一致(2026-10-05)。
:: Windows
set HF_ENDPOINT=https://hf-mirror.com
START-HERE.bat --source modelscope --model Q2_0 --context 32768

:: Linux
export HF_ENDPOINT=https://hf-mirror.com
./setup.sh --source modelscope --model Q2_0 --context 32768
下载可以中断续传,不用一次挂完。手上已经有 GGUF 的,用 --gguf-dir 指过去,先跑 --inspect 看清它到底是多少 bit、是不是引擎认的架构——名字最会骗人:UD-IQ3_XXS 的实际专家位宽是 3.22 bit,UD-Q4_K_XL 是 5.10,Q2_0 是 2.25。
ModelScope 提供的是仓库当前文件、不是固定 revision,所以它按发布的 SHA-256 逐个校验,MTP 张量再按固定 checkpoint 的哈希校验。这点官方写明了,别以为换国内源就不校验。
装完怎么起、怎么验、怎么给局域网用
- Windows:解压后双击
START-HERE.bat,问题一路回车走推荐值。下载完它会直接起模型,并打开http://127.0.0.1:8080。 - Linux:跑
./setup.sh;之后./run-<model>.sh直接启动,不再问问题。 - 先体检:
START-HERE.bat --check只检查这台机器,不改任何东西。核显、AVX2、显存这几项会在这里现形。 - 端口被占:加
--port 8081。要给局域网用:--host 0.0.0.0 --api-key <secret>,并且只在自己信得过的网段开。 - 边玩游戏边跑:
--vram-reserve-mib 2048(Linux 用./setup.sh --vram-reserve-mib 2048),给桌面和游戏留出显存。 - 验速度别拿 prefill 冒充:问一个 300 字左右的问题,看窗口里的 decode 数字,首字自己掐表。官方那句 45.5 说的是 decode,不是首字。
A 卡和 N 卡的五条实际差异
| 项目 | NVIDIA | AMD |
|---|---|---|
| 图片理解 | 走 GPU | 走 CPU,8 核约 3 秒一张(300 image tokens) |
--calibrate | 支持 | 不支持 |
| Unsloth 4bit 模型 | 支持 | 不支持,改用 IQ2_XS / IQ3_XXS / Q2_0 |
| gfx1030 的提示词 | — | 没有 hipBLASLt,回落 hipBLAS,提示词慢、答案一致 |
| 多卡 | --gpus | --gpus,但单卡放得下就别拆 |
有一条真机数字可以参照:官方 AMD 文档里,一位用户在 RX 9070 XT 上(Windows 11,ROCm 10.2 装进 .venv,本机编译)跑 Coder IQ1_M、32K 上下文,decode 29.2 tokens/s,prefill 约 181 tokens/s。注意这是 Coder 的小量化,不是 125B 的 2-bit 文件。125B 在 A 卡上没有官方公开数字——谁给你一个精确到小数点后一位的 A 卡 125B 速度,基本可以不信。
常见翻车报错与急救清单
| 现象 | 原因 | 处理 |
|---|---|---|
hipErrorInvalidDeviceFunction,或第一次提问就 access violation | AMD 驱动自带的 amdhip64_7.dll 顶掉了引擎捆绑的库 | 先看引擎日志里加载的是哪个 runtime,再用匹配的驱动/引擎版本重装 |
gfx1201 上做完 BF16/FP16 矩阵乘后报 hipErrorInvalidValue | hipBLAS 返回成功但留下 stale error | 升级到含修复的引擎版本;这是已知问题,不是你的参数写错 |
Linux 桌面突然退出(KWin / plasmashell 被杀),或报 Failed to pin framebuffer with error -12 | A 卡同时驱动桌面,专家缓存吃满显存,GTT 超卖触发 OOM | ./setup.sh --vram-reserve-mib 3072,牺牲约 2.3GB 专家缓存换稳定 |
启动报 no VRAM is left for the expert cache | 预留之后缓存太小 | 用 8K 上下文,安装时加 --draft-vocab en |
| 首次启动卡 1–3 分钟,硬盘灯长亮 | 正在把 35–55GB 读进内存并锁定 | 等。之后启动 30–90 秒;别关窗口,关了要重来 |
| 用任务计划开机自启后慢 24 倍 | 少了两个任务计划设置 | 按官方 DETAILS 里的两个设置改,别用默认 |
| 下载到一半断,或只有几百 KB/s | 直连 Hugging Face | --source modelscope 或 HF_ENDPOINT=https://hf-mirror.com,支持续传 |
| 提示显卡不支持,或干脆没有自动方案 | 核显,或不在 gfx 白名单 | 换卡;780M/760M 只有 Linux opt-in;Strix Halo 走源码构建 |
| 老 CPU 上启动失败或极慢 | 没有 AVX2 | 官方实验性路径要本机编译,不建议在这类机器上跑 125B |
谁该走这条路,谁别走
该走:手上有 RX 7800 XT / 7900 XT / 7900 XTX / 9070 XT / 6800 XT 这类 12GB 以上的卡,内存 64GB,NVMe 能腾出 150GB,要的只是本地大模型推理和一个网页对话。这条路的性价比确实高:不用为 125B 换一张 N 卡。
别走:你要的是 Linger 的桌面操作、Wiki 记忆、主动提醒——这些只在客户端里,而客户端只认 N 卡和 Apple 芯片;只有 32GB 内存还想上 125B;用核显或没有 AVX2 的老机器;要多人并发或对外提供服务。最后一种还要看许可证:Linger 是修改版 Apache 2.0,企业内部使用和自家应用后端可以,对外提供托管服务要书面授权,前端的 LOGO 和版权信息不能改。
还有一个安全边界得说清楚。引擎这条路不碰你的桌面,风险面比客户端小;客户端那套 Agent 是「以你的权限行动」,官方安全文档写的是权限审查「能减少错误,但不是沙箱」。两件事别混着算。
你手上是哪张 A 卡、gfx 号是多少、卡在哪一行日志?把型号和报错原文丢评论区,我按上面这张表帮你对。跑通了也欢迎报一个 decode 数字——A 卡跑 125B 的真实速度,现在全网都缺。
登录后可点赞、收藏与反馈。


