AnythingLLM 离线部署:内网机器跑知识库的三个前提
AnythingLLM 把文档问答做成了一个安装即用的产品:桌面端双击就能建知识库,服务端用容器部署。10 月 26 日的 v1.19.0 让 Docker 版也内置了本地模型,离线场景少了一层依赖。
AnythingLLM 是少数把「文档问答」做成完整产品的开源项目:上传文件、自动切分、建向量索引、对话时引用原文,全在界面里完成。它不需要你懂 RAG 的原理,但要顺利跑起来,有三个前提绕不过去。
它做什么
把一组文档变成一个可以提问的知识库。支持 PDF、Word、Markdown、网页、代码文件等格式,切片后写入向量库,提问时先检索相关片段,再交给模型组织答案。
它支持两种部署:桌面端(双击安装,数据全在本机)和服务端(Docker,多人共用)。多工作区设计让不同知识域可以隔离。
最近更新了什么
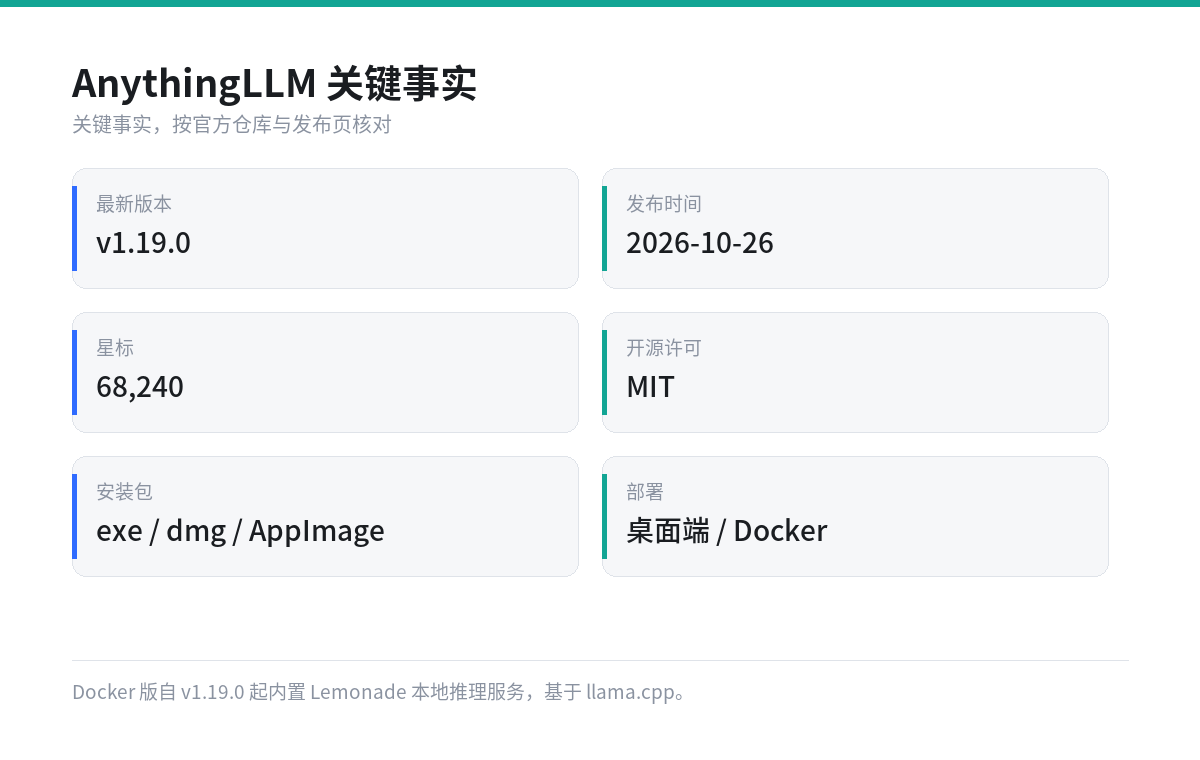
2026 年 10 月 26 日的 v1.19.0 有一个实质性变化:Docker 版开始内置本地模型。
具体做法是把 AMD 开源的 Lemonade 推理服务打包进容器,底层仍是 llama.cpp。这意味着以前必须外接 Ollama 或 OpenAI 的容器部署,现在开箱就有一个可用的本地模型。对纯离线环境,这少了一层依赖。
三个前提
第一,嵌入模型要能本地跑。 检索质量取决于嵌入模型,很多人只配了对话模型,嵌入仍走云端,断网后知识库直接失效。这一点在离线部署里最容易漏。
第二,硬件要够。 桌面端跑 7B 级模型,16GB 内存是底线;要跑 14B 以上,显存比内存更重要。
第三,文档要预处理。 扫描版 PDF 没有文字层,直接上传只会得到空白索引。先做 OCR,再入库。
部署步骤
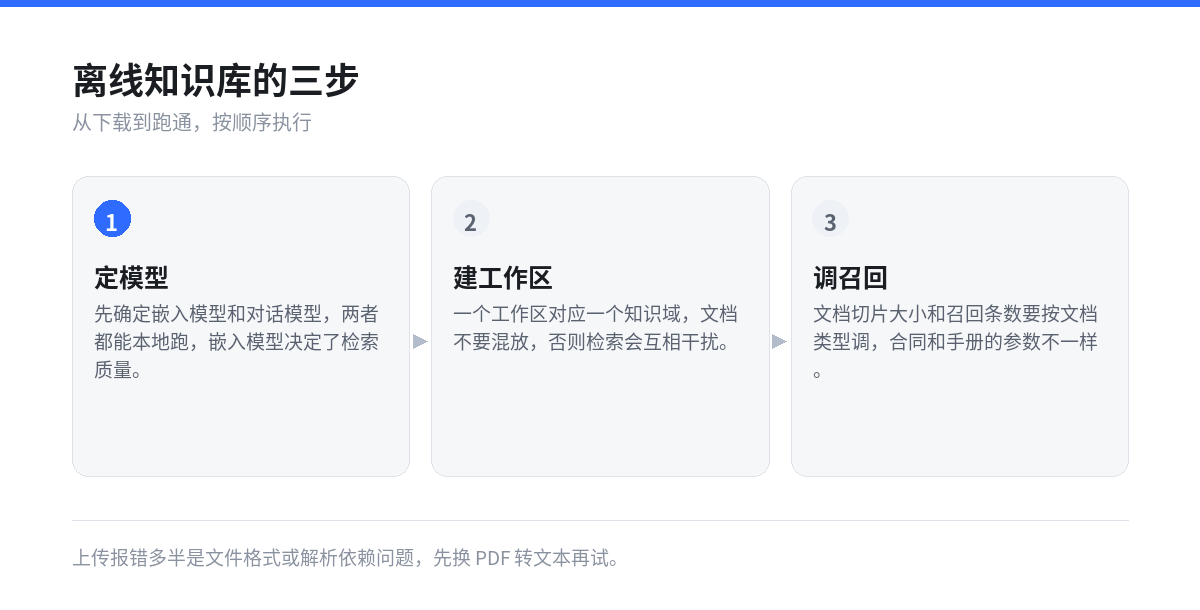
桌面端最省事:装完选一个模型来源,建工作区,拖文件进去。服务端要准备持久化目录,容器重启后数据不能丢。
三个常见故障
上传文档报错。 多半是格式或解析依赖问题。把 PDF 先转成文本再传,能绕开大部分解析器 bug。
回答里没有引用。 检查召回条数是否过低,或者切片太大导致相关内容被截断。
中文检索效果差。 换中文语料训练过的嵌入模型,英文嵌入模型在中文文档上召回率明显偏低。
常见问题
能完全离线吗? 可以,前提是对话模型和嵌入模型都指向本地服务,且关闭遥测。
和 RAGFlow 的区别? AnythingLLM 更偏产品化、开箱即用;RAGFlow 更偏解析深度和流程编排。
支持多人吗? 服务端模式支持多用户和工作区隔离,桌面端是单用户。
商用可以吗? MIT 许可,可以商用;模型许可单独确认。
一句话判断
AnythingLLM 适合「有一堆文档、想马上问起来」的场景。它不解决模型能力问题,但把工程链路都铺好了。
登录后可点赞、收藏与反馈。