果壳网 SEO 实测:47 万个文章 ID,首页只给 16 个入口
果壳网对 Googlebot 手机 UA 返回 302,落在一页只有 5 个链接的移动首页;科学人列表页 9 张卡片没有一条文章链接。47 万个 ID 的内容池,可抓取入口只剩首页 16 条。
果壳网的文章 ID 已经排到 470,700。把 UA 换成 Googlebot 智能手机版再请求一次,请求会先被 302 到 http://m.guokr.com,最后落在一个只有 5 个链接的首页上。本文沿着这条路,把首页、列表页、文章页三段逐段量了一遍。
测量在 2026-11-13 完成,覆盖 8 类页面、5 种 UA、38 个文章 ID 与 20 条假路径。文中字节数均为原始 HTML 传输大小,未计压缩。
一、一个站点,七种「打不开」
1.1 七种行为同时存在
同一个域名下,一个打不开的地址会得到七种不同的回应。
| 请求 | 状态 | 页面表现 | 对抓取的含义 |
|---|---|---|---|
| /abc 等未知路径 | 302 → / | 空 body,33 B | 任意错字都变成首页副本 |
| /article/234567 | 200 | 文章模板,正文为空,日期写 Invalid Date | 软 404,可被无限枚举 |
| /article/1(旧 ID) | 403 | nginx 默认页,564 B | 早期文章的外链整段失效 |
| /article/abc | 500 | nginx 500,588 B | 非法参数直接打穿到后端 |
| /science/category/任意串 | 200 | 与 /science/category/all 同一列表 | 无限 URL,全部 200、标题全同 |
| /search/?q=xxx | 302 → /?q=xxx | 首页加查询参数 | 搜索页已下线,参数泄进首页 |
| /sitemap.xml | 404 | 样式化 404,10,823 B | 唯一正常的 404,可站点没有 sitemap |
七种里只有最后一种是真的 404。前六种分别用跳转、软 404、403、500 和无限列表页,顶替了「这个地址不存在」这个信号。
对爬虫来说,最贵的不是慢,是分不清「已删除」和「临时异常」。403 与 500 会被当成可重试,302 会被当成搬家,200 会被当成新页面。
1.2 ID 空间被切成三段
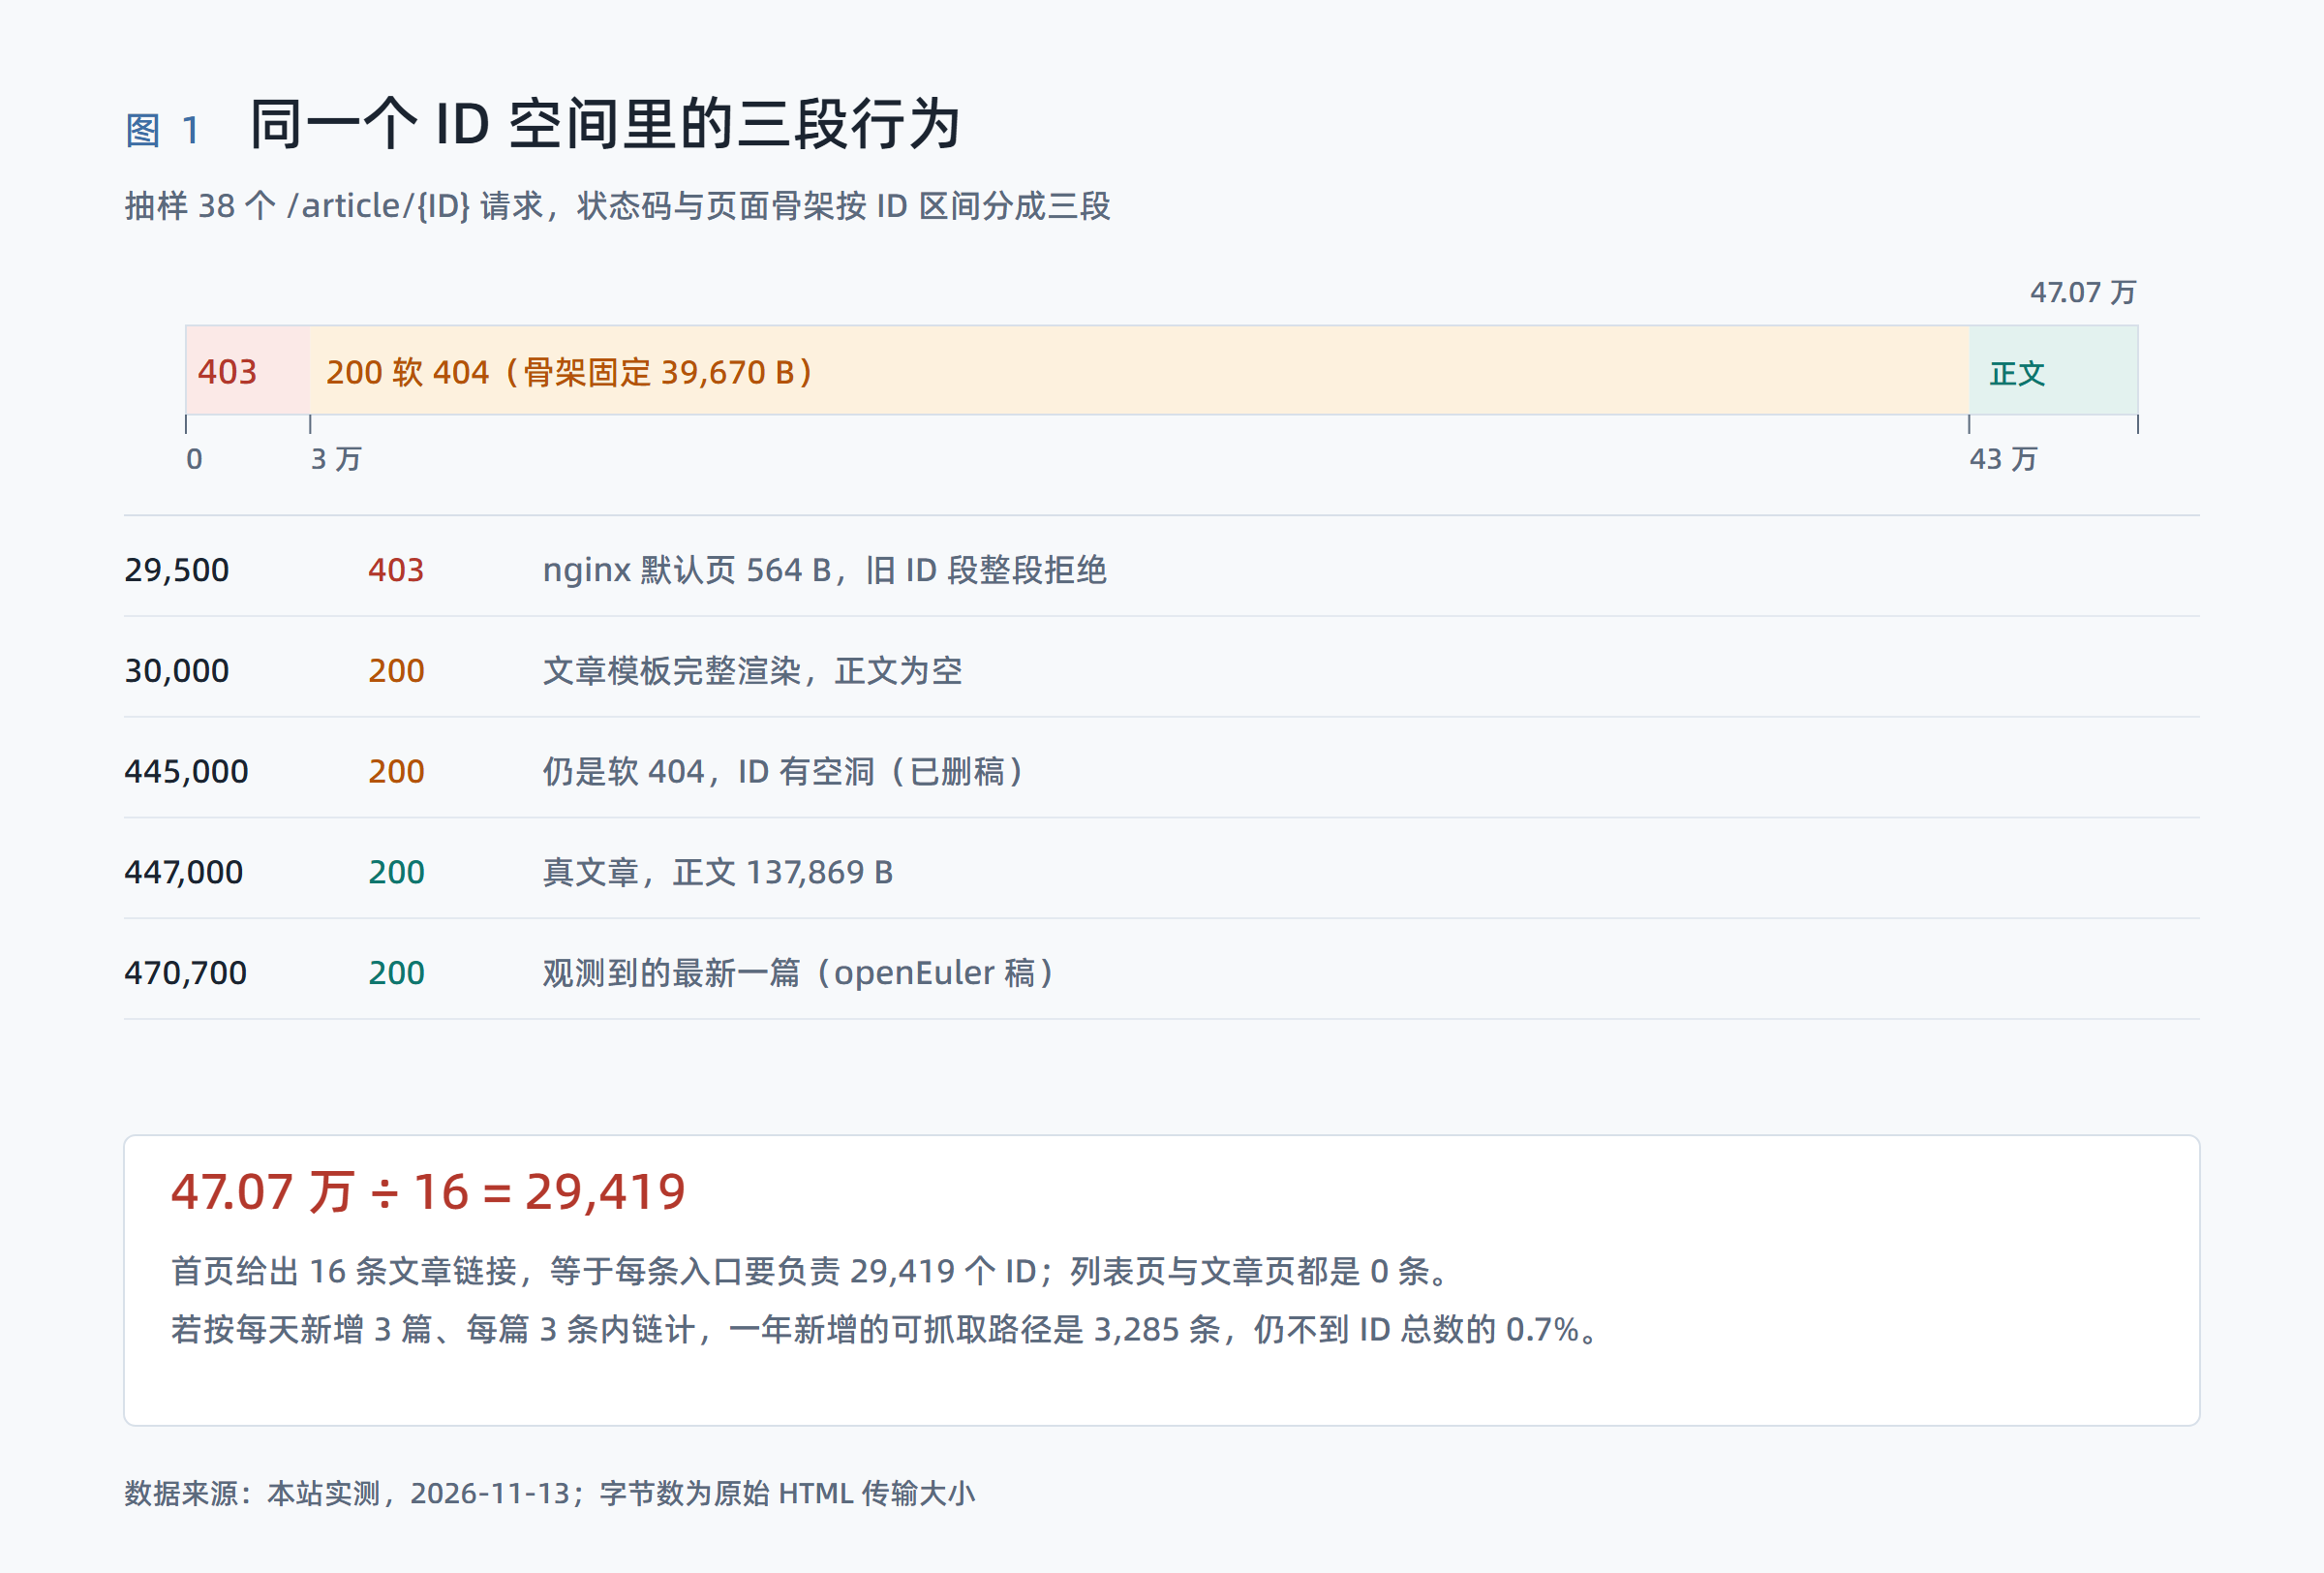
抽样 38 个 ID,状态码按区间分成三段。3 万以下是 403,分界落在 29,500 与 30,000 之间;3 万到 43 万返回 200,但页面骨架固定 39,670 字节;44 万以上才是真文章。
区间内部还有空洞。445,000 是软 404,447,000 是正文 137,869 字节的真稿。删稿留下的 ID 不回收,也不返回 404,继续以 200 的身份留在可抓取范围里。
理论上,只要有人愿意枚举,这个站可以生成无限多个「200 但没内容」的地址。而它恰好没有 sitemap,也没有可以对照的清单。
1.3 软 404 写着「发布于 Invalid Date」
软 404 用的是一套完整文章模板:正文区空着,字数栏固定写「1000 字 需用时 02:00」,时间行写「发布于 Invalid Date」,页脚版权声明一字不缺。
它的 title 用的是站点简介那 90 个字,description 与简介完全一致。于是引擎收到的,是一个有标题、有作者、有版权声明、日期非法的正常页面。
读者点进来会看到一个空壳;爬虫抓走的是一个 200。两边的体验都不对,但只有读者会发现。
二、发现链:47 万个 ID,首页只给 16 个入口
2.1 卡片标题是 div,列表页唯一的链接指向 404
/science/category/all 返回 78,192 字节、473 个汉字、11 张图、9 张卡片。全文里 href="/article/ 出现 0 次。
用无头浏览器取渲染后的 DOM,同样是 0。所以不是服务端没渲染出来,是卡片压根没写链接,跳转靠一层点击事件。
后果有三条:爬虫到不了第二篇;用户不能新开标签页;单篇不能复制链接往外发。
这 9 张卡片上唯一的可跟随链接,是作者位的 /mine/sbhkv5。实测 404,加斜杠仍是 404。列表页交给爬虫的第一条链接,是条死链。
同类的断点此前在游民星空的实测里出现过,那边是分页控件不产出 URL,入口断在第一页之后。
2.2 「加载更多」是 div,?page=2 是第 1 页的副本
分页控件是一层 div,class 为 LoadMoreWrap,没有 href,也没有页码。
加上参数再请求一次,返回的十条标题与第 1 页完全相同,重合度 1.000,字节 78,177 与 78,192 的差值只是动态片段。站点没有 rel=next,也没有任何真实的分页地址。
于是「科学人」这个频道对爬虫的全部意义,就是首页上那条频道链接本身。
2.3 五类模板的横向对照
| 模板 | 字节 | 页面汉字 | H1 | canonical | 指向文章的链接 |
|---|---|---|---|---|---|
| www 首页 | 107,770 | 625 | 0 | 无 | 16 |
| 科学人列表 | 78,192 | 473 | 0 | 无 | 0 |
| 文章详情 | 69,159 | 2,411 | 0 | 无 | 0(互链) |
| 物种日历 | 80,542 | 486 | 0 | 无 | 0 |
| 吃货研究所 | 38,482 | 157 | 0 | 无 | 0 |
| m 站文章页 | 42,779 | 2,280 | 0 | 无 | 0 |
六个模板,六个 0 H1,六条没有 canonical。
文章页的 2,411 个汉字是实打实服务端渲染的,内容并不缺。缺的是出口:它唯一带 URL 的链接是导航、作者页与页脚,没有一条通向另一篇文章。
一个正文两千多字、却不出站也不互链的页面,在抓取图里是一张叶子。叶子再多,也长不出新枝。
2.4 首页三条「更多」链到 undefined
首页三个「更多」的 href 是 /science/category/undefined。这个地址实测返回 200,内容与 /science/category/all 相同。
一个由模板字符串拼错的 undefined,被写进了三条站内链接,而且它还能正常打开,所以没人报错。
同一个模板还让 /science/category/health 返回了与 /all 一字不差的 title。分类页没有各自的标题,也没有各自的描述,只有一条共用的 80 字简介。
三、移动优先索引看到的是一个壳
3.1 手机 UA 被 302 到 http
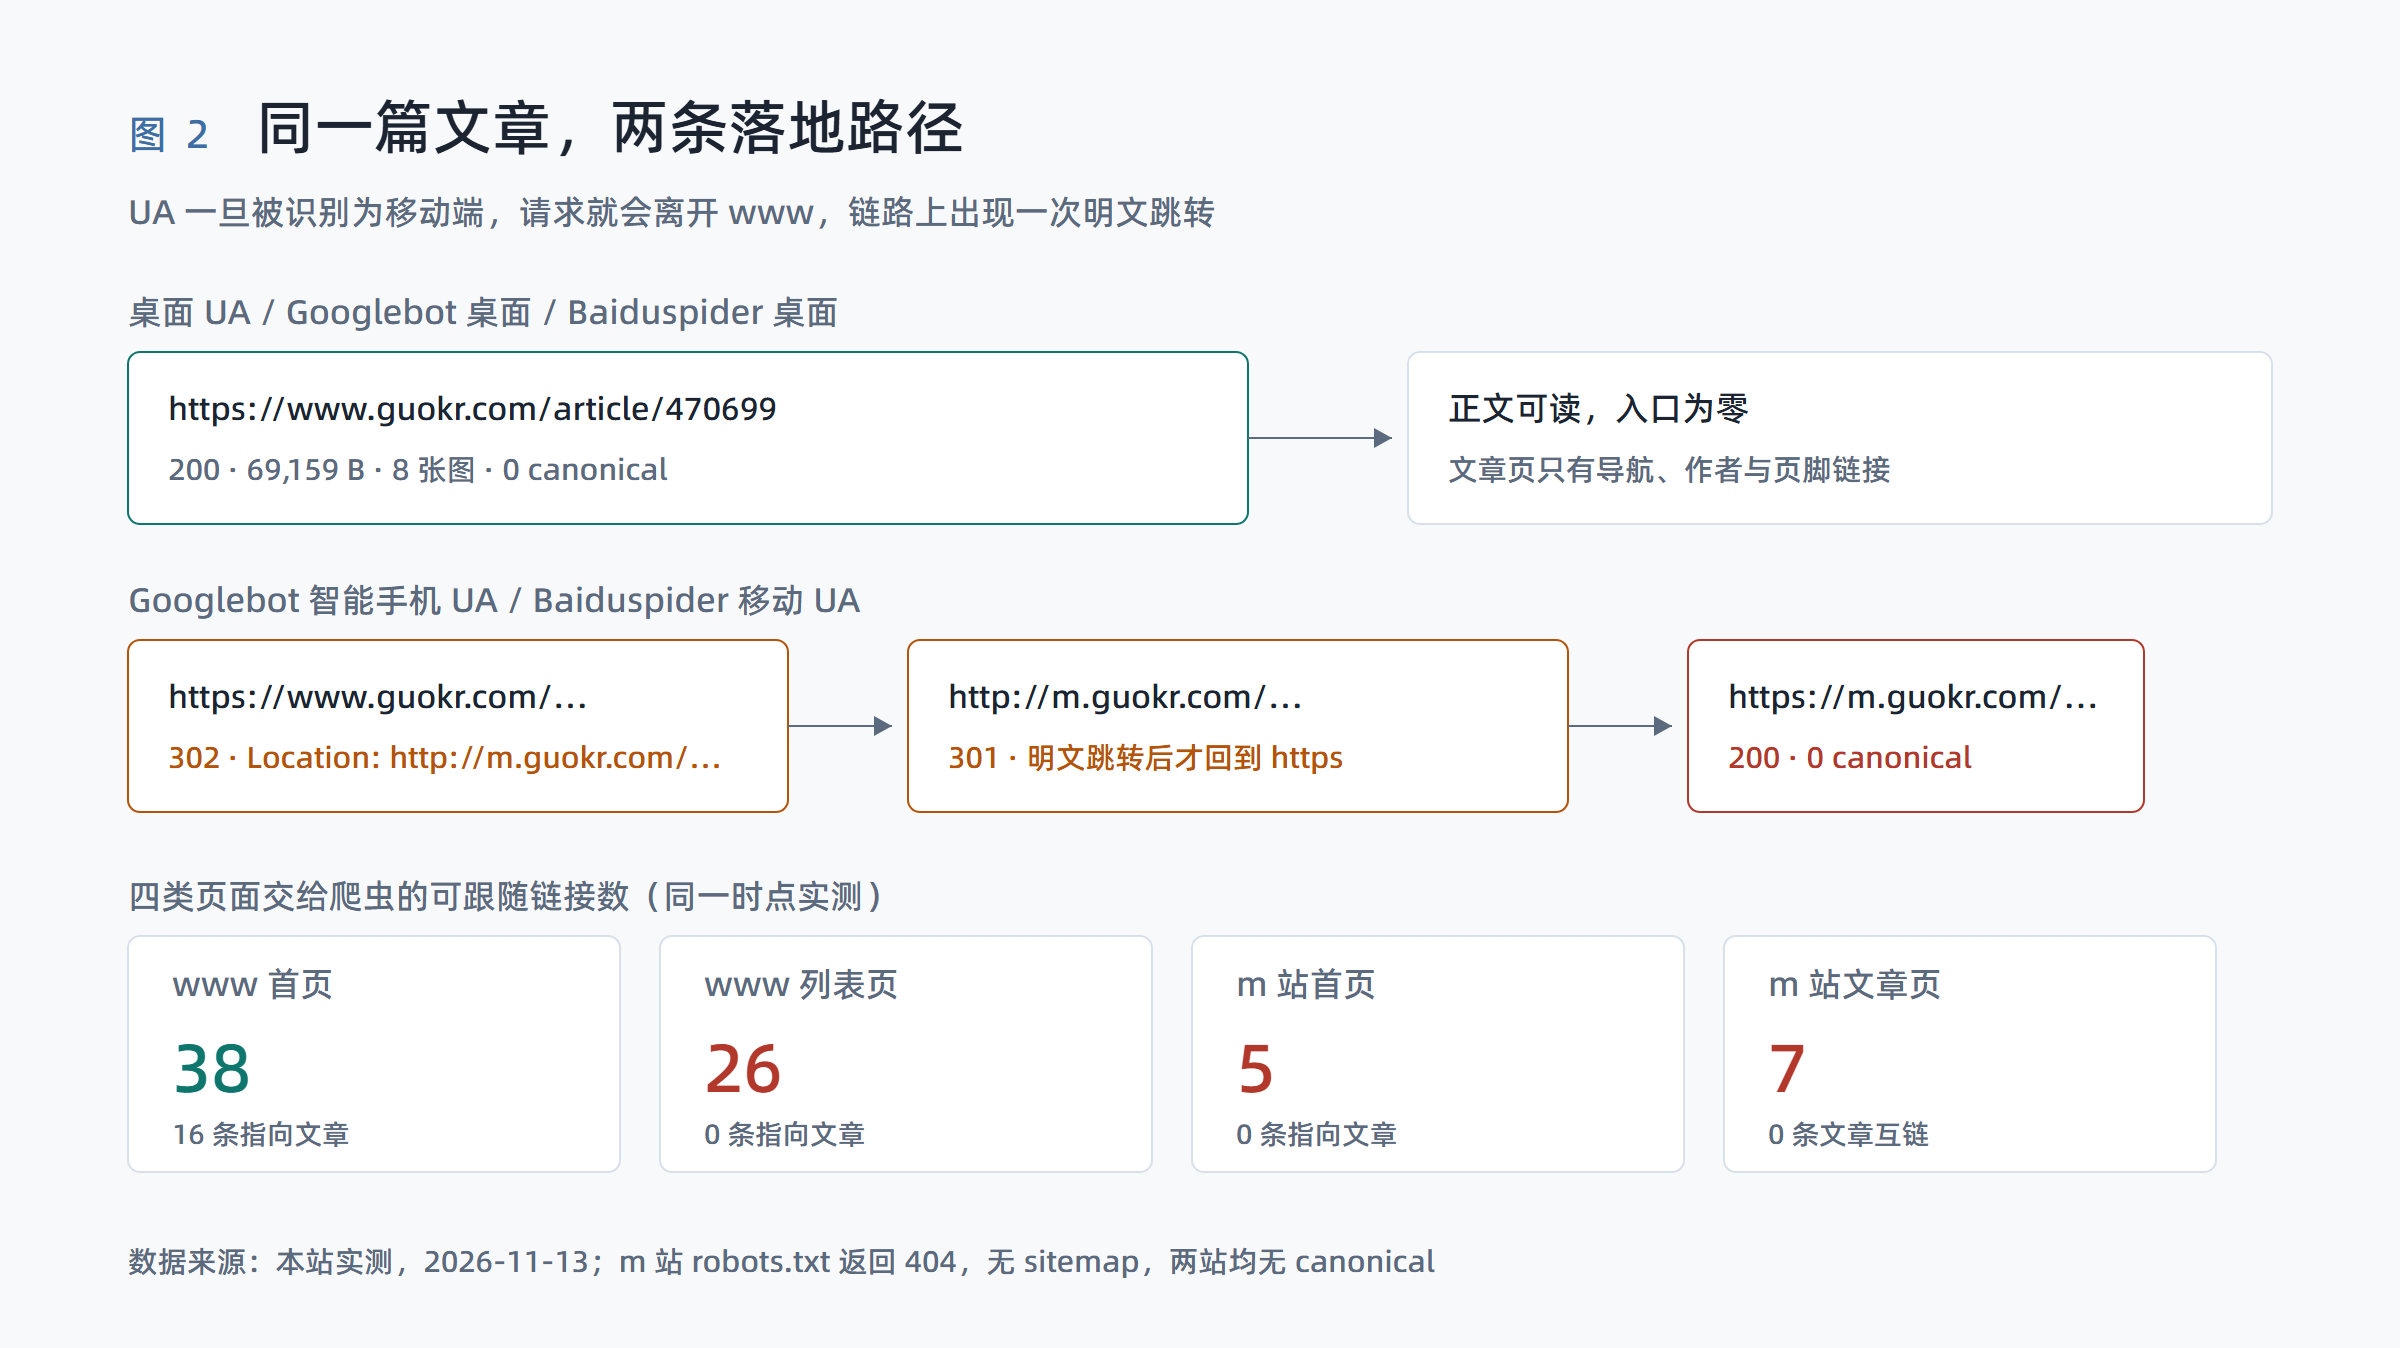
同一个 URL,桌面 Chrome、Googlebot 桌面版、Baiduspider 桌面版的响应字节完全一致,都是 200,说明站点没有按引擎分流。
换成 Googlebot 智能手机版或 Baiduspider 移动版,立刻 302,Location 是 http://m.guokr.com/ 开头的明文地址。m 站随后 301 回到 https。
apex 域名也是两跳:guokr.com 301 到 http://www.guokr.com,再 301 到 https。两条链都在中途降级到明文。
Google 用智能手机 UA 做移动优先索引。它在这里拿到的,是 302 之后的那一页。
3.2 m 站首页 103 KB,5 个链接
m.guokr.com 首页 103,103 字节,正文只有 458 个汉字,5 个 a 标签,0 条文章链接。字节几乎全部来自内联样式与图标。
文章页好一些:正文 2,280 个汉字确实在 HTML 里,可以直接读。但它只有 7 个链接,同样 0 条文章互链。
也就是说,移动优先索引下这个站交出的入口数是 5,而且这 5 条全是导航。
3.3 没有 canonical,也没有 robots.txt
m.guokr.com/robots.txt 返回 404,是 nginx 默认页。m 站所有页面 0 条 canonical,www 侧也没有指向 m 的 rel=alternate。
www 页面里只有一条 meta http-equiv="mobile-agent",指向 https://m.guokr.com/。这是熊掌号时代的写法,现在的引擎不读。
结果是同一篇文章有两个都能抓、都不声明关系的副本。桌面版 69,159 字节,移动版 42,779 字节,正文一致,标题一致,没有任何一方认领原文。
双副本叠加双协议,一篇稿在抓取日志里可以出现四种形态。抓取预算够不够用,取决于站点自己怎么定义「一篇」。
四、按优先级排的七条动作
4.1 三条 P0:把「不存在」说出来,把卡片写成链接
下面七条按「恢复抓取面的单位成本」排序。P0 是本周内能做完、不依赖排期的三条,共同点是都不需要新功能。
| 动作 | 解决什么 | 优先级 | 验证方法 |
|---|---|---|---|
| 列表卡片改成 a href,图、标题、时间三处都带 | 恢复 47 万 ID 的发现链 | P0 | 抓列表页数 href="/article/,应不少于卡片数 |
| 未知路径与软 404 统一改成 404 或 410 | 停止把错字与空 ID 变成 200 | P0 | 随机 20 条假路径全部 404 |
| 旧 ID 段去掉 403,非法 ID 去掉 500 | 收掉两类误报,避免降频 | P0 | 抽 30 个 ID,无 5xx、无 403 |
| 分页改为服务端渲染并加 rel=next | 让第 2 页起可抓 | P1 | ?page=2 与第 1 页重合度低于 0.2 |
| 移动站加 self-canonical,www 加 alternate,或取消 UA 302 | 消除每篇文章的双副本 | P1 | m 站 canonical 自指 www 原文 |
| 修 /mine/sbhkv5 与 /science/category/undefined | 去掉死链与错链 | P1 | 首页与列表页无 404 出链 |
| 补 H1、逐页 description、Article 结构化数据,替换 alt="pic" | 提升已抓页面的摘要质量 | P2 | 五个模板各有 1 个 H1 与 1 条 ld+json |
第一条收益最大。把 9 张卡片写成链接,列表页立刻从「0 条出口」变成「每页 9 条出口」,加上真实分页,一个频道就能放出上万条路径。
第二条先把「不存在」变成 404,第三条再把 403 与 500 这两类误报收回到 404。这两条走完,前面那个三分区的 ID 空间才会收成两段。
500 单独说一句:它会让爬虫降低整站抓取频率,代价远大于一个坏参数。一个 /article/abc 就够触发。
4.2 四条 P1 与 P2:分页、移动声明、死链、结构
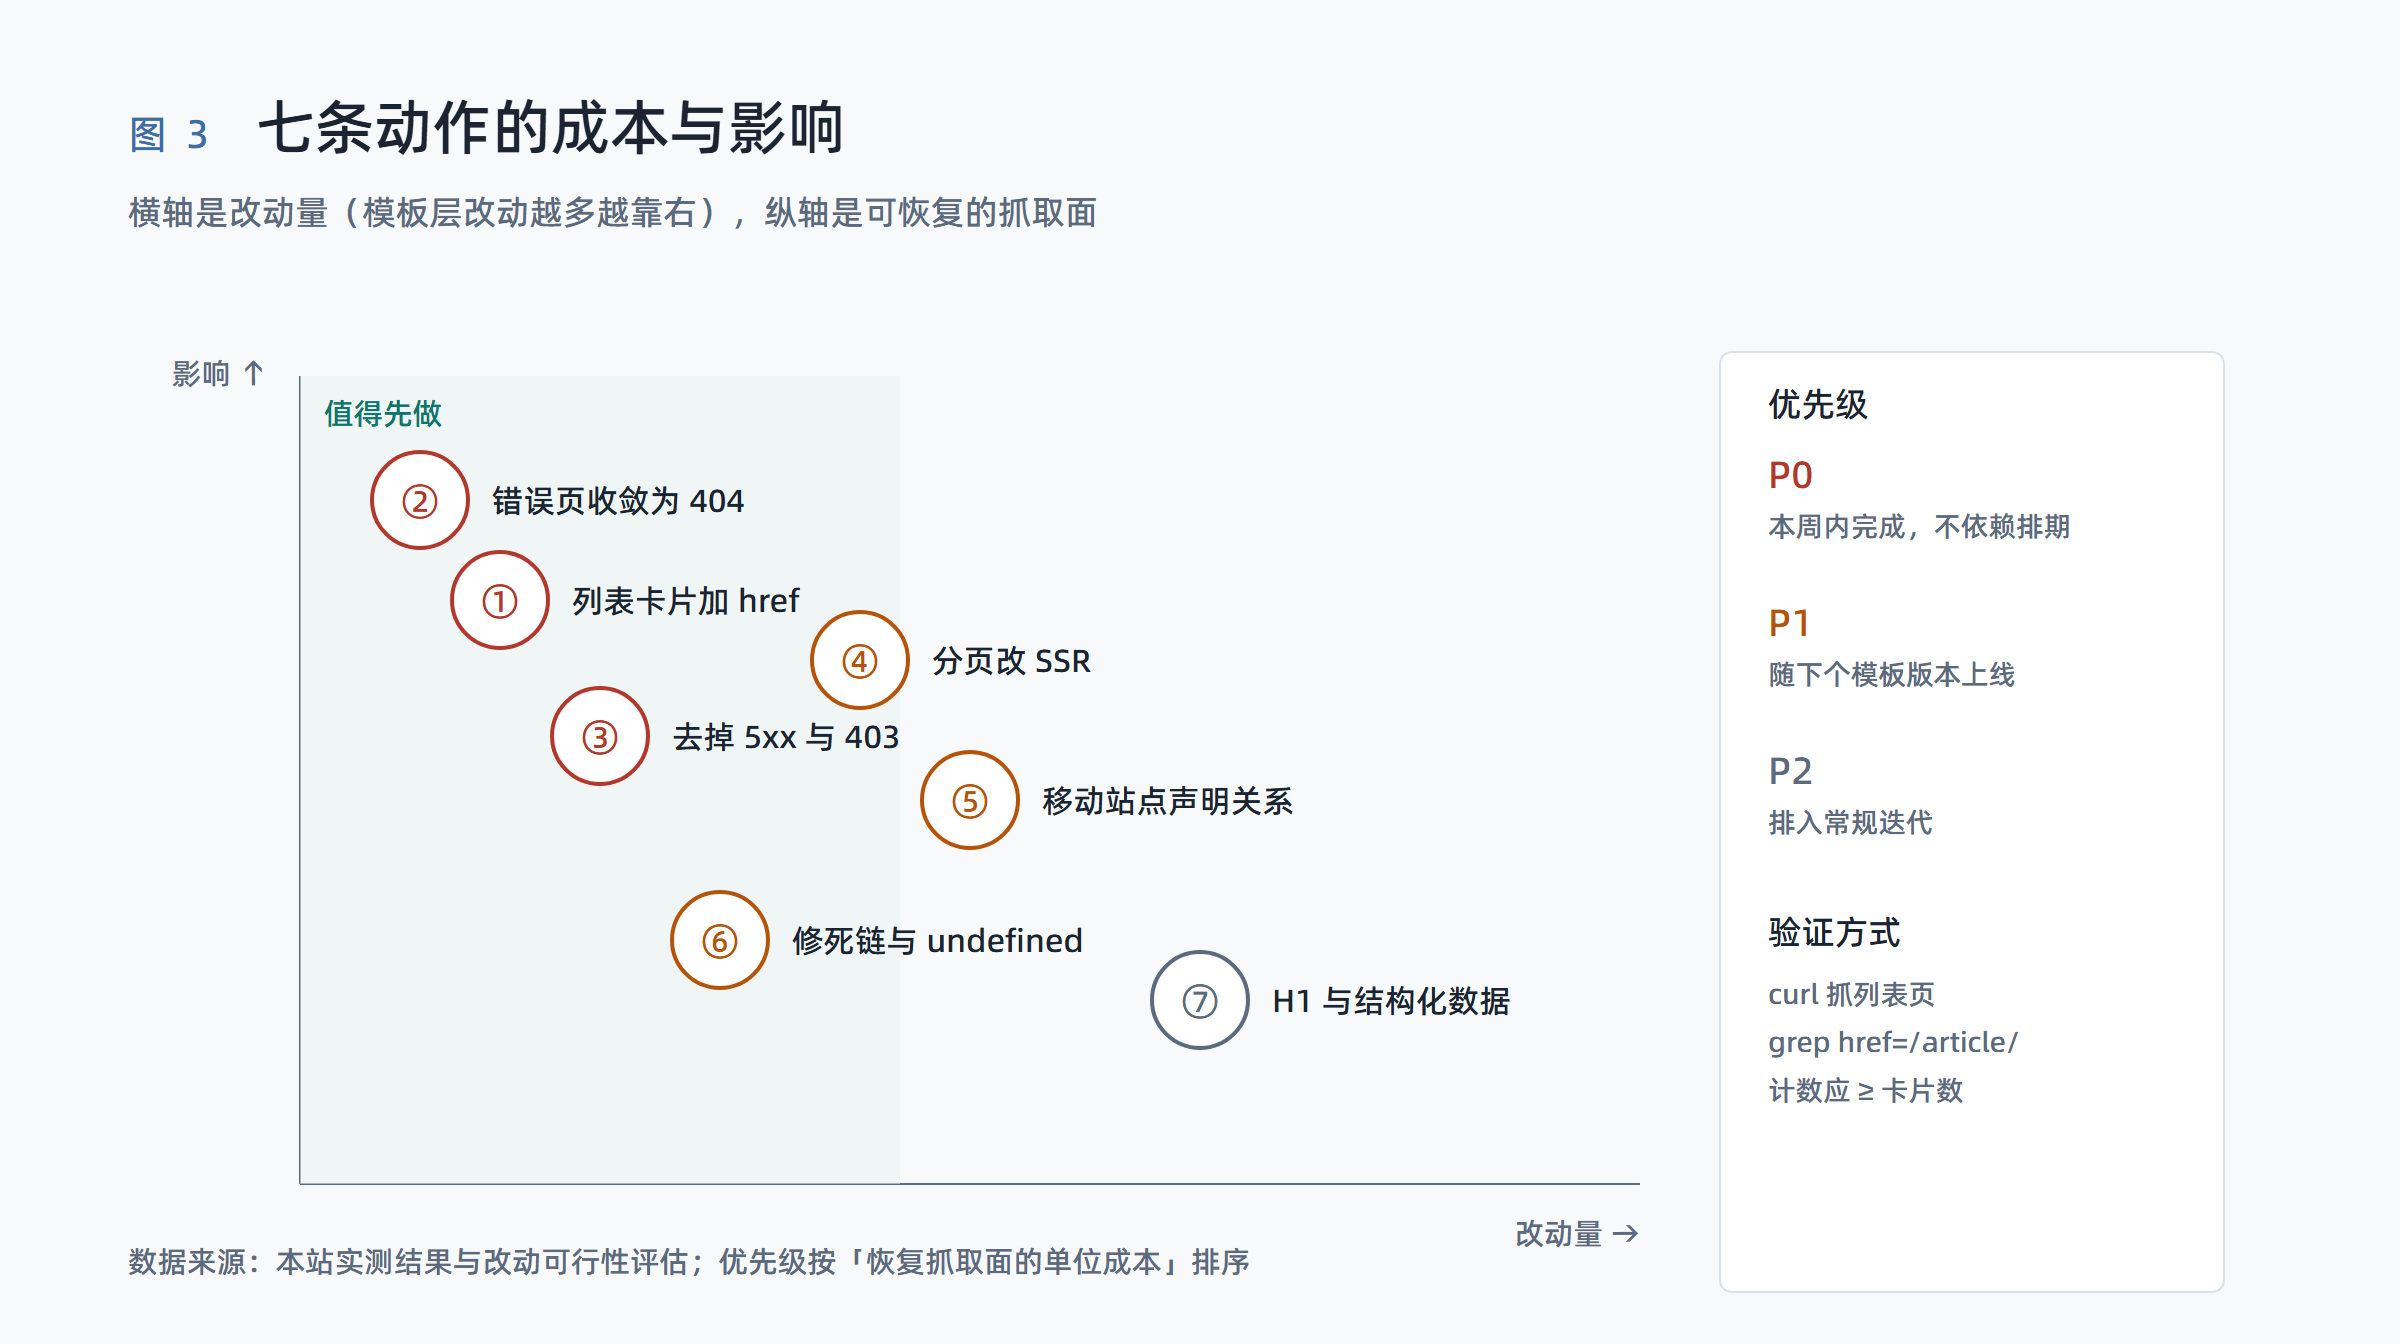
P1 的三条要跟模板版本一起发:分页改服务端渲染并加 rel=next;移动站加 self-canonical、www 加 alternate,或者干脆取消 UA 302;修掉 /mine/sbhkv5 与 /science/category/undefined。
移动那条要选一个方向。要么承认 m 站是独立的移动版本,给它自己的 canonical 与 robots;要么承认它是一个渲染层,让它 canonical 回 www。两种都行,最怕的是现在这样,两边都不说。
P2 是结构与摘要:补 H1、逐页写 description、上 Article 与 Breadcrumb 结构化数据、把 31 张图里 25 个 alt="pic" 换掉。这些不恢复入口,但决定已抓到的页面能不能拿到好摘要。
优先级不是按工作量排的,是按「一条改动能放开多少条路径」排的。①放开的是整个列表,⑦放开的是单页的点击率。
结构层面的 0 H1 与缺失的 canonical,在虎扑那篇实测里是同一组问题,那边连 238 条地址都没能阻止站点变成孤岛。
抓取预算这件事,那篇 1700 万条 URL 与 400 万索引的复盘讲得更细,可以对照看。
七条里,前三条不需要任何新功能。把「这个地址不存在」如实说出来,把卡片从 div 改成 a,一个频道的可抓取路径就能从 0 变成上万。
47 万条内容最贵的不是内容本身,是让爬虫走到第 17 篇的那条路。这条路现在只有 16 个路口,而且其中一个路口写着 undefined。
登录后可点赞、收藏与反馈。