微软365挂了30小时:Outlook/Teams打不开先自查,AI连接器急救与兜底四件套
微软365全球宕机超30小时,Outlook、Teams、Copilot与ChatGPT/Claude连接器集体失灵。本文给普通用户一套可照做的流程:状态页三入口三分钟自查、邮箱恢复期正确姿势、AI连接器急救、假客服防骗与兜底四件套。
11 月 12 日中午,你正准备回一封客户邮件,Outlook 一直转圈;点开 Teams,会议进不去;连 Copilot 都在报错。第一反应是照着网上的教程清缓存、改 DNS、重装 Office——但这次全都白费:坏的不是你的电脑,是微软自己。
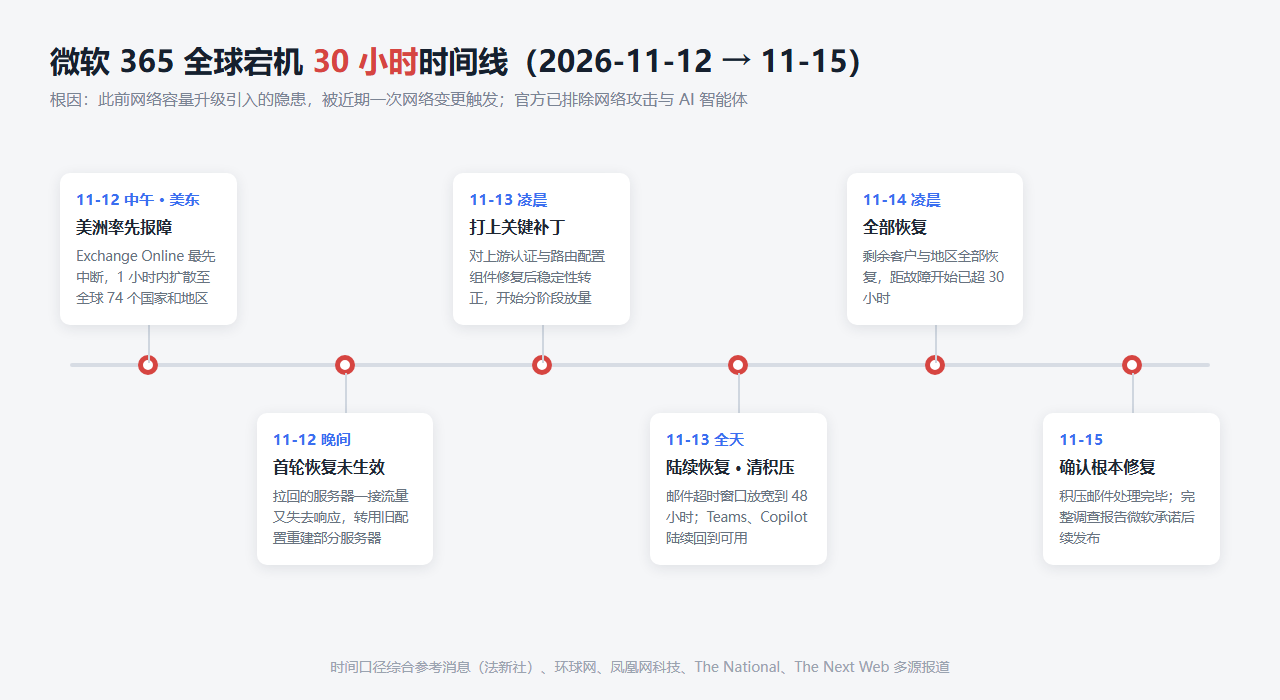
这场事故从美东时间 11 月 12 日中午开始,一小时内扩散到全球 74 个国家和地区,宕机监测网站 Downdetector 收到的报错峰值达到每分钟 19,650 条,约为平日的 1500 倍;从美洲率先报障到 11 月 14 日凌晨全部恢复,前后超过 30 小时。微软 365 的付费商业用户超过 4.5 亿,OpenAI 和 Anthropic 的 Microsoft 365 连接器也在同一天集体失灵——ChatGPT、Claude 突然「读不了你的邮箱」。
这篇不聊宏大架构,只给普通用户和小团队一套能直接照做的流程:三分钟分清「它坏了还是我坏了」、邮箱恢复期的三个正确姿势、AI 连接器断连怎么急救,以及故障后 48 小时内应该装上的兜底四件套。
这次到底发生了什么:30 小时时间线与官方根因
先说结论:官方已排除网络攻击,也排除 AI 智能体作祟。微软负责 Copilot、智能体与平台的执行副总裁查尔斯·拉曼纳在 X 上明确表示,「没有迹象表明这是恶意或网络活动造成的」。根因是:此前一次网络容量升级引入了隐患,一直没被发现,随后的一次网络变更把它触发了——部分服务器在自动健康检查中被摘除,剩余服务器像官方比喻的「高速公路多条车道同时封闭」一样过载。
更麻烦的是恢复过程:第一轮处置没有生效,被拉回服务的服务器一接到流量又失去响应,微软一度转用旧配置重建部分服务器;直到 11 月 13 日凌晨对上游认证与路由配置组件打上补丁,稳定性才转正。之后微软刻意分阶段放量、把邮件超时窗口放宽到 48 小时来清理积压,宁可慢一点也不再二次过载。
顺带交代背景:这两周 Apple Pay、NASA 内网、FAA 全国停飞接连出事。TechCrunch 采访的前 McAfee CEO、CISA 顾问委员会原副主席 Dave DeWalt 认为,这更像「AI 以前所未有的速度暴露漏洞、企业突击打补丁」带来的阵痛期。微软这次的根因与 AI 无关,但「云和 AI 越深地长进工作流,一次配置失误的乘数就越大」这个判断,值得每一个把全部工作搬上云的团队记住。
三分钟分清「它坏了还是我坏了」:状态页三入口
网上 99% 的「Outlook 打不开怎么办」教程,第一步都是教你改设置。但在平台级事故里,这一步 100% 是浪费生命。正确顺序是先查状态页:
| 入口 | 看什么 | 注意 |
|---|---|---|
| status.cloud.microsoft(或 admin.microsoft.com 的「服务运行状况」) | 官方逐服务红黄绿灯,哪家服务哪个区域正在出事 | 详细版需要管理员账号,个人账号看简化信息 |
| X(推特)@MSFT365Status | 官方状态账号,事故期间更新最勤,含处置进展 | 认准账号,山寨号很多 |
| Downdetector | 全球报障曲线:多国同时飙升=平台事故,只有你所在地区涨=本地问题 | 峰值 19,650 条/分钟这种量级,一眼可辨 |
判断口诀:同一时刻多国多服务齐挂,等官方;只有你一台设备出问题,才轮到清缓存、改 DNS、重装那套流程。顺序反了,重装半天也白装。
企业租户注意:完整的服务健康仪表盘需要管理员权限。先问公司 IT 或管理员,再动手折腾自己那台电脑。
Outlook 收不到邮件:恢复期的三个正确姿势
状态页确认是微软的锅之后,剩下的问题只有一个:怎么撑到恢复。三个姿势:
- 别清缓存。桌面版 Outlook 的缓存模式里存着近期邮件副本,云端挂掉时它反而是你唯一能翻旧邮件的地方;急着重装 Office,等于亲手把这层保险撕掉。
- 理解「恢复慢」是设计,不是怠慢。微软为避免流量一次性回流引发二次过载,刻意分阶段放量——别人恢复了你还没好,先去状态页看自己区域的进度,别急着骂。
- 换第二邮箱应急。「今天必须发出去」的邮件先用备用邮箱发,正文加一句「原邮箱故障,请回复到此邮箱」。这次日本政府部门改用电话维持工作、新西兰一度暂停签证处理,都是单一依赖卡住数小时的实例。
还有一个容易被忽略的细节:邮件积压最长要 48 小时才清完。恢复后的头两天,「我发了但你没收到」不一定是对方问题,先等等再重发。
ChatGPT/Claude 读不了邮箱:AI 连接器断连急救
这次很多人第一次意识到:AI 助手也是微软的「下游」。故障期间,OpenAI 报告其 Microsoft 365 连接器错误率升高、新建连接可能失败;Anthropic 确认 Claude 的连接器问题是上游微软服务引起,邮件、日历、搜索请求大面积失败,部分用户连不上 Claude for Outlook。
三步急救:
- 连接器报错 ≠ 模型挂了。Anthropic 状态页上 Claude API 和 Claude Code 全程正常。别因为「AI 读不了邮箱」就把整个订阅退了,那是最亏的操作。
- 先核对再动手:去 openai.com/status 和 status.anthropic.com 看一眼,确认是上游问题后,已有连接别反复断开重连——上游没恢复前,重连只会添乱。
- 急着用就手动过渡:把邮件导出成文件、或把需要分析的日历截图直接喂给 AI,功能打折但不断线。恢复后重连一次,再让它读最近一封邮件验证,能读出来才算真恢复。
Teams 进不去:最「过时」的办法为什么突然救命
故障期间,日本政府各部门邮件瘫痪,改用电话和纸质流程维持运转;摩根士丹利、高盛在香港的交易员一整天进不了邮箱和 Teams,靠电话撑过全天。最「过时」的电话会议号码,在最坏的时刻成了唯一通道。
落到行动上,重要会议前做三件事:会议链接和议程导出一份、参会人手机号留底、要讨论的文档提前下载到本地。Teams 挂掉的那一天,这三样东西就是全部生产力。
最容易被忽略的次生灾害:假「技术支持」来电
故障期间,渣打银行和 ING 澳大利亚先后向客户发出警告:有骗子冒充技术支持,借「服务中断」行骗。大范围宕机=大量用户慌着找人求助,正是社会工程攻击的黄金窗口。
记住一条铁律:真官方永远不会打电话向你索要密码、MFA 验证码或付款。接到这类电话先挂断,用状态页核实服务状态,需要帮助走官方支持渠道提交工单。
故障后 48 小时内,把兜底四件套装上
复盘完这次 30 小时,真正值得花时间的是下面这四件事——加起来不到一小时,换的是下一次云中断时「工作不死机」:
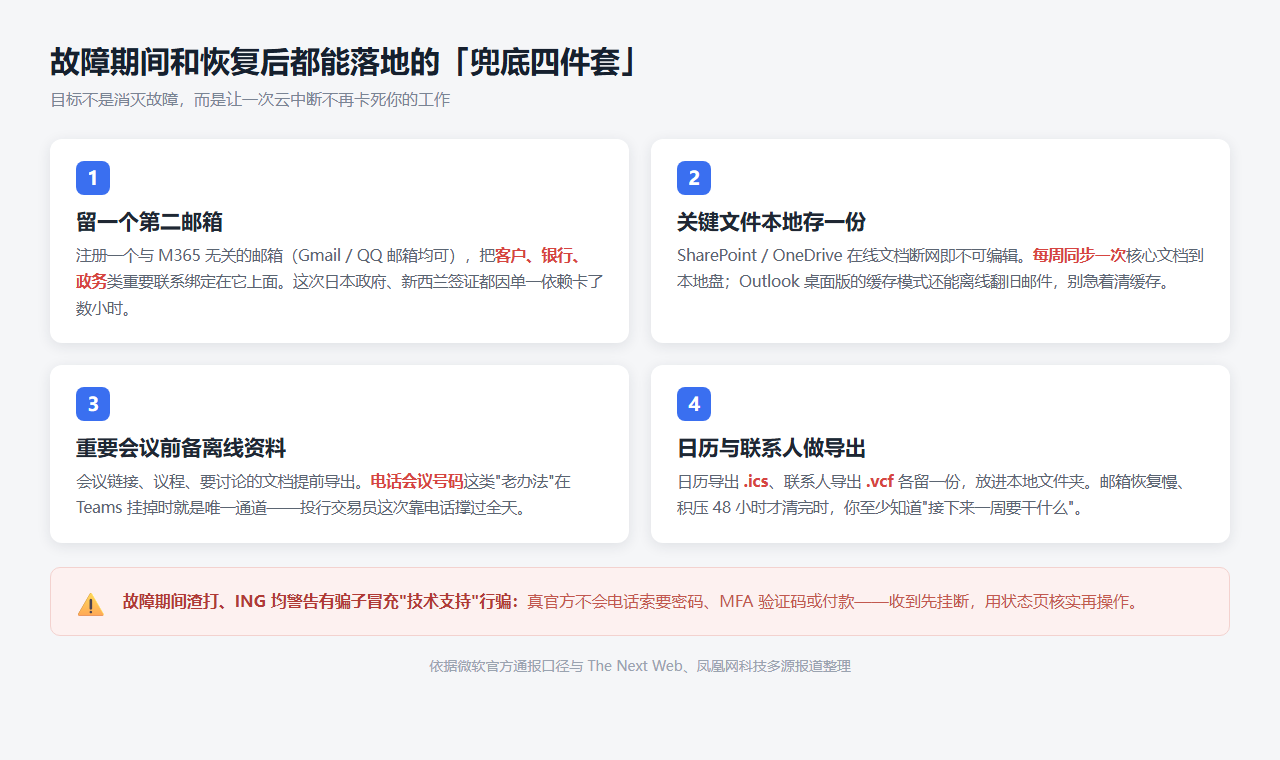
其中日历导出 .ics、联系人导出 .vcf 这一步最常被跳过:邮箱恢复慢、积压 48 小时才清完的时候,你至少知道「接下来一周要干什么」。
常见翻车与急救清单
| 症状 | 大概率原因 | 该做什么 |
|---|---|---|
| Outlook 转圈打不开 | 平台级事故(74 国齐挂那种) | 先查状态页三入口,别重装 |
| 重装 Office 后还是打不开 | 装错了对象,服务端没恢复 | 等状态页转绿;缓存模式找回旧邮件 |
| 别人恢复了我还没好 | 分阶段放量,区域有先后 | 状态页看本区域进度,别急 |
| 恢复后邮件迟迟收不到 | 积压清理最长 48 小时 | 等待;重要件用第二邮箱补发 |
| ChatGPT/Claude 读不了邮箱 | M365 连接器上游故障 | 看 status 页;别反复重连;手动喂文件过渡 |
| 以为 AI 挂了想退订 | 把连接器当成了模型本身 | status.anthropic.com / openai.com/status 核对 |
| 「技术支持」来电索要密码或验证码 | 借故障行骗的诈骗电话 | 挂断;官方渠道核实 |
| Teams 会议进不去 | 服务中断 | 电话会议号 + 提前下载的文档 |
边界与总结
三条诚实边界,先说清楚:
- 本文自查流程适用于个人与中小企业用户;大型租户应以管理员后台的服务健康仪表盘为准,微软承诺调查结束后发布完整事故报告,届时建议让 IT 再对一遍。
- 国内由世纪互联运营的 Microsoft 365 是独立部署的云,通常不与全球版变更联动,是否受影响以官方状态页为准。
- 兜底四件套防的是「被卡死一整天」,防不了数据丢失——真正关键的数据仍需要专门的备份策略,两者不能互相替代。
一句话总结这次 30 小时:检查顺序比折腾手法重要,第二通道比应急预案重要。状态页三入口、连接器急救、兜底四件套,装上就忘,出事时它们会自己站出来。
最后互动一下:11 月 12 日中午你手里正在干什么?Outlook、Teams 还是 Copilot 先崩的?那 30 小时你靠什么撑过去的——评论区报一下你的姿势,卡在恢复阶段的也欢迎留言,我帮你对着状态页排查。
登录后可点赞、收藏与反馈。


