Meta Muse Ember:0.14 美元一次任务,小模型接管执行层
Meta 11 月 9 日发布 Muse Ember:输入 0.10 美元/百万 token,1M 上下文,AA 智能指数 36 与 Claude Haiku 5.5 打平,单任务成本约为后者的三分之一。本文拆解定价结构、评测口径的三处陷阱,以及它在智能体架构里该放在哪一层。
Muse Ember 是 Meta 超级智能实验室 11 月 9 日发布的小模型,卖点不是更强,而是更便宜:每百万输入 token 0.10 美元,Artificial Analysis 智能指数 36 分,与 Claude Haiku 5.5 打平。这篇把它的价格、分数、来历和口径问题拆开看。
价格:把执行成本压到十分位
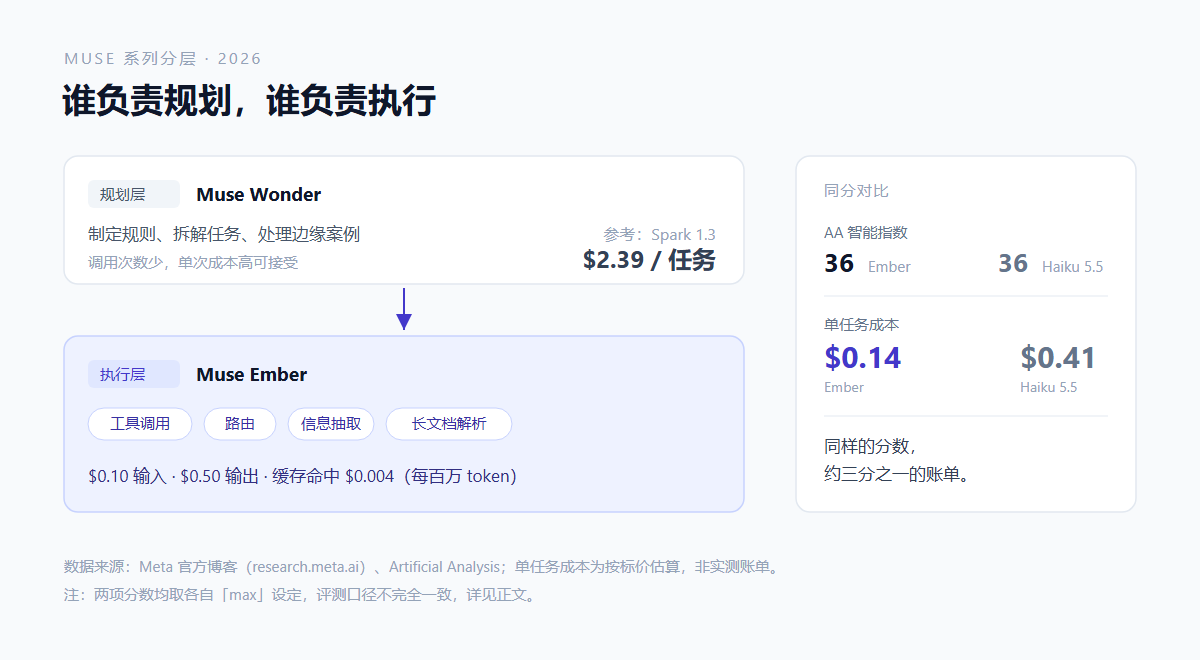
官方定价是三档:输入 0.10 美元/百万 token,缓存命中输入 0.004 美元,输出 0.50 美元。上下文窗口 1M token,最大输出 512K token,支持 Responses API,模型标识 muse-ember-1.0,通过 Muse Code 与 Meta Model API 两条通道提供。
Meta 在博客里把定位写得很直白:Ember 面向「智能体每天重复的活」——工具调用、编码子任务、路由、信息抽取、长文档解析。按 Artificial Analysis 的口径,它跑一次任务约 0.14 美元;同一口径下 Muse Spark 1.3 是 2.39 美元。
有一点必须提前说明:这里没有权重。Ember 只提供 API,不开源,也不发检查点。
分数:几乎打平,账单差三倍
AA 智能指数上,Muse Ember(max)得 36 分,与 Claude Haiku 5.5(max)相同,GPT-6 Luna(max)为 28 分。差距落在账单上:第三方测算的单任务成本是 0.136 美元对 0.411 美元,约三分之一。
| 评测项 | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| AA 智能指数 | 36 | 36 | 28 |
| AutomationBench-AA | 37.8 | 13.9 | 20.2 |
| Coding Agent Index-AA | 46 | 37 | 31 |
| Terminal-Bench 4.0 | 40.9 | 39.2 | 16.4 |
| OSWorld 2.1(二值) | 33.8 | 27.8 | 未列 |
| FrontierCode 2.0-AA | 27.2 | 34.9 | — |
反证也要写清楚。FrontierCode 2.0-AA 上 Ember 只有 27.2,输给 Haiku 5.5 的 34.9。这个基准评的是真实工程任务的「可合并性」,比刷分更接近生产环境。
所以结论要收窄:Ember 的优势集中在高频、短链、可校验的执行动作,不在困难的工程判断。拿它替掉整条流水线上的规划环节,会掉分。
来历:Wonder 的第一个学生
官方披露,Ember 是第一个用 Muse Wonder Full 训练出来的模型。这句话的意思是蒸馏——把最大模型的能力压进一个专用小模型,而不是从零训一个小模型。
看产品线更清楚:Spark(4 月)、开源姊妹版 Glimmer(8 月)、前沿模型 Wonder(10 月)、消费端 Muse Agent(9 月),现在补上执行层 Ember。贵的负责想,便宜的负责干,分层定岗成了 Meta 明确的组织结构。
代价是内部竞争。Ember 36 分对 Spark 1.3 的 37 分,只差一分,单任务成本却差约 17 倍。在「够用即止」的子智能体场景,Spark 被自己的小兄弟挤掉了。
场景侧的证据与它的边界
首发伙伴给了几个可参考的数字:Cloudflare 称尾部延迟比其对标的同类模型最多快 30%;You.com 测到编码任务 p95 延迟 2.2 秒,比头部开源模型快 4 到 13 倍,输出 token 少 36% 到 48%。Box、Cline、Oracle 也在首批名单里。
这些都是厂商自述,没有独立复现。延迟与 token 数的改善方向可信,具体倍数应当视为上限而非均值。
三个不能直接采信的口径
一,部分分数是内部评测。PerceptionBench(Ember 80.6%、Haiku 78.6%、Luna 62.8%)、OSWorld 2.1、Agents' Last Exam 均标注为 Meta 内部评测,没有第三方复核。
二,harness 不同。Terminal-Bench 里 Ember 用 mini-swe-agent、Haiku 用 Claude Code、Luna 用 Codex,各跑各的最佳外壳,不是同条件对比。
三,0.14 美元是标价估算。真实账单取决于缓存命中率与输出长度。缓存输入价 0.004 美元是输入价的二十五分之一,命中率高的流水线实际成本会明显低于标价;反过来,输出占比高的任务会更贵。
对选型的影响:把它当采购问题
把 Ember 放进架构里,判断标准只有三条:任务是否可枚举(路由、抽取、分类属于可枚举)、错误是否可回滚(读日志可以,动生产库不行)、输入 token 是否远大于输出 token(长文档解析属于此类,缓存收益最大)。
三条都成立,就该把这一层换成便宜模型;任何一条不成立,仍然交给大模型。Ember 真正的意义不是「小模型追上来了」,而是把「同一分数下谁最便宜」变成了可计算的采购问题。
类似的成本分层在国内也已经出现:蚂蚁百灵的 Ling-3.2-flash 用 560B 总参数、25B 激活走同一条低价路线;端侧则是另一条路,面壁 MiniCPM-V 4.7 把 35B 压进 3GB 内存解决本地部署。差别在于 Ember 不给权重,只卖调用——这恰好是它与 Kimi K3.1 Pro 这类开放权重模型 最根本的分野。
登录后可点赞、收藏与反馈。