打印机都能跑 Gemma 3 270M:没有 N 卡的老电脑,照这三板斧也能跑本地模型
谷歌工程师在 14.1MB 内存的激光打印机上跑通 Gemma 3 270M。本文提取实验中可搬运的三板斧:官方 QAT 量化、内存预算倒推、mmap 分层加载,落到 llama.cpp 纯 CPU 路线,附完整命令与 8 条报错急救清单,写给没有 N 卡的低配老电脑用户。
全网 99% 的本地大模型教程,第一步都是「确认你有 NVIDIA 显卡」。没装 CUDA 的机器,连照抄的资格都没有。11 月 17 日,谷歌 DeepMind 技术团队成员 Omar Sanseviero 在 X 上晒出一个实验:一台理光办公激光打印机,没改固件、没插任何外接计算板,峰值内存只占 14.1MB,硬是把 2.7 亿参数的 Gemma 3 270M 跑了起来——代价是每输出一个词元约 60 秒。
这篇不围观猎奇,只做一件事:把这个实验里真正可搬运的三板斧——官方 QAT 量化、内存预算倒推、分层加载——落到 llama.cpp 的纯 CPU 路线上。INT4 量化后模型文件约 125MB,一台没有独显的 4GB 内存老笔记本就能装下、能跑通。命令和参数全部给全,报错急救清单放在文末。
先看懂打印机实验:哪些抄不了,哪些必须抄
先把实验拆成五个要素,每一项都标注「能不能搬回家」:
| 实验要素 | 打印机上怎么做的 | 能不能搬 |
|---|---|---|
| 设备 | 理光办公激光打印机,未改固件、未加外接计算板 | 设备无所谓,思路通用 |
| 载体 | 把小型 Transformer 推理引擎与量化模型编译成一份 PostScript 打印任务,交给打印机内置解释器执行 | 抄不了:一次性极限实验,没有公开工具链 |
| 模型 | Gemma 3 270M 量化版,推理涉及 18 个 Transformer 网络层 | 必须抄:小参数 + 官方量化 |
| 内存 | 不一次性装下整个模型,动态层加载,各层轮流进出内存,峰值 14.1MB | 必须抄:思路照搬即可 |
| 速度 | 约 60 秒输出 1 个词元;预填充阶段处理提示词 Read the fine 约 184 秒,解码单词元 0.1 秒 | 认清代价:无加速器的物理极限 |
PostScript 路线展开说一句:整个计算发生在打印机内部,打印机 CPU 执行 PostScript 程序算完,再把答案印在纸上——输入提示是 Read the fine,最后纸上打出了 Read the fine print。这是借助 Gemini 4 Carbon 辅助探索出来的实验,Sanseviero 自己的定位也很克制:把硬件推到极限的测试,离能干活还远。你没有这套工具链,也不需要——普通设备上有现成得多的替代品。实验里三个决定成败的技术选型,才是低内存设备的通用解法:
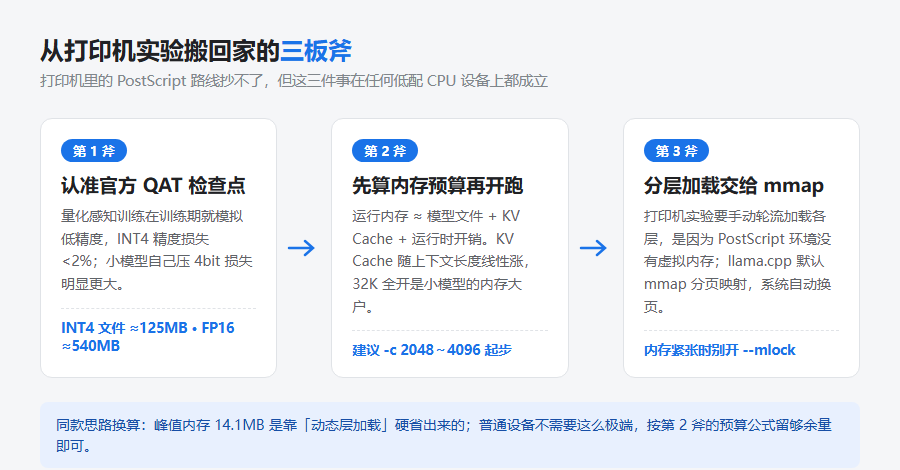
第一板斧:认准官方 QAT 检查点,别自己压 4bit
量化感知训练(QAT)和常见的训练后量化(PTQ)是两回事:QAT 在训练阶段就模拟低精度运算,模型天生知道怎么在 4bit 下保持行为;训练后自己压 4bit,对大模型损失可控,对 270M 这种小模型误差会被放大。谷歌给 Gemma 3 家族提供了 QAT 检查点,官方口径是 INT4 精度下性能损失微乎其微——这就是打印机实验敢把 2.7 亿参数塞进 14MB 内存的前提之一。
Gemma 3 270M 的官方规格,决定它天生适合低内存设备:
| 规格项 | 数值 |
|---|---|
| 总参数量 | 2.7 亿(约 1.7 亿在嵌入层,1 亿在 Transformer 模块) |
| 词表 / 上下文 | 256,000 词元 / 32,768 上下文(纯文本) |
| INT4 量化文件 | 约 125MB |
| INT4 实际运行内存 | 约 240MB 量级(含 KV Cache 等运行开销) |
| FP16 全精度 | 约 0.5GB,低内存设备不推荐 |
| 能效参考 | 官方在 Pixel 9 Pro 上实测:INT4 版 25 轮对话仅耗电 0.75% |
拿货渠道说清楚:Hugging Face 的 google/gemma-3-270m-it 是 gated 模型,先在模型页同意许可协议再下载;Gemma 3 家族的 QAT 检查点在 google 主页下按 qat 关键词检索。如果 270M 没有现成的 GGUF 量化文件,把权重下到本地后用 llama.cpp 的 convert_hf_to_gguf.py 自行转换,Q4_0 档位即可——对小模型来说,有官方 QAT 就优先官方,没有再自己压。
另一件必须提前知道的事:官方创作者明确说过,270M 开箱即用不是好的编码模型,也不追求事实准确性。它的强项是 IFEval 指令遵循——情感分析、实体抽取、格式转换这类「定义明确的单一任务」。想让它答事实,配检索(RAG)或者自己微调,别裸奔。
第二板斧:先算内存预算,再决定上下文开多大
很多人在低内存设备上翻车,不是模型装不下,而是上下文开太大。运行内存的构成是一个简单公式:
运行内存 ≈ 模型文件 + KV Cache + 运行时开销
KV Cache 随上下文长度(-c 参数)线性增长。270M 虽然支持 32K 上下文,但在 2GB 内存的老设备上把 32K 全开,KV Cache 反而成了内存大户——这正是「参数小 ≠ 内存小」最容易踩的误区。预算对照看这张图:
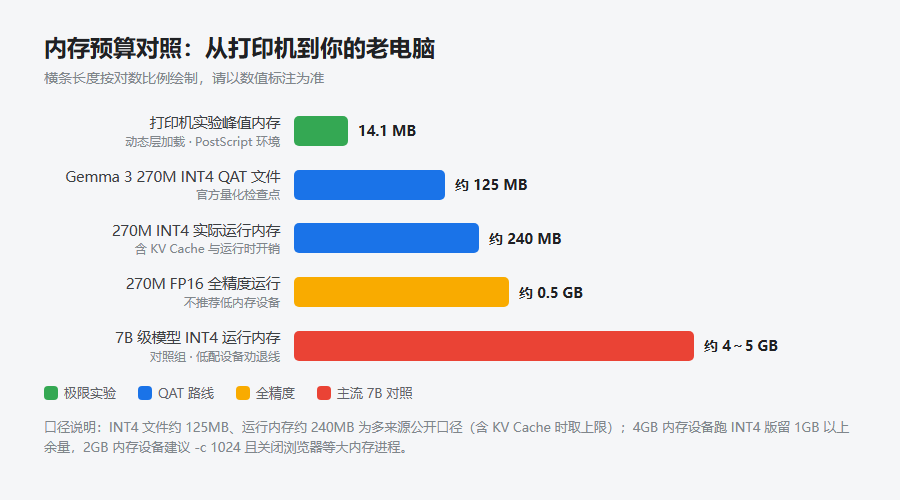
落到配置上:4GB 内存设备(老笔记本、瘦客户机)用 INT4 版 + -c 2048~4096,留 1GB 以上余量;2GB 内存设备(NAS、软路由、老一体机)建议 -c 1024 起步,并关掉浏览器等大内存进程。想跑长文处理,先升上下文再观察内存水位,而不是反过来。
第三板斧:分层加载不用自己写,mmap 已经替你做了
打印机实验为什么要手动「轮流调入、移出内存」?因为 PostScript 解释器环境没有虚拟内存和分页机制可用,只能自己实现层级的流式加载。普通操作系统上这件事有现成答案:llama.cpp 默认用 mmap 分页映射模型文件,用到的层才被系统换入物理内存,效果就等价于打印机实验里的动态层加载——只是这件事操作系统替你做了。
完整命令链,纯 CPU 路线四步:
# 0. 下载权重(gated 模型,先在 HF 页面同意许可并 huggingface-cli login)
huggingface-cli download google/gemma-3-270m-it --local-dir ./gemma-3-270m-it

# 1. 转 GGUF(若已下载现成 GGUF 量化文件,跳过这两步)
python convert_hf_to_gguf.py ./gemma-3-270m-it --outfile gemma-3-270m-f16.gguf
./llama-quantize gemma-3-270m-f16.gguf gemma-3-270m-q4_0.gguf Q4_0

# 2. 拉起服务:纯 CPU、不开显存加载、上下文压到 2048
llama-server -m gemma-3-270m-q4_0.gguf -c 2048 -t 4 --host 127.0.0.1 --port 8080

# 3. 浏览器打开 http://127.0.0.1:8080 直接对话,或用 OpenAI 兼容接口调用参数注释逐行说:-c 2048 是上下文长度,KV Cache 的内存大头,2GB 设备降到 1024;-t 4 填物理核心数而不是逻辑核心数,超线程反而会拖慢老机器;--host 127.0.0.1 只监听本机——需要局域网访问改成 0.0.0.0 时,务必确认没有暴露到公网,这个坑后面急救清单里还会出现。不想碰命令行,LM Studio 里搜 Gemma 3 270M 的 GGUF 量化版也能直接跑,Ollama 对 Gemma 3 系列的支持同样到位。
常见翻车报错与急救清单
低配设备跑本地模型的高频翻车点,对照症状直接抄解法:
| # | 症状 | 原因 | 解法 |
|---|---|---|---|
| 1 | 加载到一半进程被杀 / 提示 out of memory | 上下文开太大,KV Cache 撑爆内存 | -c 降到 1024/2048;关掉浏览器等大内存进程 |
| 2 | convert_hf_to_gguf.py 报 unsupported architecture | llama.cpp 版本太旧,不认识 Gemma 3 | git pull 拉最新版重新编译 |
| 3 | huggingface-cli 下载报 401 / 403 | gated 模型未同意许可或未登录 | 先在模型页点同意协议,再 huggingface-cli login;国内网络可配 hf-mirror 镜像 |
| 4 | 输出乱码或无限复读 | 套错了对话模板 | 用模型自带 chat template,别手拼提示词格式 |
| 5 | 速度远低于同硬件的其他模型 | -t 填了逻辑核数;或开了 --mlock 导致锁页失败 | -t 改物理核数;内存紧张的设备去掉 --mlock,让系统正常换页 |
| 6 | 答案胡编 / 代码写不了 | 模型定位如此:270M 不追求事实性、不是编码模型 | 配 RAG 或微调;要通用能力换 1B 以上模型 |
| 7 | --mlock 报 cannot lock memory | 系统不允许锁定这么大的内存 | 直接去掉该参数,mmap 换页机制照样工作 |
| 8 | 服务起了但别的机器访问不到 | --host 默认 127.0.0.1 只监听本机 | 改 0.0.0.0 并加防火墙规则;严禁裸奔到公网,无鉴权接口等于把机器送人 |
三类任务对号入座:它到底能干什么活
低内存设备省下来的是钱和电,代价是能力边界必须认清:
- 放心交给它:情感分析、实体抽取、意图路由、文本转 JSON、游戏 NPC 本地对话——高吞吐、定义明确的单一任务,官方定位就是「模型舰队」里的廉价专员;
- 勉强能用:受控格式的短问答、固定模板的摘要,输出后最好过一道校验;
- 直接劝退:通用聊天、写代码、多步推理、超过 32K 的长文(模型纯文本且 32K 是硬上限),这些请上 1B 以上模型或云端 API。
写在最后:三板斧的天花板与下一步
诚实边界:60 秒一个词元的打印机实验说明,量化省的是内存,省不了算力——没有加速器时,速度瓶颈是物理规律。这套三板斧解决的是「装得下、跑得起来」,不解决「跑得快」。另外 PostScript 路线是一次性实验,别指望照抄把你家打印机变成 AI 主机;270M 的天花板是单一明确任务,拿它当聊天主力会失望。想要「能用」的本地质量,预算加到 1B 起步;想要快,加一块二手亮机卡之外的真加速卡,那就是另一篇文章了。
顺便说一句:打印机实验真正的价值不是实用,而是把「小参数 + 官方 QAT + 分层加载」这条路线的底线打穿了——连打印机都装得下,你那台吃灰老笔记本大概率也行。
你手里最寒酸的跑过模型的设备是什么?老 ThinkPad、NAS、软路由还是机顶盒?卡在哪一步、报了什么错,评论区报配置,我帮你看。
登录后可点赞、收藏与反馈。


