高通 AI200 开放云评估:不装 HBM 跑 10T 级推理,进评估池前先过五关
高通首款机架级推理方案 AI200 开放云评估:56 卡 43TB LPDDR、带宽 414TB/s。对比 GB200 NVL72 差在哪、select customers 怎么进、评估期验什么、八个想当然的坑与劝退边界,数字全部标注官方口径。
全网讲机架级推理的内容,默认你桌上摆的是 N 卡:不是 GB200 NVL72 就是 H100/B200 续约。可 2026 年 11 月 17 日高通官方宣布,旗下首款机架级推理方案 Dragonfly AI200 已经通过 Cirrascale 的 AI Innovation Cloud 向部分客户开放云评估——这是非 N 卡阵营第一次把「整机架」级别的选项摆上桌,而不是单卡试水。结果三天过去,中文圈还在复读去年 10 月那篇官宣稿:评估怎么进、进去验什么、和 NVL72 比差在哪,几乎没人写。
更麻烦的是,在 Hopper 卡租赁涨价、多年期续约报价翻倍的背景下(我们之前写过一份GPU 租赁涨价后的续约前盘点),很多中小团队正处在「续不起也换不动」的窗口期。AI200 这条 LPDDR 路线恰好是冲着推理成本来的:单机架 56 卡、43TB 内存,官方称一个机架就能跑 10T 级参数模型的推理。
这篇不写宏大叙事,只讲三件能落地的事:这台不装 HBM 的机器强在哪、弱在哪;云评估的真实门槛和验货清单;以及八个最容易想当然的认知坑。所有数字均标注官方口径,官方没公布的直接写「官方未公布」,不做推算。
高通 AI200 是台什么机器:先把规格说成人话
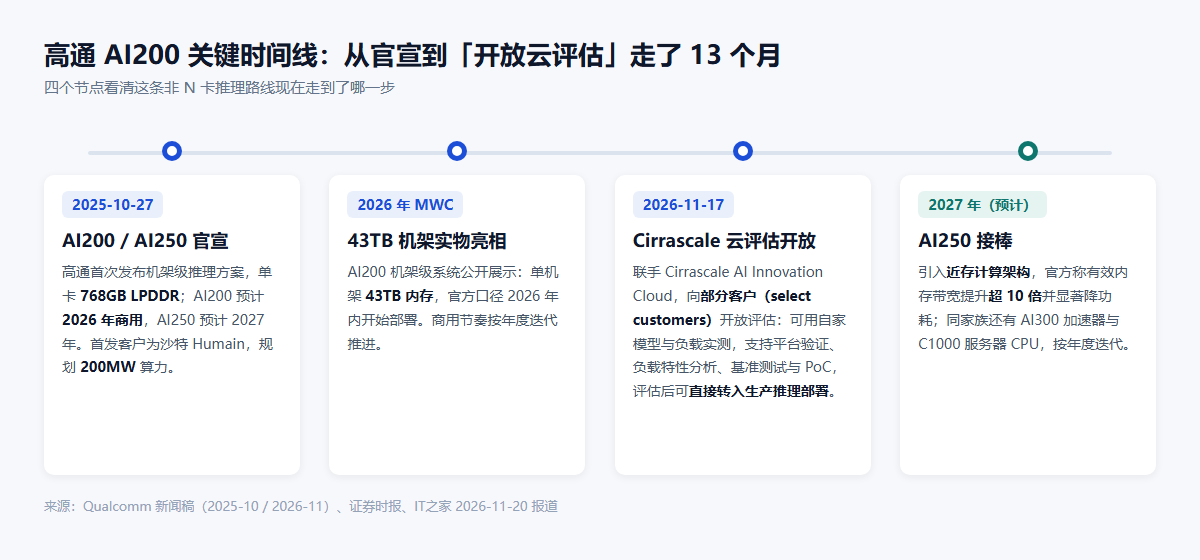
2025 年 10 月 28 日,高通官宣 AI200 与 AI250 两款机架级推理方案:AI200 预计 2026 年商用,AI250 预计 2027 年,首发客户是沙特 Humain,规划 2026 年起部署 200MW 算力。13 个月后的 11 月 17 日,AI200 通过 Cirrascale 开放评估——从「PPT 规格」走到了「可实测」。先把官方口径的规格列全:
| 维度 | 官方口径 |
|---|---|
| 产品定位 | 机架级 AI 推理专用方案,不做训练 |
| 单卡内存 | 768GB LPDDR(官方新闻稿口径;IT之家 11-20 报道写作 LPDDR5X) |
| 机架构成 | 56 卡 / 140kW 液冷 ORv3 机架(2025-10 官宣时整机架功耗口径为 160kW) |
| 单机架内存 | 43TB |
| 单机架内存带宽 | 0.414 PB/s(约 414TB/s) |
| 扩展互联 | PCIe Gen6 纵向扩展 + RoCE/以太网横向扩展 |
| 安全 | 支持机密计算(confidential computing) |
| 负载范围 | 官方称 7B~10T 参数,主打长上下文、RAG、Agent 类推理 |
| 软件 | Qualcomm AI Management Suite(配置、监控、编排、故障处理),官方称兼容主流 AI 框架;2025-10 官宣时还提过高通高效 Transformer 库与 AI Inference Suite,支持 Hugging Face 模型一键部署 |
| 商用节奏 | AI200 预计 2026 年、AI250 预计 2027 年(均为官方预计口径) |
把 13 个月的关键节点连起来看,这条路线的节奏很清楚:
为什么敢不装 HBM?「容量换带宽」这笔账要两面算
主流机架方案 NVL72 用 HBM3e 堆带宽,AI200 用 LPDDR 堆容量。LPDDR 单价远低于 HBM,省下来的钱变成了约 3.2 倍的内存总量。两台机器放在一起看:
| 维度 | 高通 AI200 机架 | NVIDIA GB200 NVL72(官网规格页口径) |
|---|---|---|
| 机架构成 | 56 张加速卡 | 72 GPU + 36 Grace CPU |
| 内存总量 | 43TB LPDDR | 13.4TB HBM3e |
| 内存带宽 | 414TB/s | 576TB/s |
| 机架功耗 | 140kW(官宣时口径 160kW) | 约 120kW(DGX GB200 用户手册口径) |
| 用途 | 仅推理 | 训推一体 |
| 机内互联 | PCIe Gen6 + RoCE 以太网 | NVLink 第五代,130TB/s 单域 |
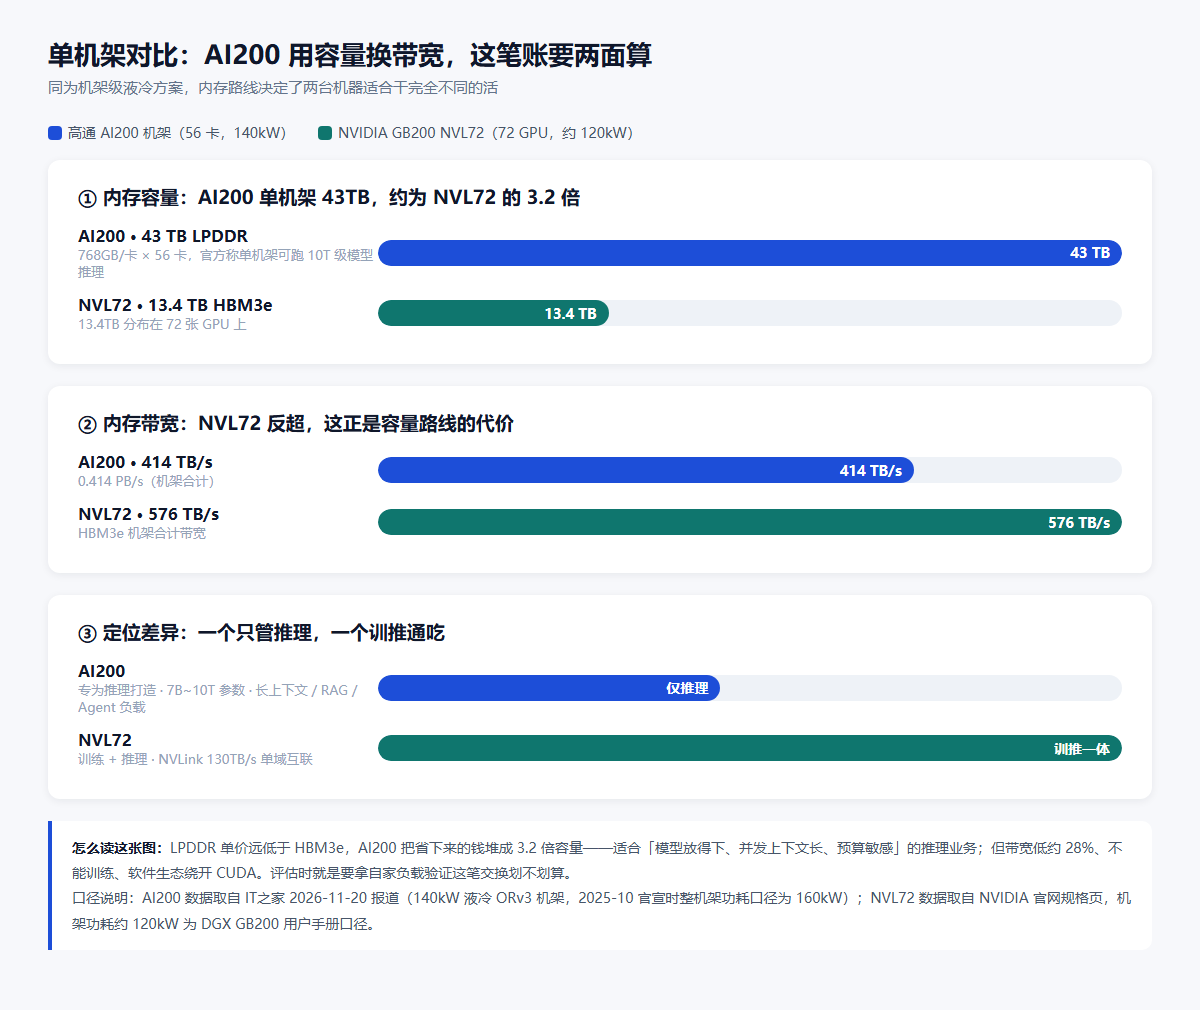
这笔账两面算:一面是容量红利——大模型推理最贵的痛点是「放不下」和「并发上下文太长」,43TB 意味着单机架塞下 10T 级模型或超长上下文后还有余量;另一面是带宽代价——414TB/s 比 NVL72 低约 28%,LPDDR 单卡带宽天然不及 HBM,token 吞吐上限大概率由带宽决定。所以「AI200 峰值吞吐打不过 NVL72」基本是明牌,高通赌的是「每美元每瓦特的推理产出」。你的业务是吞吐敏感还是容量敏感,决定了这台机器跟你有没有关系。
云评估怎么进:「select customers」的真实门槛
官方原文是 available for evaluation by select customers——不是开放注册。想碰这台机器,下面四步是现实路径:
- 找对入口:评估跑在 Cirrascale 的 AI Innovation Cloud 上,商务入口是 Cirrascale Cloud Services 与高通数据中心团队。SC26 大会(11 月 17-18 日,芝加哥,Cirrascale 展台 #1046)的线下演示已经收摊,现在只能走两家官网的联系渠道。
- 认清官方支持范围:官方写明的支持是平台验证(platform validation)、负载特性分析(workload characterization)、基准测试(benchmarking)与概念验证(PoC)四类——评估不是「给你台机器随便跑分」,把需求往这四类上靠,沟通成本最低。
- 确认评估与生产的衔接:官方明确说客户在云环境验证后可直接转入生产推理部署。也就是说评估不是孤立 POC,而是上生产的入口,值得按「未来要迁移的负载」来设计评估方案。
- 先备好负载画像再询价:费率官方未公布,Cirrascale 的商业模式是固定费率(flat-rate)、不收数据出入费用(no ingress or egress fees),价格要单独询价——别拿 GPU 云按时租的口径去套。申请前把自己业务的模型参数规模、上下文长度分布、并发档位、延迟与吞吐 SLO、量化方案整理成一份清单,下一节就是照着它验货。
评估期验什么:五项验货清单,照抄可交差
- 长上下文并发:用你的真实上下文长度(比如 32K~256K)测单机架能挂多少并发会话——这是 43TB 容量的主战场,也是这台机器相对 HBM 卡最可能有惊喜的地方。
- 吞吐下限:实测每卡每秒 token 输出,与你在 H100/H200 上的基线对齐比较。414TB/s 的带宽摆在那里,任何纸面推算都不可信,必须实测。
- 首字延迟(TTFT):容量路线对大 KV cache 友好,但带宽偏低可能拖慢 prefill——长输入场景必须单独压测。
- 软件栈落地:官方称兼容主流 AI 框架,把你生产在用的推理引擎与框架版本原样带过去跑,并确认 Qualcomm AI Management Suite 的编排、监控、故障处理能否接进现有运维体系。
- 机密计算与成本口径:有合规要求的业务,验证 confidential computing 的实际开启方式;顺便把 flat-rate 之外有没有隐藏成本问清楚。
常见翻车认知与急救清单:八个最容易想当然的点
| 想当然 | 真相 | 怎么办 |
|---|---|---|
| 「开放评估」= 谁都能注册 | 官方口径是 select customers,需商务接触 | 走高通/Cirrascale 官网联系渠道,备好负载画像再谈 |
| AI200 能顺便训练 | 官方定位推理专用,无训练口径 | 训练需求直接看别的产品线 |
| 43TB 内存 = 高吞吐 | 机架带宽 414TB/s,低于 NVL72 的 576TB/s | 吞吐只认实测,与自家基线对齐比较 |
| 功耗按 140kW 或 160kW 直接算电费 | 两版口径并存(11-20 报道 140kW,2025-10 官宣 160kW) | 评估时按当前机架配置逐项确认 |
| CUDA 生态经验能平移 | 官方称兼容主流 AI 框架,但 CUDA 专有生态不在其中 | 把生产推理引擎版本带去实测,迁移成本先算清 |
| 768GB/卡的并发参数照 HBM 卡经验填 | LPDDR 带宽下 KV cache 与并发的实际表现不同 | 并发档位按实测重标定,不照抄 N 卡调优参数 |
| 评估费用有公开价目表 | 官方未公布费率,仅知 flat-rate 且不收数据出入费 | 直接询价,别拿按时租卡价格推算 |
| 2026 商用 = 现在就能买整机 | 2026 是官方预计口径,首发大单优先消化产能 | 中小客户现实路径是云评估 → 生产部署,自建机架先掂量机房条件 |
什么人该申请、什么人先劝退
三类人对号入座适合看:一是推理为主、模型大上下文长、正被 HBM 卡租金卡脖子的云服务商与中型企业;二是做 RAG、Agent 长会话产品,对「放得下」比对「跑得快」更敏感的团队;三是想在 2026 商用窗口提前锁产能、愿意花一轮评估成本的算力采购决策者。
三类人先劝退:要训练微调的——AI200 是推理专用,没有训练口径;吞吐打榜型业务——高并发短请求、对每秒 token 极限敏感的,带宽明牌低 28%;深度绑定 CUDA 专有生态(TensorRT-LLM 全家桶、自研 CUDA kernel)的团队——迁移成本要先算清再谈。
还有一点要诚实说:本文写作时 AI200 没有任何公开的第三方实测吞吐数据,评估期内能跑到什么水平官方也未公布,以上全部是规格与定位层面的判断,最终以你自己的实测为准。
互动:你的推理业务现在跑在什么卡上?如果给你一台 43TB 的机架,第一个想验的是长上下文并发还是单请求延迟?评论区报一下负载画像,我按容量、带宽两头帮你对一对。
登录后可点赞、收藏与反馈。


