RPA 开发者别照抄纯 Agent 教程:固定段沉淀脚本的三步分工法(火山引擎 MUA 实测拆解)
纯 Agent 教程让整条流程都烧模型,纯 RPA 教程又当大模型不存在。以火山引擎 MUA 三种执行模式为骨架,拆解固定段沉淀脚本、动态段留给模型的三步分工法,含实测口径、判断表与报错急救清单。
你可能也刷到过这类教程:一半教你「用 Agent 替人操作手机电脑」,一半教你「RPA 已经过时」。但真正在企业里做自动化的人都卡在一个中间地带——流程里七八成的步骤天天一模一样,剩下两三成要理解当天的新数据。照抄纯 Agent 教程,把整条流程都交给模型在线决策,结果就是一条每天重复跑的巡检任务,每次都从手机桌面开始重新规划,Token 和时间双烧,还不稳定;照抄纯 RPA 教程,又处理不了页面里天天变的那部分。
这条路线是走得通的。火山引擎的 MUA(Mobile Use Agent,跑在云手机上替企业操作 Android App)把这件事拆成了三种执行模式:AgentRun 在线决策、ScriptRun 沉淀固定脚本、ChainRun 把两者串成一条任务。厂商 2026-11-19 发布的单组实测口径是:同一台云手机、同一巡检目标,把固定入口脚本化后,收益主要体现在模型用量上——固定导航不再重复规划,整条任务耗时基本持平。也就是说,省的是钱和模型调用,不是速度。
本文用这套三模式框架做骨架,把「哪些步骤该沉淀成脚本、哪些留给模型、翻车了怎么救」一次讲清。用影刀、UiPath 的读者也不用换工具,第四节给了对应做法——分工思路是通用的。
纯 RPA 教程和纯 Agent 教程,各错在哪?
先说清两种主流教程的盲区,你才知道自己该抄哪部分:
| 维度 | 纯 Agent 路线(网上最热) | 纯 RPA 路线(企业存量) | 混合执行路线 |
|---|---|---|---|
| 固定步骤 | 每次重新感知、规划、定位 | 按录制路径稳定执行 | 沉淀脚本复用,不调模型 |
| 动态内容 | 能理解、能判断 | 处理不了,页面一变就断 | 交给 AgentRun 在线判断 |
| 模型用量 | 整条流程全烧 Token | 为零 | 只烧动态段,固定段零推理 |
| 失败表现 | 路径不确定,可能绕路或卡住 | 定位失效直接报错停 | 节点失败即停,状态可核对 |
| 适合谁 | 一次性、探索性任务 | 规则完全固定的老系统 | 每天重复、内容每天变的巡检类任务 |
一句话:RPA 擅长执行,Agent 擅长思考,企业真正缺的是把两者接在同一根流程里的编排层。这也是研究机构提出 APA(Agentic Process Automation,智能体流程自动化)的核心含义——不是谁取代谁。
AgentRun、ScriptRun、ChainRun 三种模式怎么分工?
火山引擎 MUA 文档里这三种模式是并列的运行选项,对应三种完全不同的执行逻辑:
| 模式 | 执行逻辑 | 调大模型? | 典型用途 |
|---|---|---|---|
| AgentRun | 给目标,模型按当前页面自主决定每一步:感知 → 规划 → Grounding 定位 → 执行 → 核对 | 是 | 首次跑通、动态内容读取、未知分支处理 |
| ScriptRun | 按已定义的动作、定位规则与条件调用设备接口,支持 XML 控件属性、无障碍标签、OCR、图像匹配定位 | 否 | 开 App、进固定入口、已知导航 |
| ChainRun | 按编排的工作流节点串行执行:脚本节点跑规则,Agent 节点跑观察与决策闭环 | 仅动态节点 | 完整业务任务:固定入口 + 动态读取 |
三个细节值得注意:ScriptRun 的定位每次执行都重新找目标,不是死坐标回放;已知弹窗可以用条件判断处理,页面加载设有限等待,滚动查找限定次数和时间;脚本终点用断言校验(比如「标题出现」「城市是北京」),让结束状态可检验。这三条是脚本能不能稳定复用的生命线。
三步改造法:从一次跑通到每天自动巡检
拿一个无需登录的典型任务举例:每天在云手机上打开浏览器,进中国天气网北京 7 天预报页,采集未来三天的日期、天气、最高/最低温、风力,昼夜温差大就提醒增减衣物,页面没有的字段明确标注,最后整理成当天巡检结果。
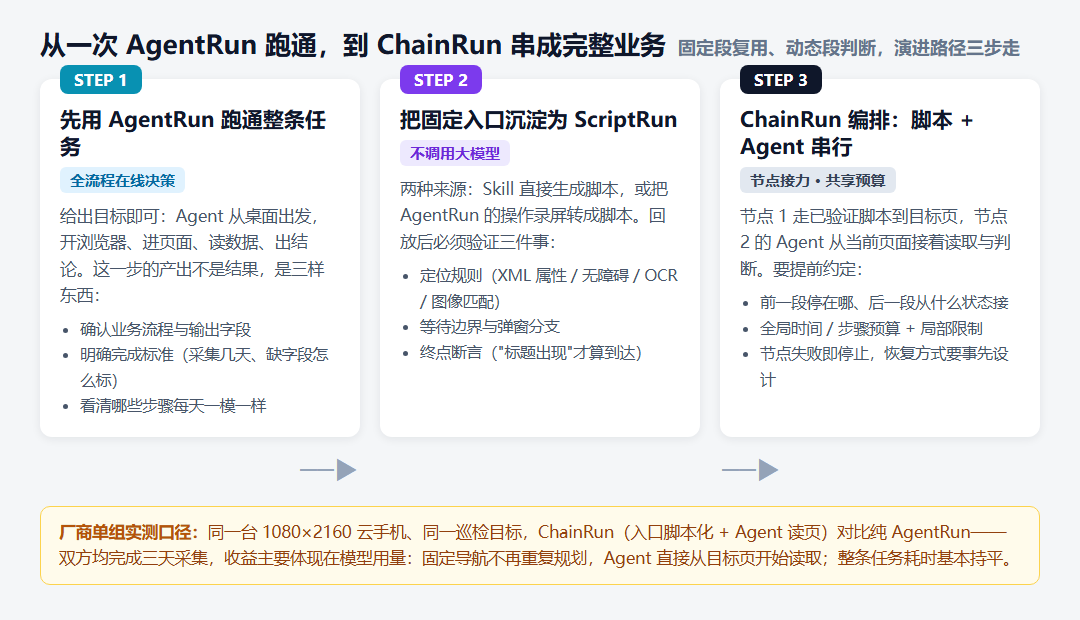
第一步:用 AgentRun 跑通整条任务。这一步的产出不是结果,是三样东西——确认业务流程与输出字段、明确完成标准(采集几天、缺字段怎么标)、看清哪些步骤每天一模一样。实测里有个典型坑:页面同时展示逐日预报、分时预报和实时温度,Agent 需要把日期和最高/最低温正确配对,别拿实时温度冒充预报值。2026 年 11 月 11 日的实机画面里,前三天的最高/最低温分别是 14/1℃、16/1℃、15/1℃,风力均小于 3 级。
第二步:把固定入口沉淀为 ScriptRun。「打开浏览器 → 输入网址 → 进入北京预报页」这段天天不变,两种来源可以生成脚本:Skill 直接生成,或把这次 AgentRun 的操作录屏转成脚本。生成后在同一台云手机上回放验证,用 OCR 检查「北京天气预报」标题出现、再核对页面截图。验证通过后,这段路径的执行不再调用大模型。
第三步:配置 ChainRun,串起完整巡检。把已验证的导航脚本设为第一个节点,预报采集、建议与核验设为第二个 Agent 节点。配置时要提前约定三件事:前一段停在哪里、后一段从什么状态接;各节点的完成条件;全局剩余时间与步骤预算(也支持节点局部限制)。之后每天巡检,只要浏览器布局和页面前提仍成立,就沿用导航脚本,由 Agent 读取新预报、给出新建议。
哪一段该沉淀、哪一段留给模型,这张判断图四个问题过一遍:
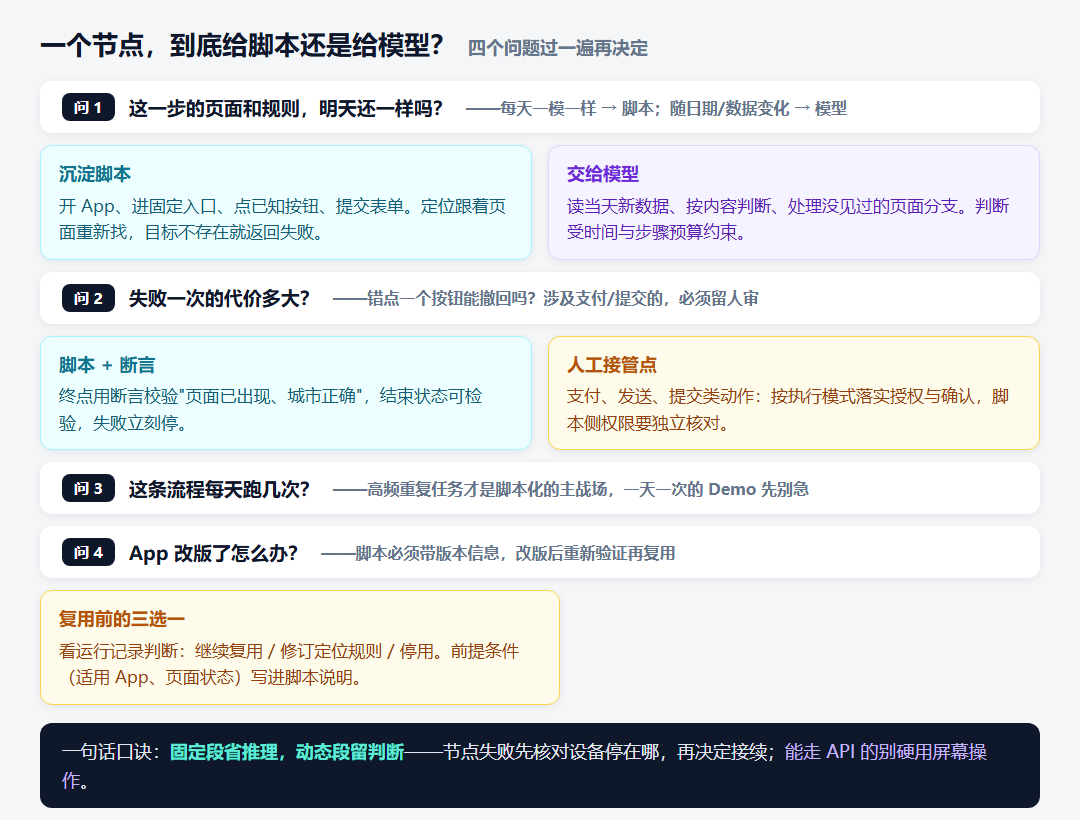
一个节点给脚本还是给模型?四个问题过一遍
不是所有固定步骤都值得沉淀,也不是所有动态内容都必须交给模型。每个节点配之前,过这四个问题:
- 这一步的页面和规则,明天还一样吗?每天一模一样 → 脚本;随日期、数据变化 → 模型。
- 失败一次的代价多大?涉及支付、发送、提交类动作,按执行模式落实授权与确认环节,脚本侧权限控制要独立核对——这类节点先想人工接管点,再想自动化。
- 这条流程每天跑几次?高频重复任务才是脚本化的主战场。一天跑一次的 Demo,先让 AgentRun 多跑几天再决定沉淀哪段。
- App 改版了怎么办?脚本必须保留适用应用、页面前提、输入、终点和版本信息,改版后重新验证,再决定继续复用、修订定位规则还是停用。
厂商给的经验是:从高频、输入输出清晰、结果可核验的任务开始——天气巡检、商品调研、业务查询都是好起点。把运行记录里的成功率、耗时、用量和失败原因放在一起看,再逐步扩大覆盖。
影刀、UiPath 用户怎么对应这套思路?
三模式不是火山引擎独有概念,主流 RPA 平台都在往同一个方向走:
- 影刀 RPA:官方口径是「AI 做大脑、RPA 做手脚,同一根流程里接力」——流程走到需要思考的断点交给 AI 工作流,判断完交还 RPA 继续执行。其「AI 操作屏幕」作为指令嵌入 RPA 流程,官方称智能元素让元素报错率降低 70%、维护成本降低 30%(厂商口径)。对应关系:RPA 节点 ≈ ScriptRun,AI 断点 ≈ AgentRun。
- UiPath:2025 年 8 月行业报道其推出 Maestro Flow 编排平台,把传统 RPA 和 agentic AI 接在同一条流程里——老牌厂商自己认了「光靠 RPA 不够,光靠 Agent 也悬」。
- 自建团队:微信生态多篇架构文给的分层是「Agent 层理解决策 → Workflow 层编排路由 → RPA 层执行」,LangGraph、Dify Workflow、n8n 做编排层,UiPath、影刀做执行层。
差异点在于:MUA 这类云手机方案主攻 Android App 场景(内容平台运营、商家版 App、舆情巡检、移动端调研),云手机解决了登录态保留、账号隔离、按需并发这三件本地模拟器头疼的事;影刀、UiPath 主攻 PC 桌面与 Web。两边思路同构,选型先看你业务发生在哪块屏幕上。
常见翻车报错与急救清单
以下现象都出自实测流程中的真实边界,遇到直接对号入座:
| 现象 | 原因 | 解法 |
|---|---|---|
| 脚本回放报「目标不存在或无法消歧」 | 定位规则太窄,或页面没加载完 | 加区域、属性或顺序消歧;设有限等待;仍失败返回,人工核对页面 |
| Agent 把实时温度当成了预报值 | 页面同时有分时预报和实时温度两块 | 任务描述里明确「取逐日预报的最高/最低温,与日期配对」,禁止用实时温度替代 |
| 弹窗挡住了要点的控件 | 未知弹窗不在脚本条件分支里 | AgentRun 会随新观测调整;脚本侧只能处理已知弹窗,超范围即停——这是设计行为,别硬扛 |
| ChainRun 中途停下,后续节点没跑 | 节点失败即停止,这是当前机制 | 先核对设备停在哪个页面,再决定接续方式;恢复方式要在编排时事先设计 |
| 云手机遇到人脸识别验证卡住 | 登录银行/支付类 App 触发风控 | 官方流程:云手机画面弹二维码 → 自己的手机扫码 → 手机端完成人脸识别 → 回控制台重连 |
| App 改版后脚本全挂 | 定位规则基于旧页面结构 | 看运行记录决定复用、修订还是停用;没写版本信息的脚本当作不可复用处理 |
| 滚动查找一直找不到目标 | 未限定滚动次数和时间 | 滚动查找限定次数与时间,超限停止,避免死循环烧时间预算 |
什么场景该劝退?
客观说清边界,免得你拿错刀切错菜:
- 有 API 就别硬用屏幕操作。系统能给你结构化数据,就没必要让模型看截图猜按钮——屏幕操作是留给「没有 API 或 API 覆盖不到消费者可见页面」的场景。
- 一次性任务别沉淀脚本。沉淀脚本有验证成本,跑一次就结束的任务,直接 AgentRun 更划算。
- MUA 面向 Android 云手机,你的业务在 PC 桌面/浏览器就去看同厂的桌面端 Agent(CUA)路线或影刀、UiPath。
- 纯规则老系统(比如只做固定报表导出)继续用纯 RPA,加模型只是增加不确定性。
- 本文实测数据是厂商单组口径(掘金 2026-11-19 发布),你的任务结构、页面复杂度不同,省的 Token 比例会不一样,动手前先拿自己的任务跑一组 AgentRun 基线对比。
总结成一句口诀:固定段省推理,动态段留判断,失败先核对状态再接续。三步改造法的精髓不是用某个产品,而是养成「先跑通、再沉淀、后编排」的习惯——这条路径影刀用户、UiPath 用户、云手机用户都通用。
你手头那条「想自动化又不敢全自动」的流程,哪一段是天天不变的?用哪家工具、卡在哪一步报错?评论区报配置,我帮你判断该沉淀还是该留给模型。
登录后可点赞、收藏与反馈。


