锐龙 AI 薄本跑本地智能体:卡人的不是显存,是驱动和内存
没有独显的锐龙 AI 笔记本也能挂常驻 Agent,但 Ollama 和 llama.cpp 看不到 NPU。这篇拆清机型怎么对号、内存要多少、Windows 与 Linux 各卡在哪,并给出五道闸自查顺序与九条报错对照。
11 月 19 日 AMD 宣布,XDNA 2 成为首个被 Unsloth Desktop 支持的 NPU,一百多款智能体应用可以直接把请求指到笔记本里那颗芯片上。消息一晚上铺满时间线,但真拿一台锐龙 AI 轻薄本去点「Enable NPU」的人,遇到的多半是另一套剧本:按钮是灰的、模型下载停在 37% 不动、flm run 甩一句 No such device with index '0'。
更常见的误区是回头装 Ollama。它确实能在同一台机器上跑起来,但跑的是 CPU 或核显——NPU 占用曲线从头到尾是一条 0。这不是参数没调对,是 Ollama 和 llama.cpp 至今没有 XDNA 后端,请求根本到不了那颗芯片。
这条路是通的,只是窄。官方给的数字:Qwen3.5-9B 9.5 tok/s、Gemma4-12B 6.8 tok/s、Qwen3.6-35B-A3B 17.2 tok/s,首 token 1.05~3.13 秒。下面按「机型对不对 → 内存够不够 → Windows 怎么点 → Linux 怎么过闸 → Agent 怎么接」的顺序拆,末尾给一张报错对照表。
为什么 Ollama 跑得动,却摸不到 NPU
模型文件是同一份 GGUF,差的是中间那层推理运行时。Ollama 和 llama.cpp 的后端列表里只有 CPU、CUDA、ROCm、Vulkan,没有 XDNA;NPU 的算子要由 FastFlowLM(FLM)编译成专门的 kernel 才能跑。所以「装个 Ollama 就能用 NPU」这个预期,从架构上就不成立。
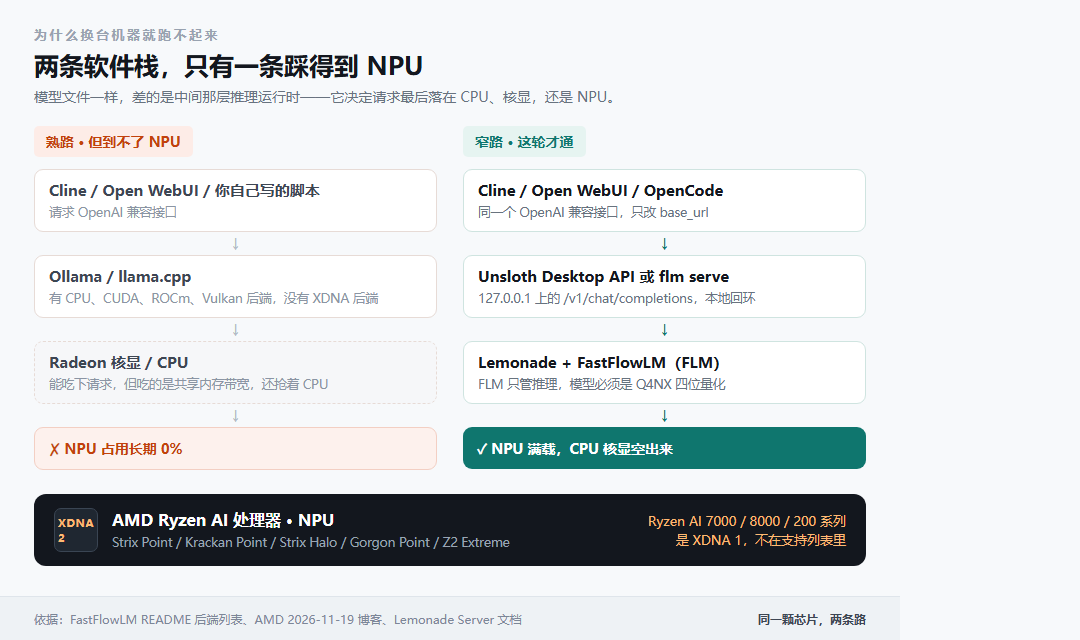
真正的调用链是四段:应用发 OpenAI 兼容请求 → Unsloth Desktop API 或 flm serve 接住 → Lemonade 与 FLM 负责模型服务和推理 → 落到 XDNA 2 NPU。应用侧只认 base_url,所以 Cline、Open WebUI、OpenCode、Hermes Agent 这类工具改一行配置就能换过来,这也是「一百多款应用」这个数字的来源。
三条路线怎么分工
| 路线 | 推理由谁跑 | 模型格式 | 吃得到 NPU | 适合谁 |
|---|---|---|---|---|
| Ollama / llama.cpp | 自带后端,落到 CPU 或核显 | GGUF | 否 | 只要「能跑」,不在乎功耗和占用 |
| Unsloth Desktop | Lemonade + FastFlowLM | NPU 分区为 Q4NX | 是 | 不想碰命令行,点几下就要能用 |
| FastFlowLM CLI | FLM 本体 | Q4NX | 是 | 要脚本化、要接进自己的服务 |
| Lemonade Server | NPU 走 FLM,GPU 走 llama.cpp | 两种都收 | 是 | 一台机器上要同时管 NPU 和独显 |
Q4NX 是硬约束。FLM 的 NPU 引擎只吃这种四位量化格式,手头的 GGUF 再小也塞不进去。Unsloth 的 Export 页能转,标准路径是 Q4_K_M,转换跑在 CPU 上。但这一步官方口径还没收敛:FAQ 说自定义转换的模型不能直接从 NPU 列表加载,更新日志又说可以——稳妥点从 Trained 页加载。
第一道坎:你的「锐龙 AI」可能是 XDNA 1
这是最容易白忙一晚的坑。AMD 把「Ryzen AI」这个名字用在了两代 NPU 上,只有 XDNA 2 才在这轮支持列表里:
- Ryzen AI 300 系列:Strix Point、Krackan Point(Kraken Point 同架构)
- Ryzen AI Max:Strix Halo,也就是那批 128GB 统一内存的机器
- Ryzen AI 400 系列:Gorgon Point
- 掌机:Z2 Extreme 这类带 XDNA 2 的整机也在支持范围内
反过来说,Ryzen AI 7000、8000、200 系列是 XDNA 1,不在这轮支持里。同样是「AI 后缀」的轻薄本,差一代就是从头到尾跑不通。判断方法很土但很准:打开任务管理器 → 性能,看有没有「NPU」这一栏。没有,就不是驱动没装,是硬件本身不在名单上,后面所有步骤都可以省了。
第二道坎:32GB 只够 9B,35B 要 64GB
NPU 没有独立显存,它和核显共用系统内存。AMD 给的算账方式是:Qwen3.6-35B-A3B 跑全上下文,大约要 28GB 可供 NPU 使用的内存;Windows 默认把一半内存划作共享分配,所以整机得 64GB 才稳。按这个比例倒推,32GB 机器的 NPU 侧大约只有 16GB 可用。
| NPU 模型 | 文件大小 | 建议整机内存 | 生成速度 | 首 token |
|---|---|---|---|---|
| Qwen3.6-35B-A3B(MoE) | 20.6GB | 64GB | 17.2 tok/s | 3.13s |
| Qwen3.8-27B(MTP) | 18.1GB | 48GB | 2.0 tok/s | 3.80s |
| Gemma4-12B-IT | 8.7GB | 32GB | 6.8 tok/s | 1.70s |
| Qwen3.5-9B | 7.6GB | 32GB | 9.5 tok/s | 1.11s |
| Qwen3-VL-4B-Instruct | 未公布 | 16GB | 20.5 tok/s | 1.05s |
| LFM3-1.7B | 1.5GB | 16GB | 40.7 tok/s | 0.12s |
表里最值钱的一行不是 35B,是 27B 那个 2.0 tok/s。27B 比 35B 小,速度只有它的九分之一,因为前者是稠密模型、后者是 MoE——A3B 每 token 只激活约 30 亿参数,权重还得全放进内存,但每次读的少。在这类统一内存架构上,先挑 MoE,再挑稠密,这条比看参数量重要得多。
速度这组数字得看清楚口径:官方没有公布测试机型、上下文长度和 NPU 电源模式(默认是 Performance 档),也没有对比同机型核显的功耗。它只能用来横向自比,别拿去做「NPU 比某张显卡快」的结论。同样,「每 token 能耗低 2~4 倍」也是厂商口径,没有点名对比哪张 GPU、怎么测的。
Windows 这条路:先更新驱动,再点三下
FastFlowLM 把驱动门槛写得很死:NPU 驱动要 32.0.203.311 或以上,低于此版本不再支持。查版本的位置是设备管理器 → NPU 设备 → 属性 → 驱动程序,或者任务管理器 → 性能 → NPU 看驱动版本。低了过去跑 Windows Update,或者去 AMD 官网按型号下。
驱动到位之后,图形界面这条路最省事:装 Unsloth Desktop → 进 Model Hub → 点筛选图标,下拉里选 NPU → 点 Enable NPU(它会顺手下 FLM 并检查驱动)→ 下载要用的 NPU 模型 → 回 New Chat,在下拉里往下滚,找到 NPU 分区那条,按需要的上下文加载。
要脚本化就用 FLM 本体。装完 flm-setup.msi 之后在 PowerShell 里:
# 先确认 NPU、固件、memlock 三项状态
flm validate

# 直接对话,模型不存在会自动拉
flm run qwen3.5:9b

# 起一个本地 OpenAI 兼容服务,默认端口 52625
flm serve qwen3.5:9b

# 下载损坏时强制重拉(比删目录重来快)
flm pull qwen3.5:9b --force
模型默认落在 C:\Users\<用户名>\.flm\models\,安装时可以改盘符。两个小开关值得记:FLM_MODEL_PATH 换模型目录(Linux 侧常用),FLM_DISABLE_UPDATE_CHECK=1 关掉启动时的版本检查,离线环境能少等几秒。
「下载卡住」是最常被误判的故障。进度条停在某个百分比不动,多半不是挂了,是在从 HuggingFace 拉 NPU 内核。网络受限的话手动把模型放进
.flm/models,或者flm pull <tag> --force重拉一次。
Linux 这条路:五道闸,少一道就报 device index
AMD 明确说过,这套东西在 Linux 版 Unsloth Desktop 上同样可用,不是 Windows 专属。但 Linux 的前置条件更硬,而且失败时的报错不会告诉你缺哪一环。按顺序过,每道闸都有能自己验证的通过标准:
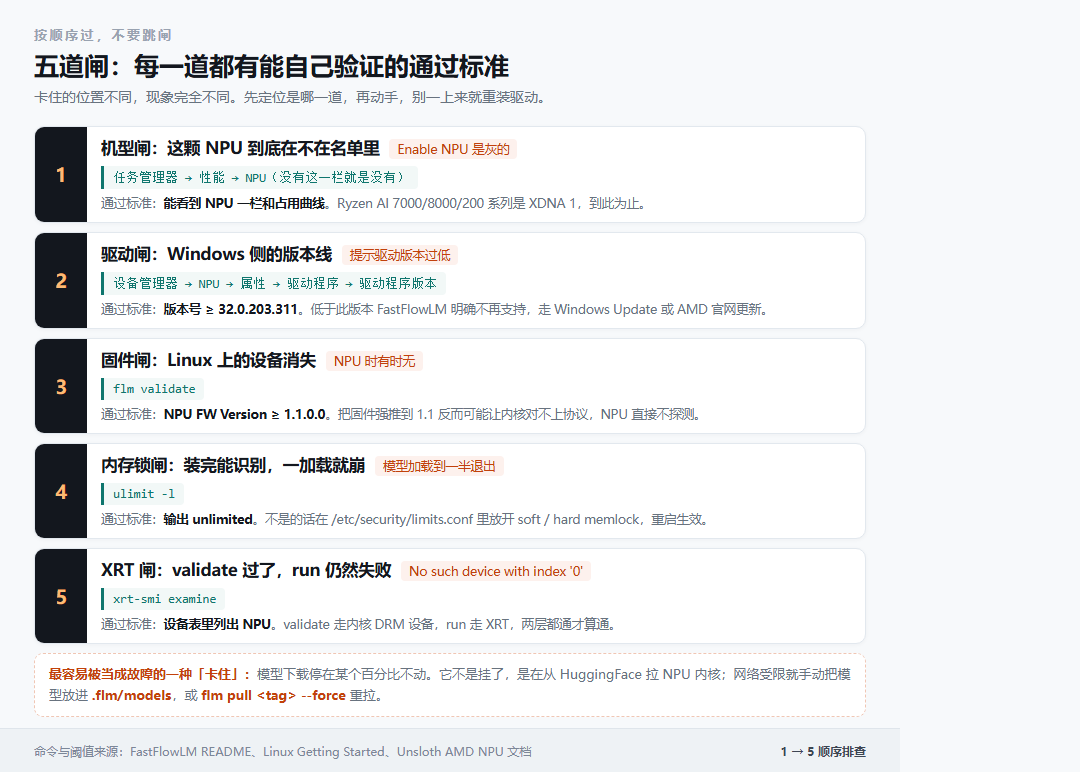
Ubuntu 24.04 / 25.10 上的最小路径是四步:加 ppa:lemonade-team/stable → sudo apt install libxrt-npu2 amdxdna-dkms → 重启 → 装 FastFlowLM 的 deb 包。内核侧要么是 7.0 以上自带 amdxdna,要么用 dkms 补;固件要 1.1.0.0 以上;memlock 必须是 unlimited。
# 三项一起看:内核、NPU 设备节点、固件版本、memlock
flm validate
# [Linux] Kernel: 7.0.0-rc1
# [Linux] NPU: /dev/accel/accel0
# [Linux] NPU FW Version: 1.1.2.64
# [Linux] Memlock Limit: infinity

# memlock 不是 unlimited 时
ulimit -l
# 在 /etc/security/limits.conf 追加:
# * soft memlock unlimited
# * hard memlock unlimited
最容易漏的是第五道闸。flm validate 走的是内核 DRM 设备节点,flm run 走的是 XRT,两层是分开的。所以会出现「validate 全绿,run 还是 No such device with index '0'」这种看着自相矛盾的情况——修法是确认装了 XRT 的 amdxdna 插件,再跑 xrt-smi examine,设备表里能看到 NPU 才算通。
Arch 用户还要多看一眼:modinfo -F filename amdxdna 要指向 updates/dkms 下的模块,指向 kernel/drivers/accel/amdxdna/ 说明还在用内核自带的那份。另外有个反直觉的坑:把 npu.sbin.zst 强行指到 1.1 固件,反而会让内核态驱动探测失败、NPU 直接消失,因为旧内核等的是老协议。要么用 dkms 驱动配 npu_7.sbin.zst,要么换带新驱动的内核,别硬改符号链接。
接 Agent:改一个 base_url 就行
两条服务都能给出 OpenAI 兼容端点,区别在端口和鉴权:FLM 自带服务默认 52625;Lemonade 默认 13305,路径是 /api/v1,设了 LEMONADE_API_KEY 就走 Bearer 头,没设的话客户端随便填个占位值也能过。
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:52625/v1",   # Lemonade 则换成 13305/api/v1
    api_key="local",                        # 本地服务不校验,占位即可
)

print(client.chat.completions.create(
    model="qwen3.5:9b",
    messages=[{"role": "user", "content": "把这段会议记录压成三条待办"}],
).choices[0].message.content)
Cline、Open WebUI、OpenCode 这类客户端同理:选 OpenAI Compatible,base_url 填上面那个,模型名填 FLM 的 tag(qwen3.5:9b、qwen3.6-moe:35b-a3b 这种,用 flm list 能看到全集)。注意两点:服务只监听本机回环,局域网里别的设备连不上,要共享得自己开 LAN 访问;卸载模型才会释放 NPU,退出 Unsloth 则连托管运行时一起停。
常见翻车报错与急救清单
| 现象 | 大概率原因 | 怎么处理 |
|---|---|---|
| Enable NPU 是灰的 / 筛不出 NPU | 机型是 XDNA 1(Ryzen AI 7000/8000/200)或驱动缺失 | 任务管理器看有没有 NPU 栏;没有就是硬件不支持 |
| 提示驱动版本过低 | 驱动低于 32.0.203.311 | Windows Update 或 AMD 官网更新,重启后再试 |
| 模型下载停在某个百分比 | 正在拉 NPU 内核,或 HuggingFace 不可达 | 先等;再不行手动放 .flm/models 或 flm pull --force |
flm validate 报固件版本低 | 固件低于 1.1.0.0 | 更新 NPU 固件;别硬把符号链接指到 1.1 |
| 加载到一半退出 / 权限报错 | memlock 不是 unlimited | limits.conf 放开 soft / hard memlock 后重启 |
validate 通过,run 报 No such device with index '0' | XRT 看不到 NPU | 装 XRT 的 amdxdna 插件,用 xrt-smi examine 确认设备表 |
| 回答正常,但 NPU 占用一直是 0 | 模型没在 NPU 分区加载,回落到 CPU 或核显 | New Chat 下拉里选 NPU 分区那条;命令行别用 ollama |
| 35B 一加载就内存不足 | 全上下文要 28GB 给 NPU,32GB 机器只有约 16GB | 降到 9B / 12B,或换 64GB 机器 |
| 自己转的 Q4NX 在 NPU 列表里找不到 | 官方 FAQ 与更新日志口径未收敛 | 从 Trained 页加载,别指望出现在 NPU 分区 |
什么情况下别走这条路
先把劝退的说清楚,省得折腾两晚再放弃:
- 要 30B 以上稠密模型的质量:27B 稠密在 NPU 上只有 2.0 tok/s,写代码时会等到怀疑人生,这类需求老实上独显或云。
- 要读整个代码仓库:
qwen3.8-mtp:27b的上下文只有 16,377,256k 长上下文只在qwen3.5全系、qwen3.6-moe、qwen3vl-it这些型号上才有。 - 要微调或训练:这轮打通的是推理,训练和图像/视频生成仍然走 Radeon 独显那条路。
- 要多人共用:这是单机单用户的桌面路径,别把它当推理服务器。
- 还在 Windows 10:要求 Win11;Linux 侧则要 7.0 内核或 dkms,发行版太老会一路卡在驱动。
它最合适的场景很具体:一台 32GB 的锐龙 AI 轻薄本,白天写代码、晚上挂一个常驻的整理 Agent,不插电也想让它干活,又不想核显被占住导致外接屏掉帧。「低功耗常驻」才是 NPU 的位置,不是拿来比 tok/s。
站内 RX 6000 在 Windows 上没有 ROCm 的四条路写的是独显的困境,这篇是核显本的另一半:独显拼算力和显存,NPU 拼内存容量和驱动版本。
你手上是哪一颗?把「任务管理器 → 性能」里有没有 NPU 那一栏、以及 flm validate 的前四行贴到评论区,我帮你判断卡在第几道闸。
登录后可点赞、收藏与反馈。


