扫描件提取不出文字:AI 档案检索上线前先查这四步
开源档案系统 JitArchives 明确标注:图片型扫描 PDF 提不出正文,进不了 AI 检索。本文给中小单位四步自查:判 PDF 有没有文字层、对照档案数字化验收口径补 OCR、按查询词特征选词法或向量检索、把 AI 权限收到只读。
日前开源的电子档案系统 JitArchives,项目说明里有一句容易被略过的话:图片型扫描 PDF 上传后无法提取正文,这类文件不会进入 Agent 检索和全文检索范围。这句话基本概括了中小单位上 AI 档案检索的真实结局——败因通常不是模型不够强,而是存量档案里根本没有字。上线之前按下面四步自查,能避开绝大多数无效投入。
第一步:分清手上的 PDF 是哪一种
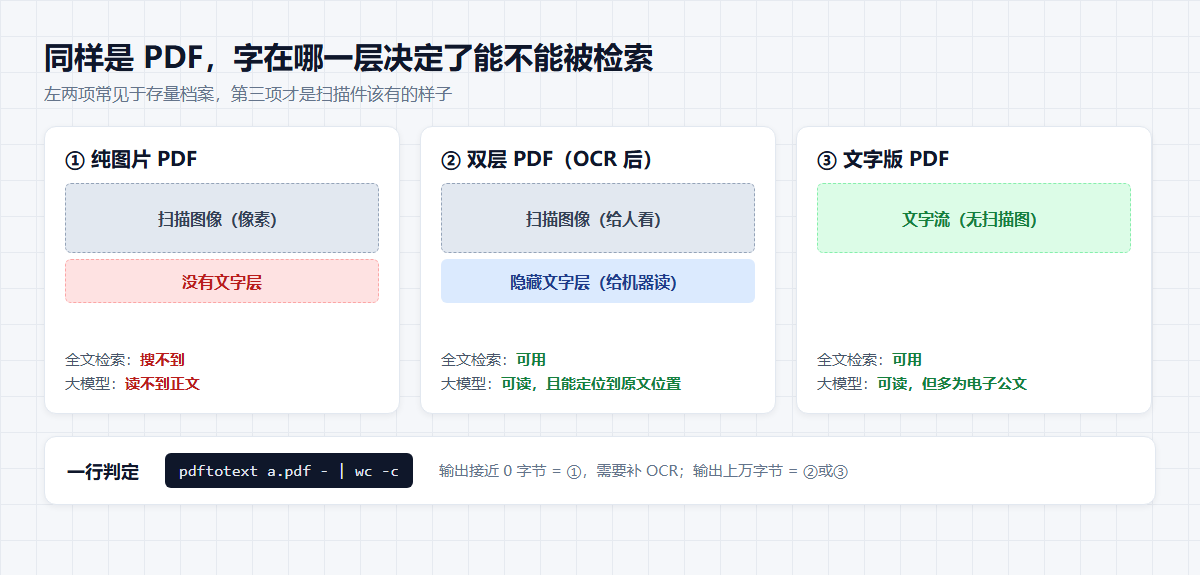
存量电子档案通常是三种形态之一,差别只在「字在哪一层」。判定只需要几行命令,用 Python 的 pypdf 统计整本 PDF 能提取出的字符数:
from pypdf import PdfReader
r = PdfReader("a.pdf")
n = sum(len((p.extract_text() or "").strip()) for p in r.pages)
print(len(r.pages), "页", n, "字符")
输出接近 0 字节就是纯图片 PDF,需要补 OCR;输出上万字节说明有文字层。装了 poppler 工具的 Linux/macOS 环境也可以用 pdftotext a.pdf - | wc -c,或用 pdffonts 交叉确认——只输出表头、没有字体条目,说明没有嵌入字体,基本可判定为纯图片。建议对全库批量跑一遍,得出「有字档案」的占比,这个比例直接决定后面要补多少 OCR。
| 形态 | 文字层 | 全文检索 | 大模型问答 |
|---|---|---|---|
| 纯图片 PDF | 没有 | 搜不到 | 读不到正文 |
| 双层 PDF(OCR 后) | 有(隐藏文字层) | 可用,能定位原文 | 可读 |
| 文字版 PDF | 有(文字流) | 可用 | 可读,多为电子公文 |
第二步:对照验收口径,确认 OCR 这一环没被省掉
扫描件没有字,多数不是技术难题,而是数字化交付时省了环节。档案行业的两份标准早就把这件事写死:DA/T 31-2017《纸质档案数字化规范》管扫描参数,DA/T 77-2019《纸质档案数字复制件光学字符识别(OCR)工作规范》管文字识别。后者明确要求 OCR 成果同时保存纯文本和双层 PDF/OFD——图像层给人看,隐藏文字层给机器读,这样才能全文检索、能复制、能定位到原文。
这一要求也常见于各地采购公告的验收口径。以毕节市财政局 2025 年度文书档案整理归档服务公告为例:扫描分辨率 300DPI 真彩色,长期储存 TIFF,挂接用双层 PDF,印刷文字识别准确率不低于 98%,倾斜度纠正不超过 1 度。如果你的存量档案只有 JPG/TIFF 图片、没有双层 PDF,那不是 AI 的问题——先找原外包方补 OCR 交付物,再谈上系统。
第三步:算清词法检索够不够,再决定要不要上向量
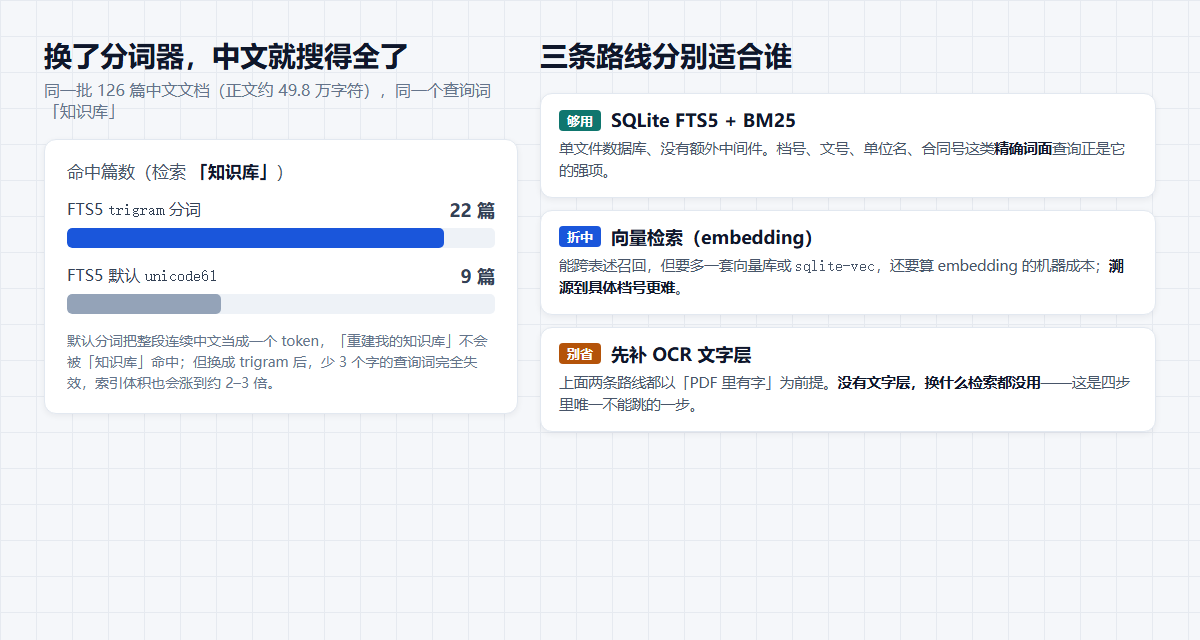
档案场景的查询大多是精确词:档号、文号、单位名、合同号、人名、年度。这类查询恰好是词法检索的强项——SQLite 内置的 FTS5 配 BM25 排序,单文件数据库、没有额外中间件,一台普通办公机就能维护。JitArchives 走的就是这条路线:正文检索用 FTS5 + BM25 + 中文 Bigram,图谱相似度用 TF-IDF,不依赖独立向量库和图数据库。
但 FTS5 中文有个静默坑:默认 unicode61 分词器把整段连续汉字当成一个 token,搜「知识库」命中不了「重建我的知识库」这类长句里的出现。SQLite 3.34 起内置的 trigram 分词器按三字符滑窗切分,天然支持中文子串匹配。一位开发者对 126 篇中文文档(正文约 49.8 万字符)的实测:同一个查询词,trigram 命中 22 篇,unicode61 只命中 9 篇。代价也要清楚:少于 3 个字的查询词完全失效,索引体积明显膨胀(两份第三方实测约 2–3 倍),两字词要退回 LIKE 兜底。
| 路线 | 部署成本 | 中文效果 | 语义泛化 | 适合 |
|---|---|---|---|---|
| FTS5 默认 unicode61 | 最低 | 连续汉字整段成一个 token,基本不可用 | 无 | 纯英文正文,或入库前已自行分词 |
| FTS5 trigram | 低,索引约 2–3 倍 | 3 字以上子串可命中,2 字词需 LIKE 兜底 | 无 | 档号、文号、人名等精确查询 |
| 向量 embedding | 高:向量库或 sqlite-vec 加算力 | 好 | 有 | 口语化提问、跨表述召回 |
什么时候必须上向量:提问是口语化的、跨表述的(「采购合同」要召回「买卖协议」),或者要做跨文档归纳。向量方案能补词法的盲区,但要多维护一套中间件,且召回片段溯源到具体档号的成本更高。中小单位的务实做法是先跑通词法,用真实查询词抽样测召回,不够再补向量,而不是一上来就堆全栈。
第四步:OCR 补录时,先抽 30 页验收再全量跑
补 OCR 有三条路:扫描仪自带软件、开源方案(PaddleOCR、Tesseract 等)、按页计费的云 OCR 服务(价格以厂商当期页面为准)。无论哪条,准确率都取决于前置图像质量——这也是 DA/T 31 要求 300DPI、纠偏不超 1 度、去黑边的原因;印章、表格、手写批注会明显拉低识别率,DA/T 77 对表格分析和印章分析还有单独要求。
- 抽样:从全库抽 30 页,必须包含表格页、印章页、手写页各若干,人工比对字符准确率。
- 达标线:参照 98% 的验收线;达不到先调预处理(分辨率、纠偏、去噪),不要直接全量跑。
- 成果保存:按 DA/T 77 的成果要求,同时存纯文本和双层 PDF/OFD,纯文本以档号命名——之后换任何检索方案,都不用重跑 OCR。
AI 侧三条硬约束:只读、带出处、权限在服务端
档案是凭证:知识库答错可以改,档案答错是合规事故。JitArchives 的做法值得直接抄:Agent 只通过服务端注册的只读工具访问数据,不执行任意 SQL、没有档案业务写权限;回答必须给出来源档案、附件与正文定位,证据不足或权限校验失败时走 fail-closed 策略,不生成没有依据的档案事实;权限判断全部在服务端,前端隐藏按钮不算权限控制。
还有一个容易被忽略的设计:全文索引和图谱都是派生数据,与原始档案分开存,索引损坏可以基于原件全量重建。给大模型喂的也应该是权限过滤后的检索片段,而不是让它直连数据库或文件目录。
边界:什么时候别用轻量方案
这套清单适合合同、项目、行政、财务类电子档案,且单位没有专职运维、数据不能出内网。反过来说:如果查询以口语化语义为主、档案量在几十万份以上、需要跨库联邦检索,轻量词法方案的召回会不够,该上向量库和专职运维就要上。另外,手写内容占比高的全宗(如老人事档案),OCR 准确率会显著低于 98% 的印刷件口径,预算要按这个现实来算。
四步连起来是一条检查链:先确认 PDF 里有字,再核对交付物有没有省掉 OCR,然后按查询词特征选检索路线,最后把 AI 锁进只读加证据溯源的笼子里。内网部署的组件选型可参考站内《用 Intel 显卡搭内网模型服务:四个组件的选型》,识别准确率的选型方法可参考《中文会议录音转文字怎么选:英文第一的开源模型错三成》。
登录后可点赞、收藏与反馈。


