途虎养车官网 SEO 实测:11 万条收录,25 个页面
一个 20 年老域名,百度收录 11 万条,PC 端有排名的词只有 173 个。实测 22 条路径,21 条返回同一份 2,013 字节的单页应用壳,robots.txt 与 sitemap.xml 也在其中。
逛一个上市公司官网,看到「重定向中…」,你会关掉页面。爬虫也是。
途虎养车官网 www.tuhu.cn 现在跑的是一个三地上市的投资者关系站:25 个路由、客户端渲染、未匹配路径一律回退。旧电商时代留下的 11 万条收录还挂在百度索引里,但已经没有对应页面。这篇把 22 条路径的探测结果、渲染前后的 DOM 差异、以及爱站的收录与词量并在一起看,说明资产是怎么丢的,以及怎么捡回来。
一、11 万条收录,173 个词
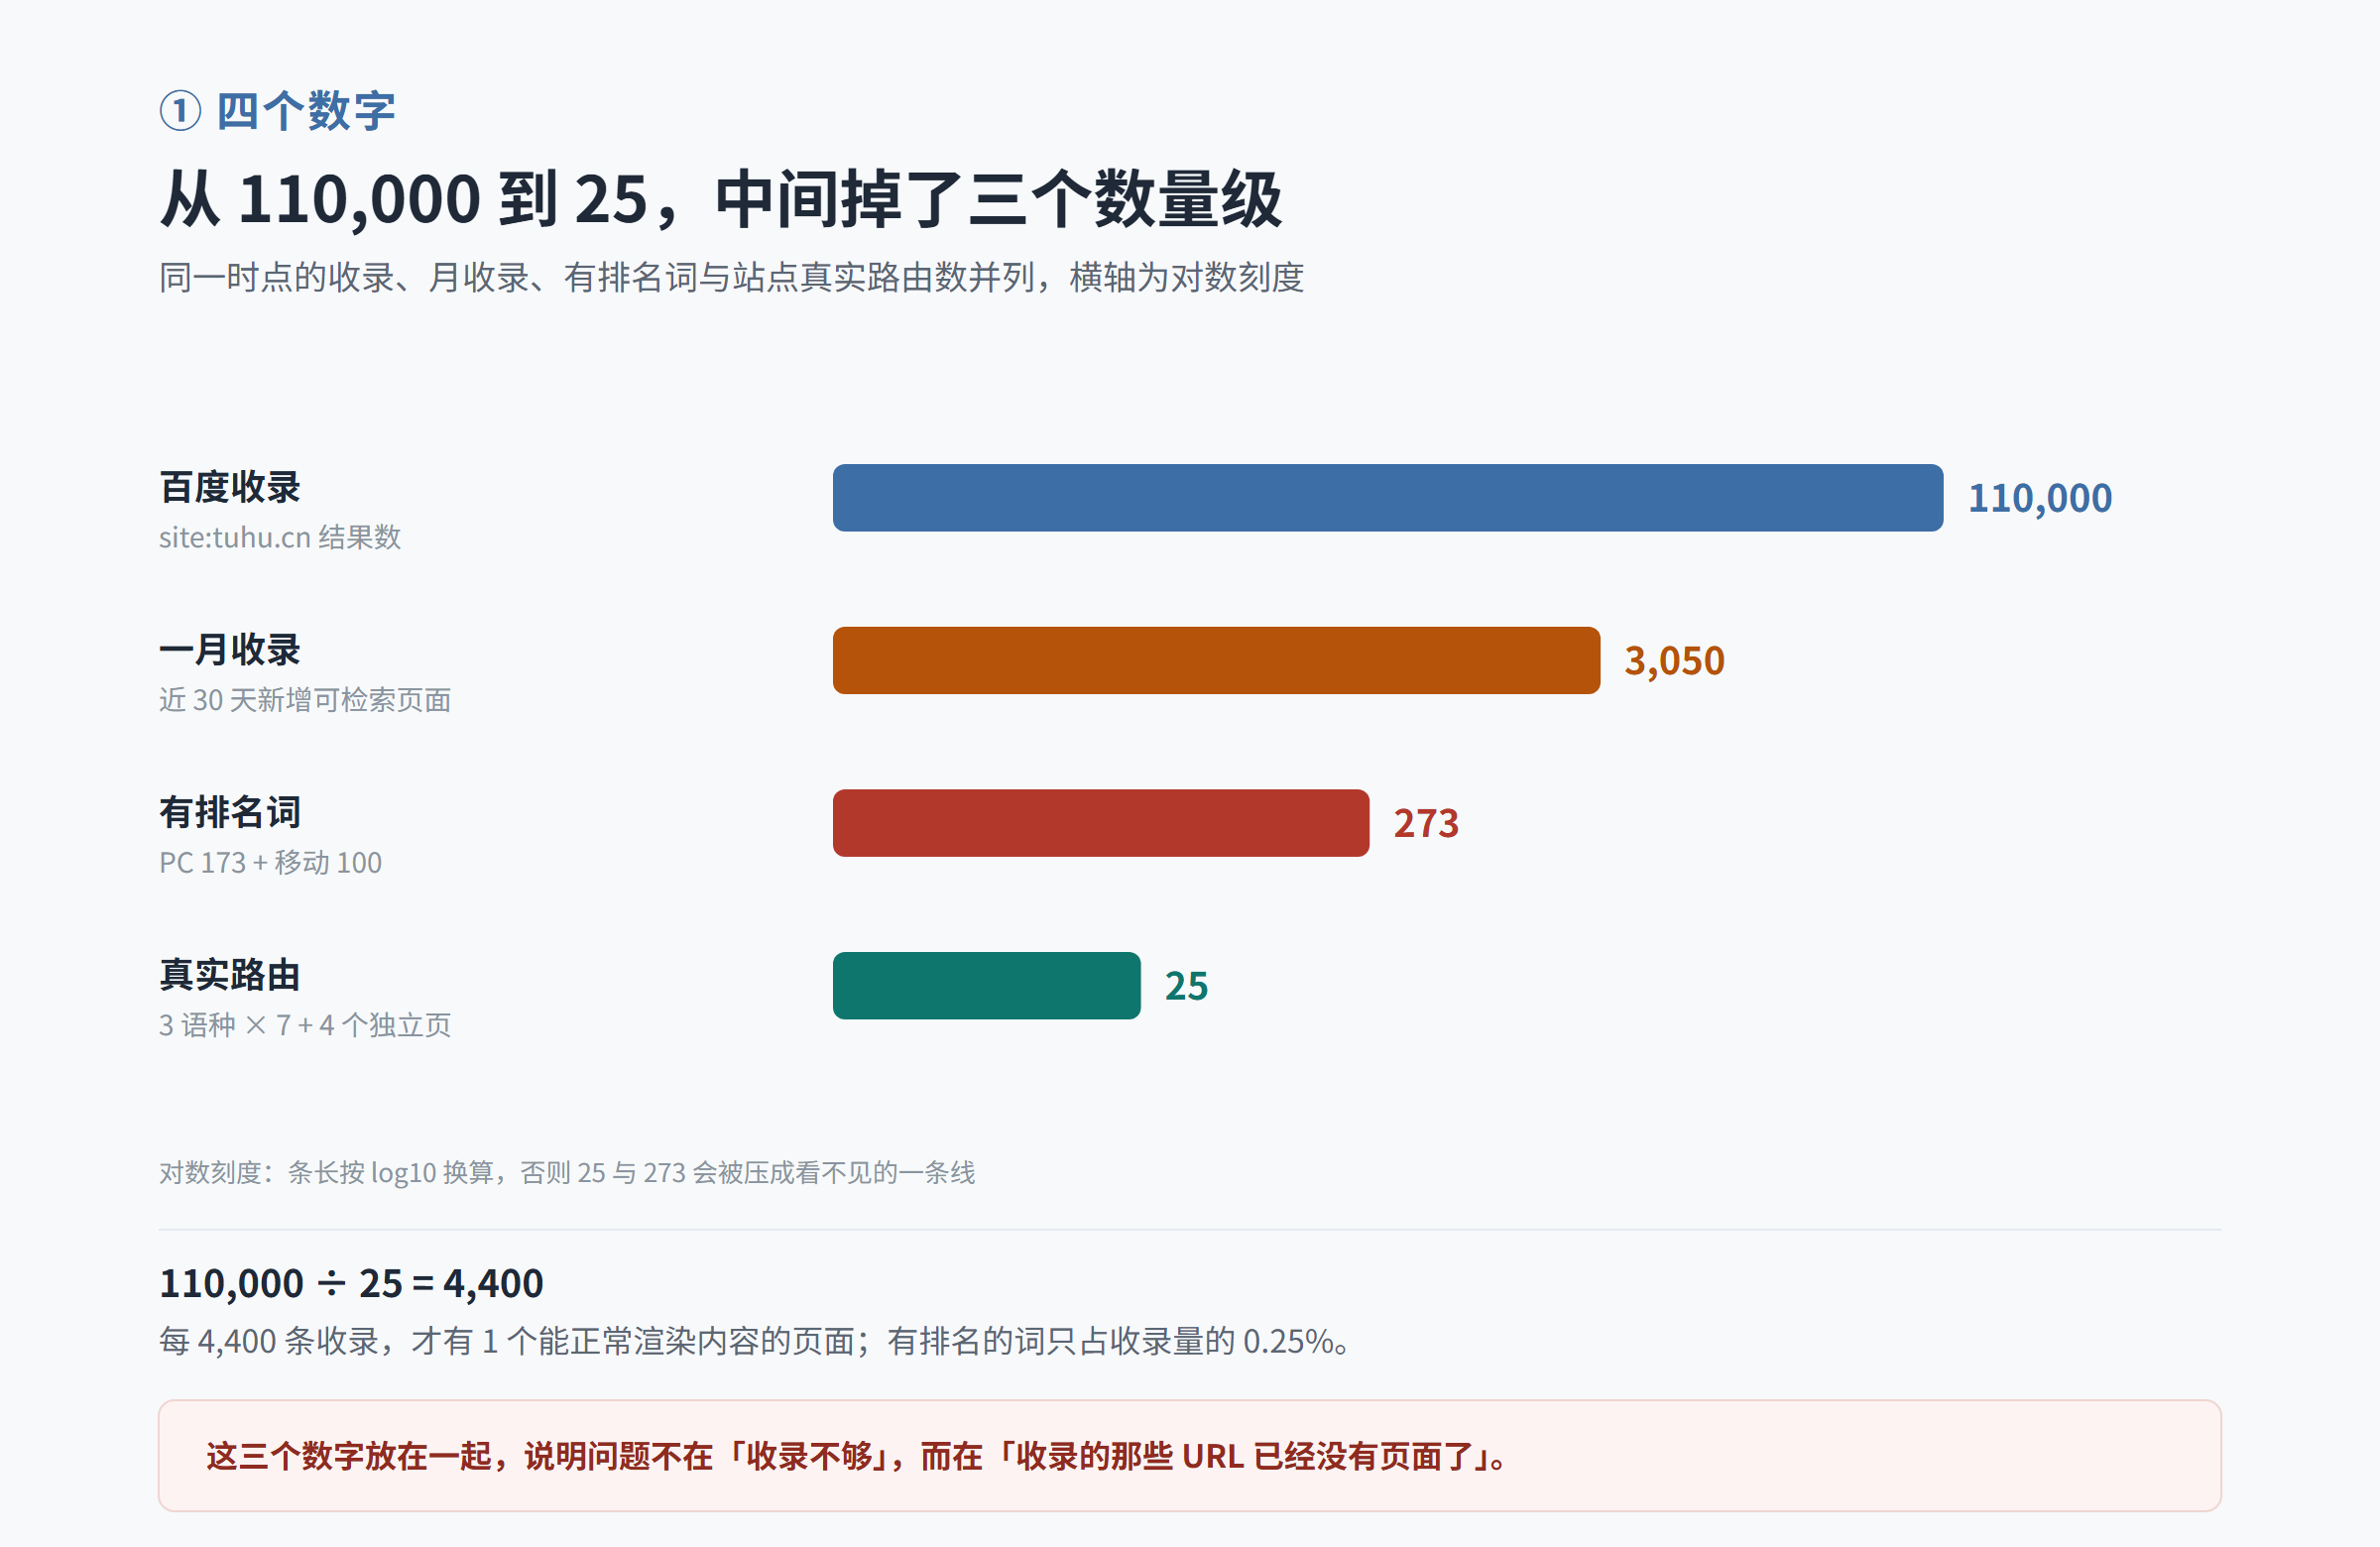
先看两组数字。爱站综合查询显示,tuhu.cn 的百度收录是 110,000 条,360 收录 9,410 条,域名年龄 20 年 7 个月,创建于 2006 年 3 月。这是一份典型的「老域名资产」。
另一组数字就对不上了:百度 PC 端有排名的词 173 个,移动端 100 个,合计 273 个。近 30 天新增可检索页面 3,050 条,一周只有 47 条。预估日均 IP 约 12,000,PV 约 48,000。
| 指标 | 数值 | 口径 |
|---|---|---|
| 百度收录 | 110,000 | site:tuhu.cn |
| 360 收录 | 9,410 | 同上 |
| 有排名词 | 173 PC + 100 移动 | 爱站词量 |
| 近 30 天收录 | 3,050 | 新增可检索页 |
| 日均 IP / PV | 约 12,000 / 48,000 | 爱站预估 |
173 个词不是小数,但对一个 11 万条收录的站点来说,等于每 636 条收录才换来一个词。此前实测的站里,中公教育 是 1:580,快递100 是 1:1,096——它们的问题在死链与 canonical,而这里的问题更靠前:收录的那些 URL,已经没有页面了。
1.1 页面数的真实上限
看前端路由表。www.tuhu.cn 的单页应用注册了 25 个路径:中文、繁体、英文三套,每套 7 个(首页、公司概况、业务介绍、新闻中心、投资者关系、新闻详情、关于我们),另加 4 个独立页(音频播放、站点首页、许可与声明、推荐)。
新闻列表每页 15 条,分页 1 到 11,翻完约 165 条。加上 25 个路由,全站真实内容页约 190 个。
110,000 ÷ 190 ≈ 579。也就是说,索引里每 579 条 URL,才有 1 条对应着能正常渲染的页面。剩下的 99.83% 是改版前的旧地址——商品页、车型页、门店页、问答页,它们现在全部指向同一份壳。
二、22 条路径,21 条是同一个文件
为了确认「壳」的范围,我用固定 UA 依次请求了 22 条路径,只读响应头与响应体,不执行 JS。
结论很整齐:21 条返回 200、2,013 字节、text/html; charset=utf-8,MD5 全部是 fae55270…。唯一例外是 /favicon.ico,4,286 字节的真图标文件。
| 请求路径 | 状态码 | 字节 | 内容类型 | 应有响应 |
|---|---|---|---|---|
| /robots.txt | 200 | 2,013 | text/html | text/plain |
| /sitemap.xml | 200 | 2,013 | text/html | application/xml |
| /Shop/ | 200 | 2,013 | text/html | 301 或 410 |
| /cn/home/news | 200 | 2,013 | text/html | 带正文的 HTML |
| /zzz-not-exist-98765 | 200 | 2,013 | text/html | 404 |
| /favicon.ico | 200 | 4,286 | image/x-icon | 正常 |
这 21 条分四类:3 个地图变体(/sitemap.xml、/sitemap_index.xml、/sitemaps.xml)、6 个符合旧电商栏目习惯的路径(/Shop/、/Bycar/、/baoyang/、/pinpai/、/Ask/、/News/)、6 个现有路由(含一条新闻详情),以及 3 个手拼的随机串;再加 /robots.txt、根目录与 /index.php。四种蜘蛛 UA(Baiduspider、百度移动、Googlebot、bingbot)复测,结果完全一致。
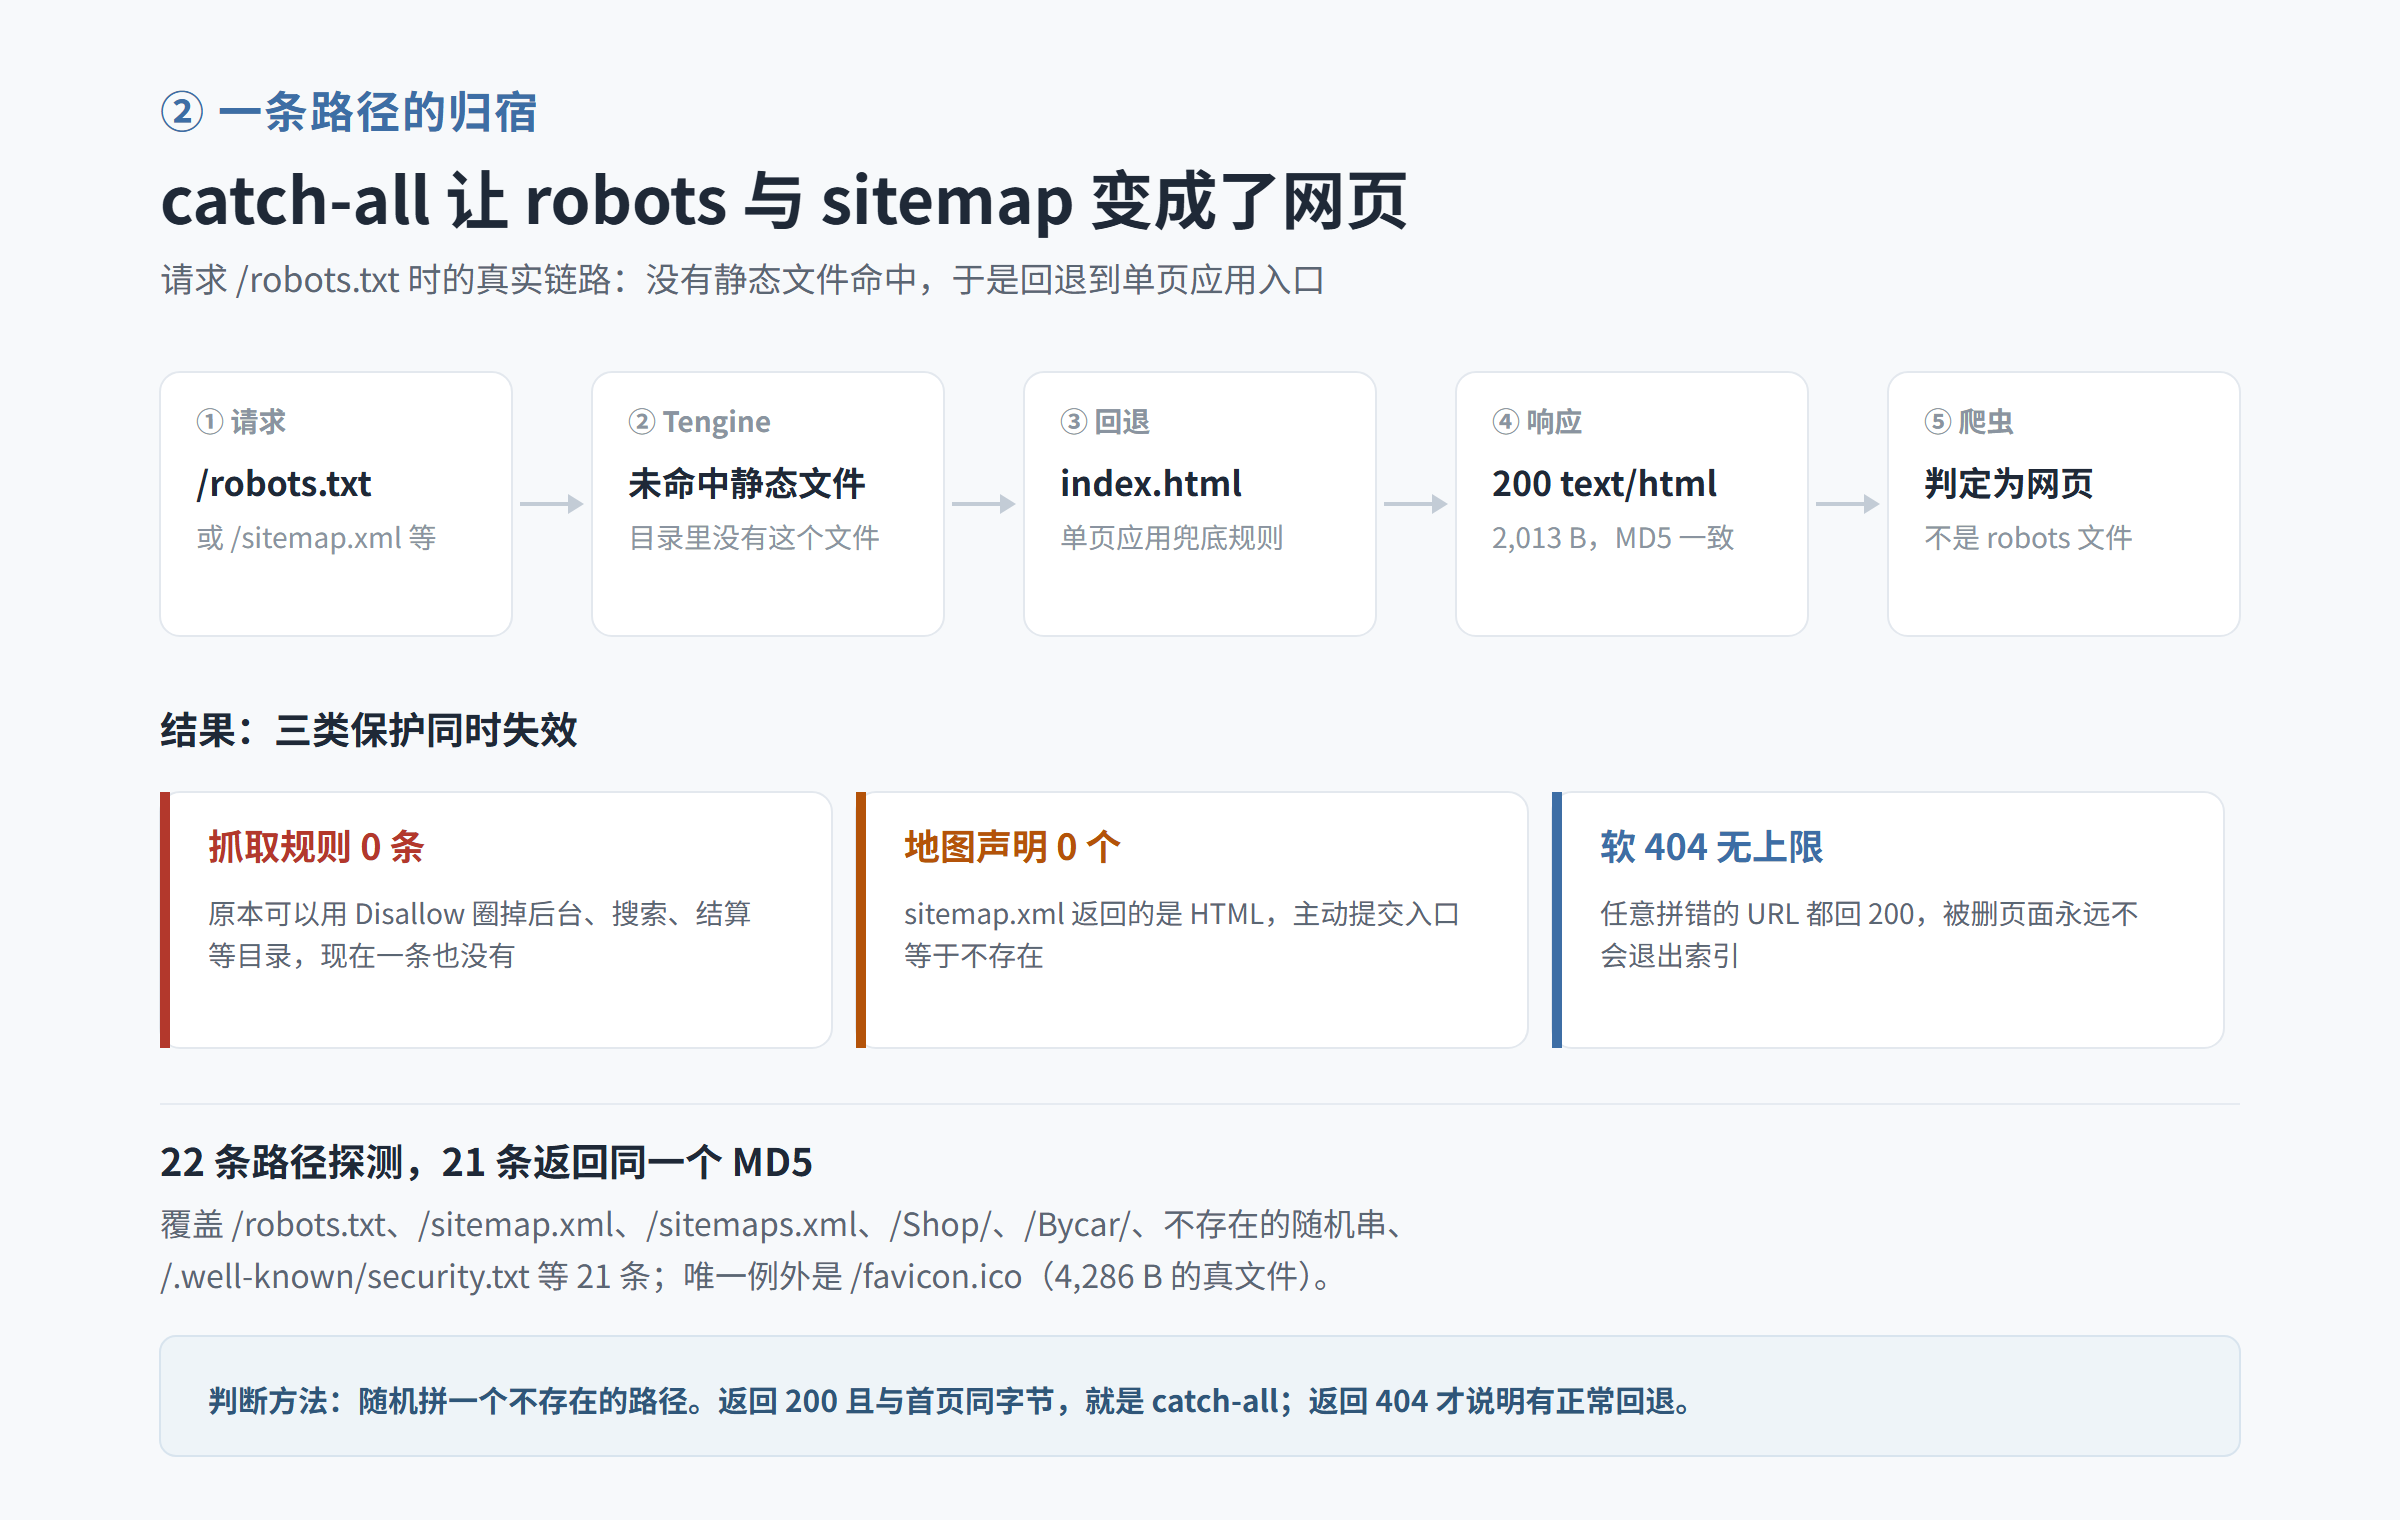
判断 catch-all 的方法很简单:随便拼一个不存在的路径。返回 200 且与首页同字节,就是 catch-all;返回 404,才说明有正常回退。
2.1 robots.txt 不是 robots.txt
链路是这样的:Tengine 收到 /robots.txt,目录里没有这个静态文件,于是回退到单页应用入口 index.html,返回 200 和 HTML。
对爬虫来说,这等于站点从未提供过 robots 文件——规则 0 条,Sitemap 声明 0 个。原本可以顺手圈掉的后台、搜索、结算目录,现在一条都圈不了;原本能主动交出去的 190 个页面,一个也没交。
2.2 软 404 没有上限
比 robots 失效更麻烦的是软 404 的规模。任何一个拼错的、下线的、改版时没处理的 URL,都返回 200。爬虫无法通过状态码判断页面死活,只能靠内容比对;而这份壳的内容永远一样,于是「无正文的 200 页面」可以无限累积。
11 万条收录就是这么留下来的:不是百度不愿意删,是站点自己说「它们都还活着」。
三、渲染之后才有的内容
用浏览器实际渲染一遍,壳会变成一个像样的官网:首页有 H1「全球领先的汽车服务平台」,新闻中心列出 15 条带日期的稿件,新闻详情页能读到 1,140 字正文。问题在于,这些都要执行 JS 才出现。
渲染后首页 357 个汉字。为了这 357 个字,浏览器要下载 2,013 字节 HTML、1,589 字节 manifest、97,418 字节 styles、52,217 字节 vendor、3,508 字节 app、41,100 字节 CSS,合计 197,845 字节,约 193 KB。
摊到每个汉字是 554 字节。作为对比,此前实测的中公教育首页是 27.1 字节/汉字,新氧是 118.8 字节/汉字——同样是「一屏字」,成本差了 5 到 20 倍。
服务器本身很快:TTFB 237 毫秒。慢的不是响应,是把 HTML 变成正文的那一步。
3.1 一个 title 覆盖全站
渲染前后,<title> 都是「途虎养车」。首页、投资者关系、新闻列表、新闻详情,四个语义完全不同的页面共用一个标题。
同一批页面里,meta description 0 条、canonical 0 条、Open Graph 0 条、JSON-LD 0 条。新闻详情页 0 个 H1,正文标题是 div。
这里要说清一个容易误判的点:Google 能执行 JS,所以它有机会看到渲染后的内容;但 title 写在 HTML 壳里,不随路由变化,渲染也救不回来。而百度对客户端渲染的正文抽取能力有限,这类站点在百度的表现,基本等于「只有壳」。
3.2 没有入口的 165 篇新闻
新闻列表的 15 条稿件,容器全是 <div class="news-item">,标题是 <span class="news-title">,点击靠事件绑定。整个页面 41 个链接里,指向站内的只有 9 个,全是顶部导航。
没有 <a href>,就没有可爬链接。165 篇新闻详情页既不在地图里,也没有列表入口,只能靠外部链接被发现。这解释了为什么「有正文的页面」和「有排名的页面」是两回事。
同一批页面里,图片 22 张有 21 张 alt 为空;新闻页 67 张有 66 张为空。alt 缺失率 95.5% 和 98.5%,图片搜索这条入口等于关着。
四、修复清单:先止血,再补结构
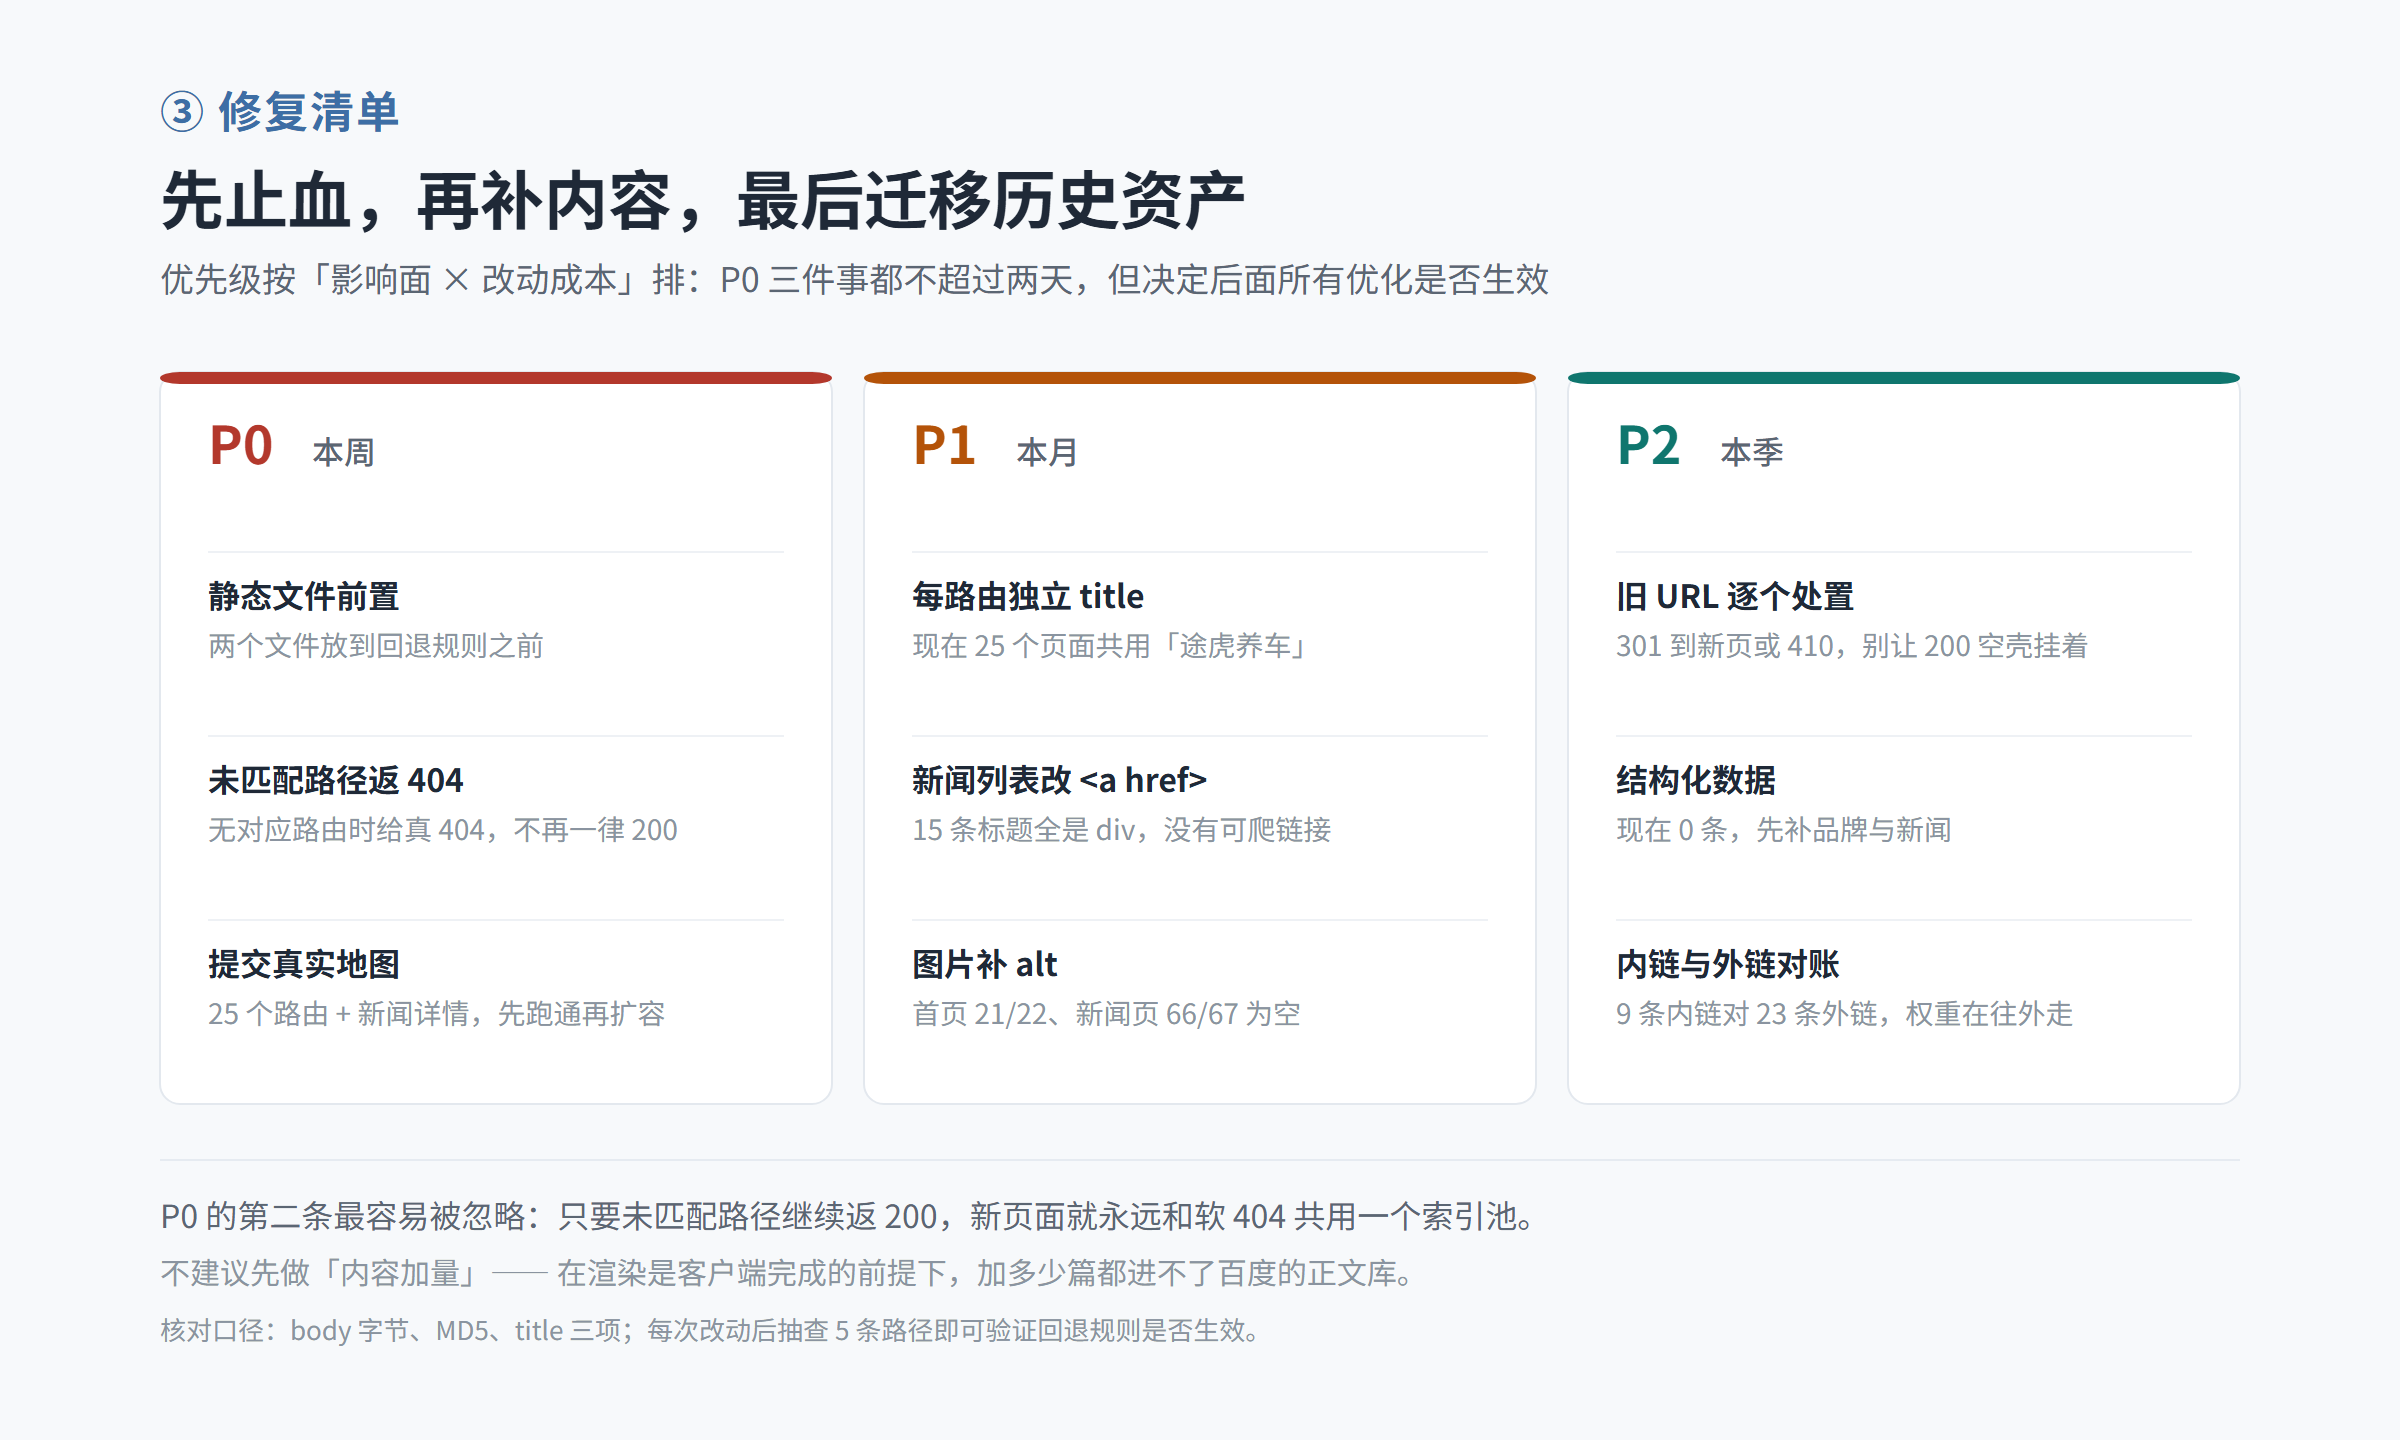
按「影响面 × 改动成本」排,P0 三件事都不超过两天,但决定后面所有优化是否生效。
| 档位 | 动作 | 影响面 | 验收口径 |
|---|---|---|---|
| P0 | 静态文件前置 | 全站抓取规则与地图 | /robots.txt 返回 text/plain 且含 Sitemap 行 |
| P0 | 未匹配路径返 404 | 11 万条软 404 | 随机串返回 404,且不含 SPA 壳 |
| P0 | 提交真实地图 | 190 个内容页 | 地图可访问,收录数在 4 周内变化 |
| P1 | 每路由独立 title | 25 个页面 | 抽查 5 个路由,title 各不相同 |
| P1 | 新闻列表改 a 标签 | 165 篇详情 | 列表页正文区出现 15 个 href |
| P1 | 图片补 alt | 首页 21 张、新闻页 66 张 | 空 alt 占比降到 10% 以下 |
| P2 | 旧 URL 逐个处置 | 约 10.9 万条 | 301 到对应新页,确无对应的返 410 |
| P2 | 结构化数据 | 品牌与新闻 | 首页有 Organization,详情页有 NewsArticle |
| P2 | 内链与外链对账 | 9 内链对 23 外链 | 内链数不低于外链数 |
每条都要说清验收口径,否则改完没法判断是否生效。P0 的三条尤其要用「响应头 + body 字节 + MD5」三项核对,只看状态码会被 SPA 回退骗过去。
P0 里第二条最容易被忽略。只要未匹配路径继续返 200,新页面就永远和软 404 共用一个索引池,做多少内容都是往里倒水。
不建议先做「内容加量」。在正文靠客户端渲染、title 不随路由变化的前提下,加多少篇都进不了百度的正文库。顺序应该是:先让爬虫能读到真的 robots 和真的 404,再让每个页面有独立标题,最后才是内容与结构。
关于旧 URL 的处置,有个折中方案值得考虑:把 /Shop/、/Bycar/ 这类旧栏目整体 301 到现有的业务介绍页,而不是逐条映射。商品级的精确映射成本极高,栏目级跳转能把 11 万条里的绝大部分导向一个活页面,剩下的确无对应关系的返 410,让索引干净退出。
同样的毛病在移动端也有。m.tuhu.cn 返回的是 510 字节的「重定向中…」页面,状态码 200,没有 canonical;渲染后才跳到「天天秒杀」活动页。移动搜索的入口,落在一个促销页上。
这类问题不只出现在这一个站。改版把服务端模板换成单页应用时,最容易一起丢的就是 robots、sitemap、独立 title 和 404——它们都不在视觉验收的清单里,但都在流量的必经之路上。
延伸阅读:新氧 的登录墙把 948 万条 URL 挡在门外,盖德化工的 18 份地图有 16 份是空文件,中公教育的 994 条地图里 73% 已经 404。三个站、三种病,同一个症状——收录还在,页面没了。
登录后可点赞、收藏与反馈。