Unsloth Desktop 来了:不写代码微调,显存门槛在哪
Unsloth 原本是给开发者用的微调库,现在有了桌面端安装包。它把 LoRA 微调做成界面操作,但显存需求没变——7B 模型微调仍然要 16GB 级显卡起步。
Unsloth 最早出名是因为一件事:把 LoRA 微调的显存占用和训练速度做到了明显优于同类实现。它本来是 Python 库,使用者要会写训练脚本。桌面端的出现,改变的是使用门槛,不是硬件门槛。
它解决什么问题
微调大模型的传统路径是:装环境、写训练脚本、调超参、处理显存溢出。Unsloth 用优化过的算子把显存占用压下来,让消费级显卡也能跑 7B 级别的 LoRA 训练。
桌面端把这条路径图形化:选模型、选数据集、设参数、点开始。适合不想碰命令行的团队。
最近更新了什么
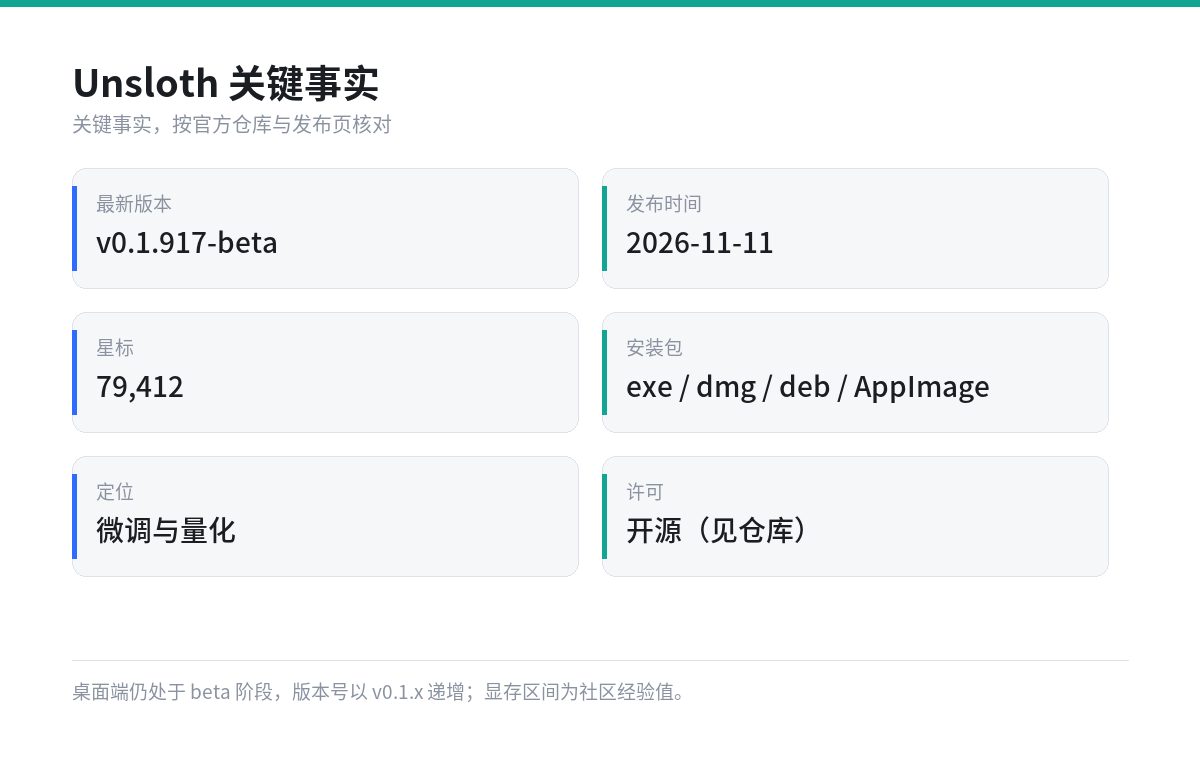
2026 年 11 月 11 日的 v0.1.917-beta 主要两项:Dynamic v3.1 的 GGUF 量化支持,以及一批性能修复。前两个版本的关键词是「大幅度性能修复」和「可定制性 + 浏览器调用」。
需要说清楚的是,桌面端仍是 beta,版本号停在 v0.1.x,功能更新快但不保证稳定。生产训练建议用库版本,把流程写进脚本。
显存门槛(经验值)
以下是社区常见配置,不是官方承诺:
- 7B 模型,QLoRA 4bit:12GB 显存可以启动,16GB 比较稳;
- 14B 模型,QLoRA 4bit:24GB 起步;
- 32B 模型:40GB 以上,消费级单卡基本不现实。
序列长度是隐藏变量。把上下文从 2048 提到 8192,显存占用可能翻倍,训练前先算这笔账。
三步跑通
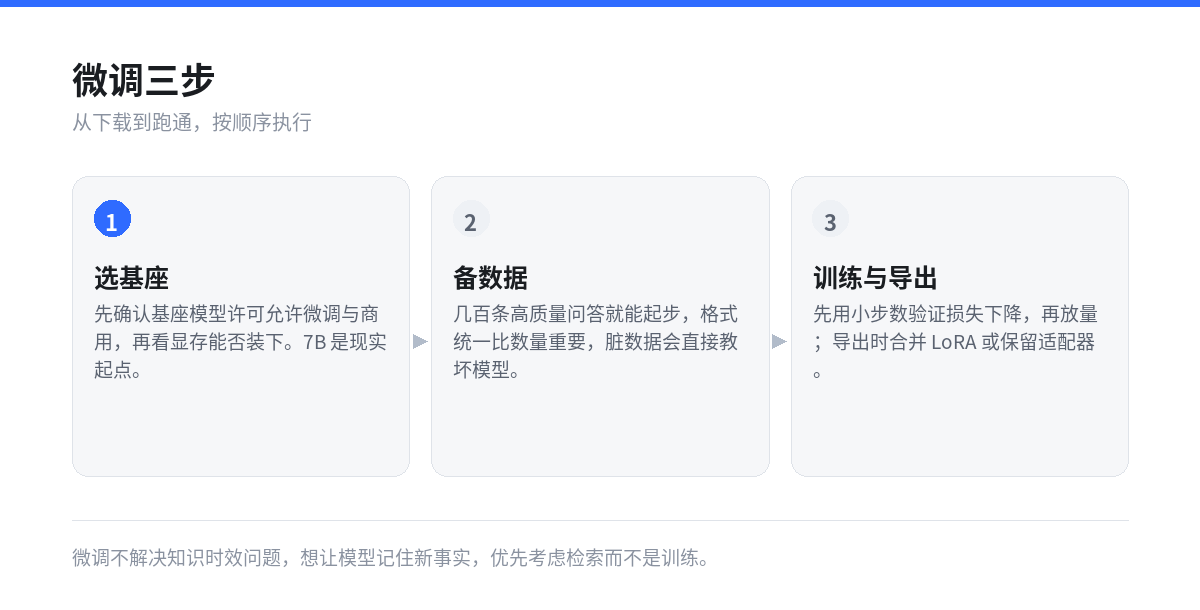
数据准备是最容易被低估的环节。五百条格式统一、答案准确的样本,效果通常好过五万条网上抓来的杂数据。
三个限制
微调不注入新知识。 它改变的是表达风格和任务模式,想让模型回答新事实,检索增强比微调更合适。
评测缺位。 训练损失下降不代表效果好,要留一批没参与训练的问题做人工对比。
导出有格式问题。 合并 LoRA 后的模型体积变大,量化后可能掉点;适配器分发更轻,但推理端要支持加载。
常见问题
免费吗? 库和桌面端都可免费使用,具体条款看仓库许可。
和 LlamaFactory 的区别? 两者都做微调,Unsloth 强在速度和显存优化,LlamaFactory 强在模型覆盖和界面完整度。
一定要 NVIDIA 吗? 官方优化以 NVIDIA 为主,其它平台能跑但速度差距明显。
微调完能商用吗? 取决于基座模型许可,跟工具无关。
一句话判断
Unsloth 把微调从「实验室技能」变成「有显卡就能试」的事,但数据质量和评测方法仍然决定成败。
登录后可点赞、收藏与反馈。