二手 V100 跑 DeepSeek:12 卡 184 tok/s,照抄的人卡在 SM70 这一关
12 张二手 V100 跑 DeepSeek-V4.1-Flash 刷屏,但公开栈里已经没有 SM70 的位置:CUDA 13 弃养、vLLM 0.20 移除、NVFP4 没有对应内核。按五道关拆可复制的部分,附 11 条报错急救。
11 月 20 日,一位律师在 Reddit 发帖:12 张二手 V100 SXM2 32GB,整套 9,450 美元(约 6.3 万元),本地跑 DeepSeek-V4.1-Flash,单流代码 157–184 tok/s。第二天 IT之家和 Tom's Hardware 跟进,中文转述的关键词变成了「6.3 万干翻 DGX Spark」。
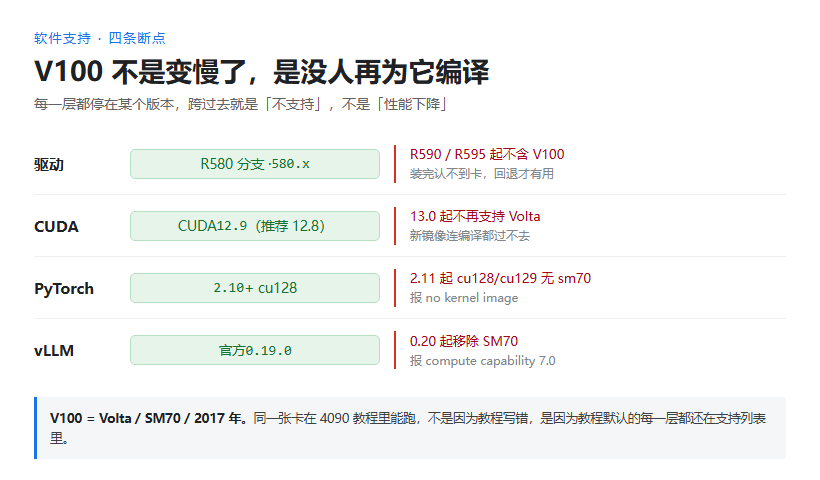
但二手 V100 跑 DeepSeek 这件事,第一步就会卡住。你照 4090 教程敲下 pip install vllm,起服务时报的是 ValueError: compute capability 7.0 is not supported。V100 是 2017 年的 Volta,计算能力 7.0(SM70);CUDA 13.0 已把它移出支持列表,PyTorch 2.11 起的 cu128/cu129 预编译包不再含 sm_70,官方 vLLM 从 0.20 起也删了 SM70 路径。
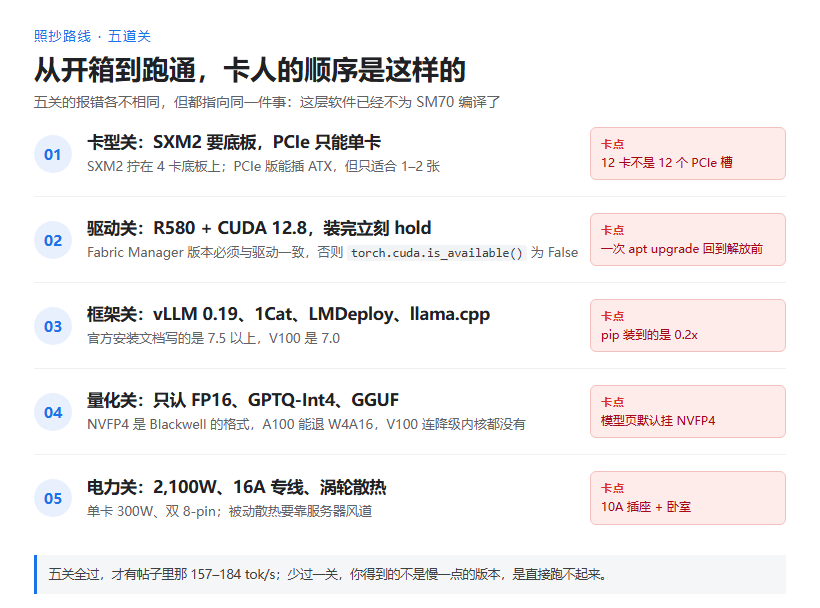
这条路能走,但顺序要倒过来:先锁驱动 R580,再锁 CUDA 12.8,再锁 vLLM 0.19 或 SM70 专用 fork,量化只认 GPTQ 和 GGUF。下面按五道关拆:哪些是那位律师的私有栈,哪些你花钱能复制,哪些花钱也复制不了;末尾给 11 条报错急救。
二手 V100 跑 DeepSeek 的 184 tok/s,条件比数字长得多
先把帖子里的配置摆全。12 张卡不是插在一张主板上:按 11 月 9 日那版 8 卡的结构推,12 张对应三块 4 卡 SXM2 底板,靠 NVLink 和 PCIe 交换机连起来;模型按 3 级流水线、每级 4 卡张量并行切开。
| 项目 | 帖子里的配置 | 备注 |
|---|---|---|
| 显卡 | 12 × Tesla V100 SXM2 32GB | 2017 年 Volta,SM70 |
| 整机价 | 9,450 美元(约 6.3 万元) | 帖子口径为整套硬件 |
| 并行方式 | PP3 × TP4 | 3 级流水线,每级 4 卡张量并行 |
| 模型 | DeepSeek-V4.1-Flash | 552B 主干,384 路由专家 × 40 层 |
| 专家量化 | 4-bit NVFP4 | 15,360 个专家全部驻留显存 |
| 上下文 | 524K | 帖子按 524K 配置 |
| 单流速度 | 代码 157–184 tok/s;普通文本 83–95 tok/s | 3 个流合计 344–443 tok/s |
| 预填充 | 4,500–4,700 tok/s | 128K 文件首字 28 秒,256K 首字 58 秒 |
| 功耗与噪音 | 峰值约 2,100W | 帖子自述噪音大,不适合普通办公环境 |
这里有个被中文转述带偏的细节:15,360 是专家总数,不是「每个专家 15,360 个参数」。DeepSeek-V4.1-Flash 每层 384 个路由专家、40 层,乘起来正好 15,360;模型卡写的是 552B 主干、1 个共享专家 + 384 个路由专家、每 token 激活 6 个。
更关键的是量化格式。帖子里写的是「全部专家 4-bit NVFP4 放进显存」,而 NVFP4 是 Blackwell(sm_100 / sm_120)才有的数据类型。NVIDIA 自己的 CUDA Tile 文档写得很直:在不支持的目标上,打包好的 FP4 字节「只是字节」,要用就得先反量化成别的计算格式,收益退化成纯带宽。V100 连 BF16 都没有,更没有 FP4 的反量化内核。
按公开内核的现状看,那 184 tok/s 不是「V100 变强了」,而是用了公开栈里没有的 kernel。帖子里同时列了 TensorFold 4.0 bpw 和「vLLM + DSpark」两个自建组合,这几个数字本来就是不同栈跑出来的。
| 环节 | 新闻里的做法 | 公开栈能做的 | 差在哪 |
|---|---|---|---|
| 专家量化 | NVFP4 4-bit,自建内核 | FP16,或 GPTQ-Int4 反量化计算 | 显存占用更高,速度低一档 |
| 推理框架 | TensorFold 4.0 bpw / vLLM + DSpark | vLLM 0.19、1Cat-vLLM、LMDeploy、llama.cpp | 要自己编译或换 fork |
| 卡间互联 | 3 块 SXM2 底板 + NVLink + PEX 交换机 | 同样的硬件,但底板要另外买 | 12 卡不是插 12 个 PCIe 槽 |
| 上下文 | 524K | 128K 较稳,256K 要实测 | KV 与激活吃余量 |
为什么 V100 不能照抄 4090 教程:SM70 缺的不是显存
V100 的账面并不难看:32GB HBM2、900 GB/s 显存带宽、FP16 张量算力 125 TFLOPS,SXM2 底板内 NVLink 2.0 聚合 300 GB/s。它的问题是整条软件栈在这两年陆续关门,而且关得很有节奏。
| 组件 | 最后支持 V100 的版本 | 现在的默认 | 后果 |
|---|---|---|---|
| NVIDIA 驱动 | R580 分支(文档给到 580.173.02) | R590 / R595 不含 V100 | 装新驱动认不到卡 |
| CUDA Toolkit | 12.9(推荐 12.8) | 13.x 起不支持 Volta | 新镜像编译直接失败 |
| PyTorch | 2.10 + cu128,或 cu126 | 2.11 起 cu128/cu129 无 sm70;2.14 是最后一个带 CUDA 12.x wheel 的版本 | no kernel image |
| 官方 vLLM | 0.19.0 | 0.20 起移除 SM70,安装文档写 7.5 以上 | compute capability 7.0 报错 |
| SGLang | 不支持 | — | 直接换框架 |
| TEI(Embedding) | 不支持 | — | 向量服务另找 |
| LM Studio | 不支持 | — | 图形界面这条捷径没戏 |
| llama.cpp 预编译包 | 已移除 Volta | 需自编译 | 下载的 binary 跑不了 |
把这张表读成一句话:V100 不是跑得慢,是没人再为它编译。同样的 32GB 显存,A100 能退到 Marlin 的 W4A16(权重 FP4、激活 BF16),V100 连这条降级路都没有——它没有 BF16。
第一关:SXM2 还是 PCIe,买卡前先算底板和 BIOS
SXM2 版长得不像显卡:没有金手指、没有挡板、没有风扇,只能拧在 4 卡底板上。那位律师用的是三块 4 卡底板加 PEX 交换机、SlimSAS 线,Tom's Hardware 11 月 9 日那篇 8 卡报道里,4 卡底板约 2,400 美元一块。注意这是上一版的采购价,和 12 卡整机 9,450 美元不是同一批,别直接相加。
个人用户更现实的是 PCIe 版 32GB:二手行情 400–500 美元(2026 年 7 月口径,非报价),能插普通主板,但同样没有显示输出、被动散热。它适合 1–2 张卡跑 27B 级模型,不适合拼 12 卡。
不管哪种,BIOS 这四项先改,否则卡还没跑起来就先报错:
- Above 4G Decoding 必须开:不开会报驱动错误代码 43,或显存只认出一半。
- CSM Support 关掉:必须 UEFI 启动。
- 主显示设备设为核显:V100 没有视频输出,插着显示器也不亮。
- PCIe 速率锁 Gen3:主板是 4.0/5.0、又用转接卡时,锁 Gen3 更稳。
多卡还要装 Fabric Manager,版本必须和驱动严格对应(580 驱动配 nvidia-fabricmanager-580)。漏装的表现很迷惑:nvidia-smi 能看到卡,torch.cuda.is_available() 却是 False。装完用这两条确认拓扑和链路:
nvidia-smi topo -m          # NVX 表示 NVLink 直连,SYS 表示跨 NUMA 走 PCIe
nvidia-smi nvlink --status  # 每条链路应显示 50 GB/s 双向
第二关:驱动钉在 R580、CUDA 钉在 12.8,别让 apt upgrade 毁一周
V100 的驱动不是「越新越好」,而是「越新越没有」。R580 是最后一个支持 Volta 的分支,R590/R595 已经不含 V100。CUDA 同理:12.9 是最后一个支持 Volta 的版本,实践里更稳的是 12.8。
sudo apt install -y nvidia-driver-580-server
sudo apt install -y nvidia-fabricmanager-580   # 版本必须与驱动一致
sudo systemctl enable --now nvidia-fabricmanager
sudo apt install -y cuda-toolkit-12-8

# 钉住版本,避免一次 apt upgrade 把驱动带到 R590
sudo apt-mark hold nvidia-driver-580-server nvidia-fabricmanager-580
Python 侧别装默认 wheel。默认源从 PyTorch 2.11 起就是 CUDA 13 构建,装上去 torch.cuda.is_available() 直接 False。要么用 cu126,要么停在 2.10 + cu128:
pip install torch==2.10.0 \
  --index-url https://download.pytorch.org/whl/cu128

python -c "import torch; print(torch.__version__, torch.cuda.get_arch_list())"
# 输出里必须出现 sm_70;没有的话,后面所有报错都从这里来
第三关:四条推理路线,官方 vLLM 只剩 0.19 能用
官方 vLLM 的安装文档现在写的是「compute capability 7.5 以上」,V100 的 7.0 连门槛都够不到。想在 V100 上跑,只剩这四条路,各有各的代价。
| 路线 | 可用版本 | 适合 | 代价 |
|---|---|---|---|
| 官方 vLLM | 0.19.0 | 想少折腾、跑 GPTQ | 没有 FlashAttention 2,必须加 --enforce-eager;AWQ 不支持 |
| 1Cat-vLLM | v1.3.0(SM70 专用 fork) | 要并发、要 FLASH_ATTN_V100 后端 | 第三方 fork,得跟着社区升级 |
| LMDeploy | 0.10.0 | 官方明确支持 SM70,AWQ / INT8 都能用 | 生态和文档比 vLLM 少 |
| llama.cpp | 自编译 | 单机最稳、GGUF 换模型方便 | 吞吐低于 vLLM,长上下文弱 |
最省事的是官方 vLLM 0.19 的镜像。注意三个参数一个都不能少:--enforce-eager 绕开 FA2,--dtype float16 因为 V100 没有 BF16,--quantization gptq 因为 AWQ 内核要求 sm75 以上。
docker run -d --gpus all --ipc=host -p 8000:8000 \
  -v /models/Qwen3.8-27B-GPTQ-Int4:/model \
  vllm/vllm-openai:v0.19.0 /model \
  --quantization gptq --dtype float16 \
  --tensor-parallel-size 4 --max-model-len 131072 \
  --gpu-memory-utilization 0.90 --enforce-eager
如果只是单机自用、不想碰容器,llama.cpp 更稳,但必须自己编译——预编译包已经不带 Volta 了:
cmake -B build -DGGML_CUDA=ON -DGGML_NATIVE=ON \
  -DCMAKE_CUDA_ARCHITECTURES=70
cmake --build build --config Release -j $(nproc)

./build/bin/llama-server -m model.Q4_K_M.gguf \
  -ngl 9999 -ts 1,1,1,1 -c 8192 --host 0.0.0.0 --port 8080
第四关:量化只认 GPTQ 和 GGUF,NVFP4 在 V100 上根本没有内核
量化是 V100 最容易踩空的一关:网上模型页默认挂 NVFP4、FP8、AWQ,这三种在 V100 上都不能用。能用的只有 FP16、GPTQ-Int4 和 GGUF。
| 格式 | V100 能否用 | 说明 |
|---|---|---|
| FP16 | 能 | 原生张量核心,最稳,显存最贵 |
| GPTQ-Int4 | 能 | 反量化回 FP16 计算;别碰 Marlin 内核(要求 sm80 以上) |
| GGUF Q4_K_M | 能 | llama.cpp 路线,换模型最方便 |
| AWQ | 不能 | vLLM 的 AWQ 内核要求 Turing(sm75)以上 |
| FP8 | 不能 | V100 没有 FP8 单元 |
| NVFP4 | 不能 | 原生只在 sm_100/sm_120;A100/H100 可退到 Marlin W4A16,V100 无对应内核 |
再说 12 张卡的必要性。552B 主干按 4-bit 存放约 276GB,12 × 32GB = 384GB,剩下的余量要留给非专家权重、KV 缓存和激活;8 张卡 256GB 连权重都放不下。官方没有公布这套配置的分项占用,这个数是按公开参数量反推的估算,不是实测。
如果只是想本地跑得动,4 张 V100 更现实:社区在 4×V100 16GB 上跑 27B 的 GPTQ-Int4 版本,128K 上下文能开 5 个并发,带 batching 的 decode 在 52–141 tok/s,首 token 约 380ms(模型卡实测口径)。32GB 卡余量更大,但别指望单机跑 552B——显存账本先算一遍,比看任何评测都准(站内《本地跑大模型要多少显存》有 8 档参数对照)。
第五关:2,100W、被动散热和噪音,机房条件比显卡更难搞
12 张 SXM2 单卡满载 300W,整机实测峰值约 2,100W。家用 10A 插座的上限是 2.2kW,等于让整套系统贴着天花板跑;要用 16A 专线,别和空调、微波炉共用一路。按 0.6 元/度估算,2.1kW 跑 10 小时是 12.6 元/天,约 378 元/月;24 小时挂机约 900 元/月。
散热同样不是小事。SXM2 是被动散热,原厂靠服务器风道,台式化要么上涡轮风扇转接卡,要么改水冷;核心到 80°C 报警、85°C 降频。噪音方面,之前有装机者把单张 V100 塞进游戏主机,形容「像割草机」,12 张一起的声音不适合任何有人办公的房间。
把电费和 API 账单放在一起,账会更清楚。下面按 DeepSeek 官方 $1.20/百万输出 token(峰值价)、1 美元≈6.7 元估算,只算输出、不含输入与缓存:
| 每天输出 | API 费用/天 | 6.3 万元硬件回本 |
|---|---|---|
| 100 万 token | 约 8 元 | 约 21 年 |
| 500 万 token | 约 40 元 | 约 4.3 年 |
| 2,000 万 token | 约 161 元 | 约 1.1 年 |
低负载时,电费(12.6 元/天)比 API 账单(8 元/天)还贵。所以自建的理由不是省钱,是数据不出门——那位律师的原始动机就是案卷不上传,这个前提换掉,整笔账就不成立。
常见翻车报错与急救清单
| 报错 / 现象 | 原因 | 解法 |
|---|---|---|
ValueError: compute capability 7.0 is not supported | vLLM 0.20 及以上 | 降到 0.19.0,或换 1Cat-vLLM |
no kernel image is available for execution on the device | PyTorch wheel 不含 sm_70 | 换 cu126 或 2.10+cu128,用 get_arch_list() 验证 |
torch.cuda.is_available() 为 False,但 nvidia-smi 正常 | Fabric Manager 缺失或版本不匹配 | 装与驱动同版本的 nvidia-fabricmanager 并启动 |
| 驱动错误代码 43,显存识别不全 | BIOS 没开 Above 4G Decoding | 开机进 BIOS 打开该选项 |
FlashAttention only supports Ampere GPUs | V100 没有 FA2 | 加 --enforce-eager,或用 1Cat 的 FLASH_ATTN_V100 |
AWQ is not supported on this GPU | AWQ 内核要求 sm75 以上 | 换 GPTQ-Int4 或 GGUF |
| 加载 GPTQ 时报 Marlin 相关错误 | Marlin 内核要求 sm80 以上 | 用 vLLM 0.19 默认 GPTQ 路径,别手动开 Marlin |
| 双卡速度没有提升 | 张量并行没生效 | 确认 -ts 1,1,且 CUDA_VISIBLE_DEVICES 只含这两张卡 |
nvidia-smi nvlink 只有 25 GB/s | 链路降级或桥接没装好 | 查 topo -m 是否为 NVX,重插底板与线材 |
| 容器里看不到 GPU | 缺 nvidia-container-toolkit | 安装后重启 Docker |
| 128K 上下文就 OOM | KV 缓存吃满 32GB | 降 --max-model-len、降并发,或换更小模型 |
这套二手 V100 方案适合谁:三类人对号入座
适合:数据不能出内网的小律所、设计工作室、诊所,本来就有 4 卡底板和机房,也接受「这台机器永远停在 CUDA 12」。
不适合:只想省订阅费的个人——一张 3090 或 5080 更省心,至少新模型发出来当天就能跑;要追新架构的团队——新模型的 kernel 基本只发 sm90 以上,V100 会越来越像孤岛;没有专线、没有独立房间的人——2,100W 和那个噪音,住宅里很难长期相处。
中间路线:先用 1–2 张 PCIe 版跑 27B 级模型验证需求,真到了显存不够再考虑拼底板;或者干脆租卡,把运维成本换成按小时计费(站内《GPU 租金涨了》和《USB4 多机拼算力》是两条不同的替代路径)。二手卡这条线的性价比,很多时候是拿时间换的——你省下的 3 万块,会在第一次 no kernel image 时开始计价。
最后留个问题给同款用户:你手上的是 SXM2 还是 PCIe?卡在哪一步——驱动、Fabric Manager,还是 vLLM 版本?把 nvidia-smi topo -m 的第一行和报错原文贴到评论区,我按这张表帮你对。
登录后可点赞、收藏与反馈。


