VoiceStudio 可以改歌曲人声吗:本地语音克隆的边界
VoiceStudio 是开源的本地语音工作台,v0.5.8 把 OmniVoice、CosyVoice 3 这些模型接进了安装包。它能做人声替换和配音,但「改歌」涉及版权和音质两道坎。
VoiceStudio 是这两年少见的、把「本地语音」做成完整桌面产品的开源项目。它把语音合成、声音克隆、人声替换几件事收进一个界面,全部在本机跑,不上传音频。
它能做什么
三件事:文字转语音(TTS)、用一段参考音频克隆音色、把一段人声替换成另一个音色。界面按任务分区,模型在设置里切换。
它的定位是「本地版语音工作台」:不依赖云服务,代价是模型要下载、显存要够、效果取决于你选的模型。
最近更新了什么
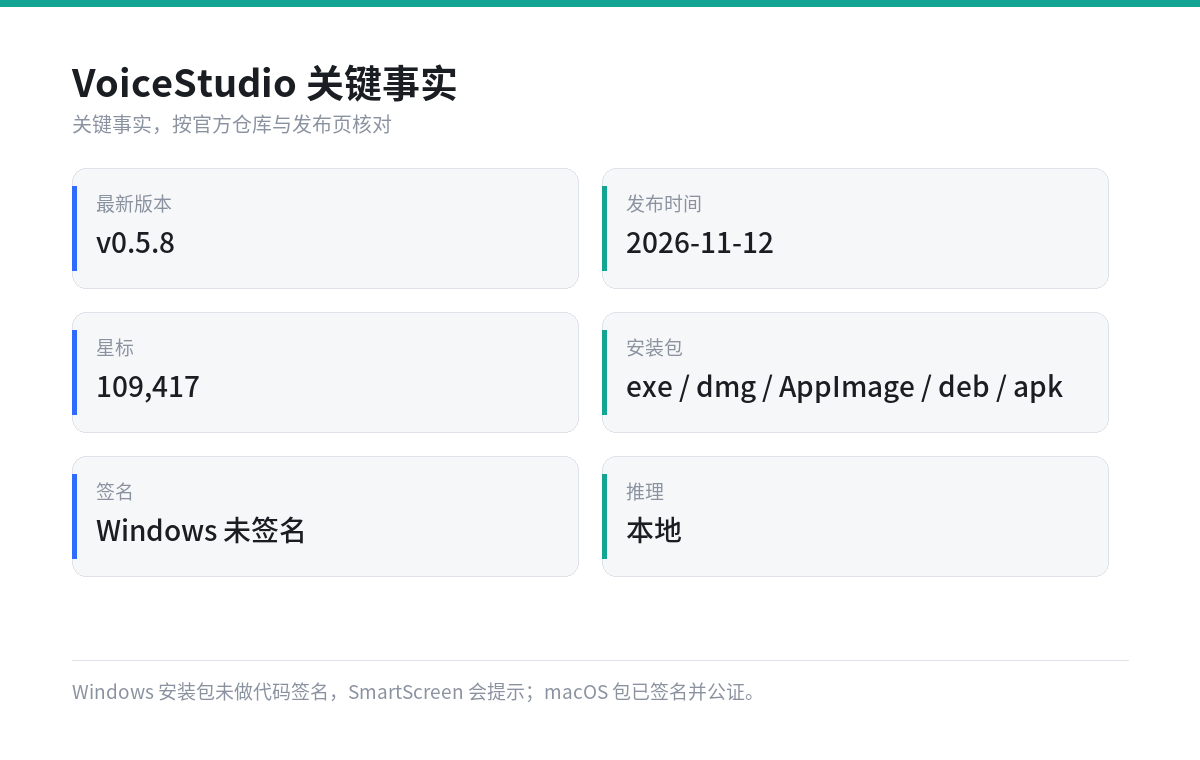
2026 年 11 月 12 日的 v0.5.8 是一次密集修复,信息量很大:
- 安装包内置
tts-server,OmniVoice GGUF 的常驻模式(设置 → 性能)可以直接用; - Intel Arc 显卡上 OmniVoice 改用 bfloat16 运行;
- 修复 CosyVoice 3 在 Vulkan 下找不到显卡的问题;
- 修复水印在静音段产生的轻微偏移;
- 恢复对昇腾 NPU 的检测;
- 新的 macOS 安装窗口,默认安装体积小了约 81MB。
还有一个必须提前知道的点:Windows 安装包没有代码签名,SmartScreen 会弹「Windows 已保护你的电脑」,需要点「更多信息 → 仍要运行」。macOS 包则做了签名和公证。
「改歌」的三道坎
第一道是人声分离。 直接拿整首歌喂给换声模型,伴奏会被人声模型当成噪声处理,结果糊。要先用分离工具拆出干声。
第二道是音质。 克隆音色在说话场景表现稳定,唱歌时的音高、气息、颤音是另一套难度。模型能对上音色,未必对得上演唱技巧。
第三道是版权。 用别人的声音训练或替换,涉及声音权;翻唱涉及词曲版权;发布到平台还可能触发 Content ID。技术能做,不等于能发。
安装与硬件
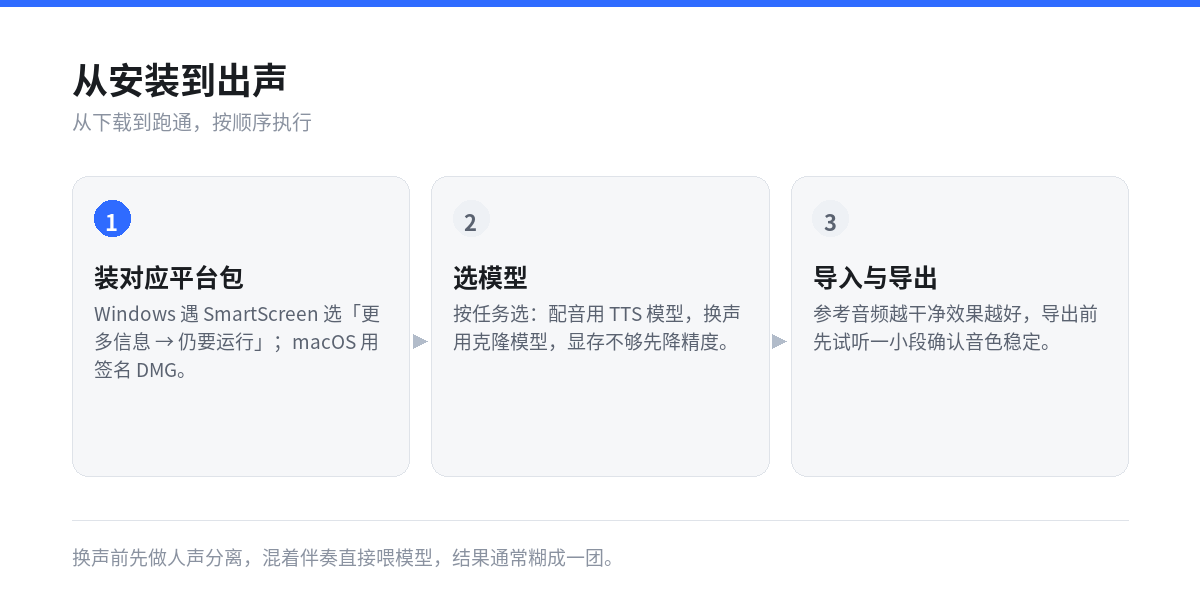
Windows 用户按提示绕过 SmartScreen;macOS 用 DMG 拖进应用程序;Linux 有 AppImage 和 deb。安卓包也在发布列表里,但手机上跑模型不现实,实际是当遥控端用。
显卡方面,NVIDIA 支持最完整,Intel Arc 在这一版被专门修过,AMD 走 Vulkan,昇腾 NPU 有检测但生态还在早期。
常见问题
免费吗? 软件免费开源,模型各自有许可,部分模型限制商用。
能商用配音吗? 取决于模型许可和声音来源授权,两者缺一不可。
和 RVC 的区别? RVC 偏「实时变声」,VoiceStudio 偏「工作台」,把 TTS、克隆、替换放在一起。
要联网吗? 模型下载完可以完全离线。
一句话判断
VoiceStudio 把本地语音的门槛降到了「装个软件」的程度,但「改歌」这件事的门槛从来不在软件,而在素材、音质和授权。
登录后可点赞、收藏与反馈。