OpenAI Codex 全景:把开发任务派给云端
Codex 的真正差异不在模型,而在组织方式:同一个 Agent 既能在终端陪改,也能被派到云端独立跑完再交回变更。本文拆解它的三种入口、审批模式与并行代价。
Codex 最容易被误读的地方,是把它当成"另一个会写代码的模型"。它真正的差异在组织方式:同一个 Agent 可以待在终端里陪你改,也可以被派到云端独立跑完一个任务,再把变更交回来。前者是工具,后者是工位。
三个入口,一套行为
Codex 有三种落地形态,彼此不是替代关系。
命令行版是开源的,采用 Apache 2.0 许可,通过 npm 或 Homebrew 安装,在仓库目录里启动就能进入会话。它适合交互式修改:你看着它读文件、改代码、跑测试,随时打断。
IDE 扩展把同一套能力放进编辑器侧栏,好处是上下文跟着当前文件走,不用在终端和编辑器之间来回切。
云端任务则是另一种东西:代码在远程沙箱里检出,Agent 独立执行,完成后把改动以可审查的形式交回。桌面端 codex app 提供了统一入口,登录既可以用 ChatGPT 账号,也可以用 API key。
三种形态共享同一套模型、同一套指令文件、同一套审批逻辑。这点很关键——它意味着你可以先在本地把任务调通,再原样丢到云端批处理,而不必重写一套提示词。
审批模式决定它能自己走多远
Agent 的可用性取决于"放手程度"能不能调。Codex 的做法是审批模式加默认开启的沙箱:在沙箱边界内,读写和命令执行可以自动进行;一旦要越界,比如访问网络、写工作目录之外的位置,就会停下来等确认。
这个设计与 Claude Code 的取向不同。Claude Code 更强调"规则前置"——用 settings.json 的 deny 规则和 hooks 把不可接受的动作提前封死,再谈自动化;Codex 更强调"边界内自治"——先把环境关进笼子,笼子里的事尽量不打扰人。前者适合规则复杂、合规要求细的团队,后者适合任务边界清晰、追求吞吐的场景。
实际使用中,两者都需要回答同一个问题:哪些动作出错的代价高到必须人工确认?把这个清单列出来,审批模式才有意义;列不出来,要么过度打扰,要么放任风险。
云端任务改的是协作节奏
把任务派到云端,真正变化的不是写代码的速度,而是等待的方式。
本地 Agent 是同步的:你盯着它跑,它卡住你就得处理。云端任务是异步的:派出去,去做别的事,回来收 diff。多个任务可以并行,每个都在独立环境里,失败了直接丢弃,不会污染本地工作区。
这种模式对任务类型很挑。适合的是"定义清楚、验收明确"的活:修一个能复现的 bug、给某个模块补测试、把一批调用从旧 API 迁到新 API、升级依赖并修掉编译错误。这类任务的共同点是有客观的完成标准,跑一遍测试就知道对不对。
不适合的是探索性工作:需求还没想清楚、方案要在试错中长出来、UI 要边看边调。这类活派出去,回来的大概率是一份"看起来很努力但方向不对"的改动,审查成本比自己做还高。
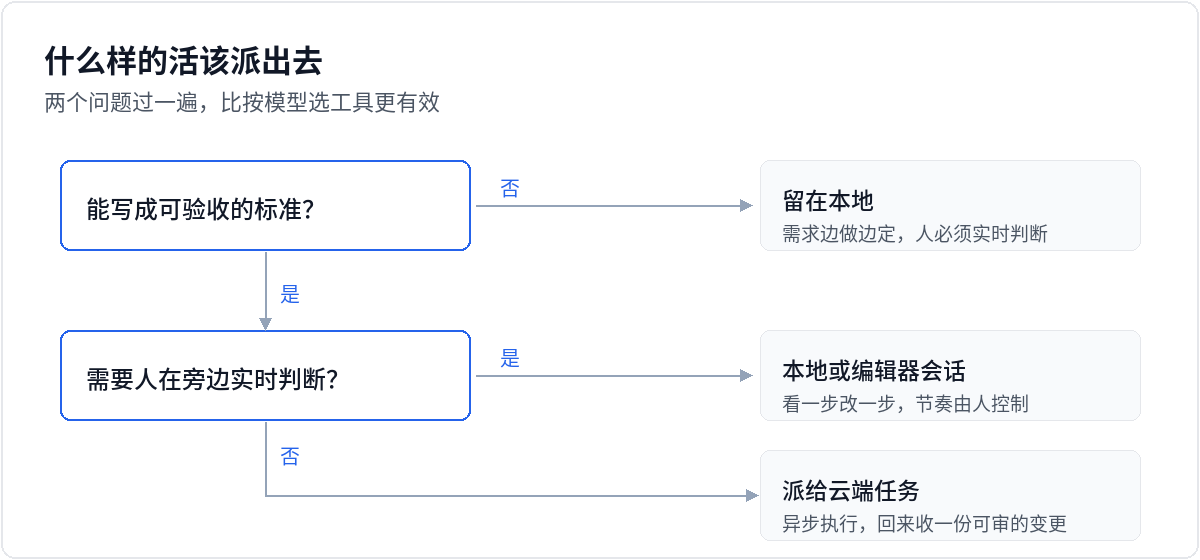
图 1 两个问题,判断一件事该不该派出去
并行会放大消耗,也会放大审查压力
云端任务按 token 计费,并行意味着多份上下文同时在被读取。一个几百文件的中型仓库,每个任务都要重新建立一遍代码理解,这部分开销不会因为并行而摊薄。
更现实的瓶颈是审查。三个任务同时回来,就是三份 diff 同时等人看。如果团队没有把测试和静态检查放在 CI 里做前置过滤,Agent 产出的量会迅速超过人能审的量,最后变成"批量点通过"——这比不用 Agent 更危险。
所以并行之前,先把三件事做掉:CI 必须能在 PR 上自动跑;任务描述里写清验收标准;每个任务改动控制在可审查的规模内。否则并行只是在制造积压。
和另外三条路线摆在一起看
| 维度 | OpenAI Codex | Claude Code | Cursor | GitHub Copilot 编码 Agent |
|---|---|---|---|---|
| 主要入口 | CLI、IDE、云端任务 | 终端、IDE 扩展、Web 会话 | 编辑器 | Issue 与 Pull Request |
| 执行位置 | 本地或远程沙箱 | 本地为主,可接云端会话 | 本地或云端 Agent | GitHub Actions 环境 |
| 约束方式 | 审批模式 + 默认沙箱 | 权限规则 + 沙箱 + hooks | 运行模式 + 终端白名单 | 仓库权限 + 分支保护 |
| 最擅长的活 | 可并行的明确任务 | 大仓库多文件改造 | 边看边改的日常开发 | 流程化的仓库维护 |
| 主要限制 | 模型绑定 OpenAI,云端闭源 | 模型绑定 Anthropic | 长任务不如云端并行 | 探索性任务偏弱 |
这张表的读法是:先看你的任务从哪个入口进来,再看你希望它在哪执行,最后才比较模型。反过来按模型选工具,通常会选到一个用不顺手的工作流。
三条判断标准
如果你手上的活能被写成一段清晰的验收标准,且不需要人在旁边实时判断,Codex 的云端任务是合适的——它的价值在"派出去以后不用管"。
如果团队已经在用 ChatGPT 的企业计划,Codex 的边际成本最低,因为账号体系、配额和审计都在同一处。
如果你需要非 OpenAI 模型、或者必须把执行环境完全握在自己手里,那 Codex 的云端部分不是好选择,得看开源自托管那条线。
顺带一提,Codex 这类"把任务派出去"的模式,前提是任务本身可度量。关于单任务成本怎么算,这篇关于 Agent 成本的拆解给出的口径比按 token 单价更接近真实开销;而当你同时放出多个自主任务时,OpenAI 自己对失控 Agent 的处置机制也值得先读一遍——可中断,才敢放手。
Codex 的竞争力不在模型跑分,而在它把"一个人同时推进多个任务"变成了可操作的工作方式。代价是审查能力必须跟上,否则并行只会把瓶颈从写代码挪到看代码。
登录后可点赞、收藏与反馈。