DeepSeek-V3.2 规格速查
671B MoE、每 token 激活 37B、128K 上下文、MIT 许可。DSA 稀疏注意力是这一代唯一的架构改动,它验证了后来 V4 把上下文推到 1M 的技术前提。
规格 SPECIFICATION
- 厂商
- 深度求索(DeepSeek)
- 参数规模
- 671B(每 token 激活 37B)
- 上下文长度
- 128K tokens
- 模态
- 文本
- 许可
- 开源
- 版本
- DeepSeek-V3.2
- 参考价格
- 权重免费(MIT 许可);API 已由 V4 系列承接
- 发布日期
- 2025-12-01
- 官网 / 文档
- 打开 ↗
- 收录时间
- 2026年11月9日
评测 BENCHMARK
- 官方称未发现 V3.2-Exp 在任一特定场景显著弱于 V3.1-Terminus;正式版推理能力被描述为达到 GPT-5 水平、略低于 Gemini-3.0-Pro,且输出长度显著低于 Kimi-K2-Thinking。第三方口径:SWE-bench Verified 约 70%,GPQA 约 82%。
说明 NOTES
DeepSeek-V3.2 是 2025 年 12 月 1 日发布的正式版开源模型,架构与 V3.2-Exp 完全相同,相对 V3.1-Terminus 只做了一处改动:通过持续训练引入 DeepSeek 稀疏注意力(DSA)。它的定位是日常问答与通用 Agent 任务,主打「推理能力够用、输出长度受控」。这篇笔记整理它的规格、这处架构改动带来的实际差别,以及在新一代 V4 系列上线后它还剩什么价值。
一、规格一览
| 项目 | 取值 |
|---|---|
| 厂商 | 深度求索(DeepSeek) |
| 模型版本 | DeepSeek-V3.2 |
| 参数规模 | 671B(MoE 总参数),每 token 激活 37B |
| 上下文长度 | 128K tokens |
| 模态 | 文本(输入与输出均为文本) |
| 许可 | MIT(权重与代码),可商用 |
| 发布时间 | 2025 年 12 月 1 日 |
| 分发方式 | 开源仓库(含权重)+ 官方 API |
| 同期版本 | DeepSeek-V3.2-Speciale(长思考增强,仅临时 API) |
需要区分一个容易混淆的点:V3.2 与 V3.2-Exp 不是递进关系,而是同一架构的两个阶段。Exp 是 9 月的实验版本,用于验证 DSA 机制;V3.2 是把验证结果固化后的正式版,训练设置与 Exp 严格对齐。
二、DSA:这一代唯一的架构改动
DSA 全称 DeepSeek Sparse Attention,核心是把注意力计算从「每个 token 与全部历史 token 相乘」改为「先筛选、再加权」。它要解决的是长文本下注意力成本随长度平方增长的问题,方向上与后来 V4 系列的 KV Cache 压缩属于同一类思路,只是手段更早、更保守。
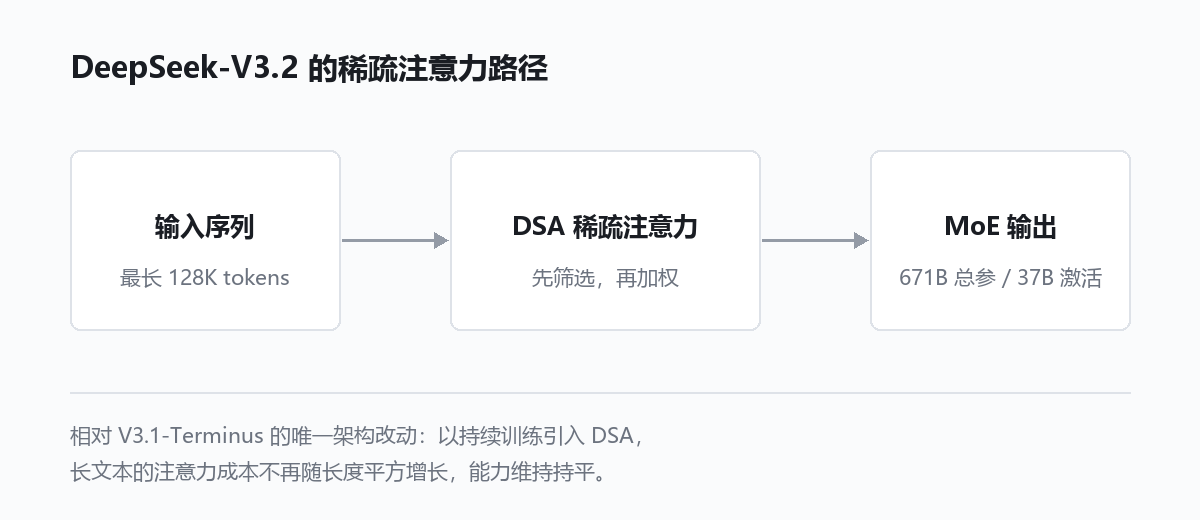
官方给出的验证结论是:未发现 V3.2-Exp 在任何特定场景中显著差于 V3.1-Terminus。这句话的分量在于「任何场景」——稀疏化最怕的是某些长尾任务悄悄退化,而官方口径是长文本效率提升的同时能力持平。
这也解释了为什么正式版没有继续加架构改动。在 671B 这个体量上,一次架构变更的验证成本极高,把已经验证过的改动固化下来、把算力投到后训练,是更稳的选择。
三、与 Speciale 的分工
同期发布的 V3.2-Speciale 是长思考增强版,结合了 DeepSeek-Math-V2 的定理证明能力,在数学与竞赛编程上达到很高水平,官方称其拿下 IMO 2025、CMO 2025、ICPC World Finals 2025 与 IOI 2025 金牌。
但两者的使用边界很清楚:
- V3.2 标准版:日常问答、写作、通用 Agent,支持工具调用,输出长度受控
- V3.2-Speciale:仅以临时 API 形式开放,供评测与研究,不支持工具调用
代码场景里这个差异很实际。需要模型反复调工具、读文件、改代码的流程,只能用标准版;Speciale 在复杂数学题上更强,但它不能接入工具链,成本也高出一个量级。
四、现状与迁移建议
截至本文写作时,DeepSeek 官方 API 已切到 V4 系列,旧模型名不再单独计价。V3.2 的价值因此转移到两条路径上。
第一条是开源权重。MIT 许可允许商用与二次开发,权重可从 Hugging Face 获取。对数据不能出内网、或需要固定版本长期运行的场景,这仍是成本最低的选项——没有任何按 token 计费的不确定性。
第二条是作为对照基线。评估新模型时,用同一套 50 条样本跑一遍 V3.2,能快速判断新一代在指令遵循、结构化输出上的增益是否真实。它的能力曲线已经被社区反复测量过,做基准比用未验证的模型更可靠。
至于原来调用 V3.2 的线上服务,迁移时只需改模型名,接口协议保持不变(OpenAI 兼容格式)。真正需要重测的是提示词:V4 系列默认开启思考模式,长系统提示下的行为与 V3.2 不一致,直接切换可能出现输出变长、格式漂移。
模型库的价值不只在于记录最新型号。像 V3.2 这样处于架构转折点上的版本,往往比旗舰更能说明一家厂商的技术路线——DSA 的验证结果,直接决定了后来 V4 敢把上下文推到 1M。
登录后可点赞、收藏与反馈。