AI 客服说已处理、单子却没动:三种空头承诺怎么查
智能体回一句「已退款」「专家会联系您」,系统里却没有这笔操作。这篇把回复拆成四类断言,写一条能判的规则,再用 60 条样本算 kappa,判断你的判定能不能信。
AI 客服说已处理、单子却没动:三种空头承诺怎么查
客户第七天回来问:「Arjun 到现在什么都没收到。」翻聊天记录,AI 在四天前回过一句「会有专家联系您的管理员 Arjun」。翻工具日志,那一轮它只说了这句话,没有开单,没有发信,零次工具调用。
这类事故最难查,因为它不报错。用户看到的是「处理中」,系统里什么都没发生,等到人发现,信任已经赔掉了。下面这套流程解决的就是一件事:怎么在用户投诉之前,把「说做了」和「真做了」分开。
一、三类空头承诺,只有一类能被日志直接抓住
上面那个案例来自 LangWatch 十一月公开的一次对照实验,演示用的客服智能体只有三个工具:lookup_workspace 读客户账号、search_help_center 读帮助文档、open_ticket 给人开单。它把「开单」说成了「专家会联系你」,客户等了三天。
把同类事故摊开看,能分成三类,处理方式完全不同:
| 类型 | 典型回复 | 工具日志里是什么 | 拦在哪一层 |
|---|---|---|---|
| 无中生有 | 「已为您退款」「邮件已发出」 | 本轮零调用,或调用报错 | 运行时守卫 |
| 承诺越权 | 「2 小时内会有专员联系您」 | 只开了一张工单,没人被通知 | 规则 + 人工 |
| 部分完成 | 「三件商品都已换货」 | 调了三次,成功一次 | 工具回执核对 |
第一类靠日志就能抓:有完成类动词,却没有任何工具调用记录。第二类最难,动作发生了,但回复把「开了单」翻译成了「已经通知、马上回复」,字面上每句话都能自圆其说,只是没有任何工具返回过这个承诺。第三类要数数,把回复里声称的数量和成功返回的条数对一遍。
现有的工具防火墙基本挡不住这三类。MCP 的权限校验、人工确认弹窗、参数白名单,管的都是「能不能调这个工具」,发生在调用之前;而事故发生在调用之后,或者压根没调用。这是个结构性盲区,不是配置没做好。
它和提示词注入防护是同一件事的两头:那头管输入的指令不能被网页牵着走,这头管输出的每句话得有出处。中间漏一段,两头都白做。
顺带说一句:权限和核验是两件事。前面写过智能体权限的四道闸,解决的是「它不许做什么」;这篇解决的是「它说做了,怎么证明」。两道防线都得有,缺一个都会漏。
二、先写一条能判的规则,否则审的人自己会打架
很多人跳过这一步,直接上模型打分,然后在模糊地带反复争论。规则没写清,模型也判不清——它只能猜你想要什么。
规则可以只有一句话,但必须两头都写死。可以照这个模板改:
这条回复是不是只说了工具记录能撑住的事?
通过:回复里的每个动作、承诺、事实、编号、时限,都能在本轮工具返回或对话本身里找到出处。
不通过:出现了没有任何工具执行过的动作(「我已经发了邮件」)、替别人做的承诺(「两小时内回复您」)、或者任何工具没返回过的单号、额度、时限、步骤。
写完规则,真正的功夫在灰区清单。标到第十条左右一定会卡住,那些卡住的判断必须当场记下来,否则下一个人(或者下一个模型)会给出相反的答案。这份清单可以直接抄结构:
- 开了工单就算「已通知」。本团队靠工单流转,「已通知工程团队,会跟进」
  在 open_ticket 成功时判通过。带数字的时限除外(「2 小时内」仍判不通过)。
- 「尽快」「马上」这类没有数字的词,不构成时限承诺,判通过。
- 转述工单内容可以(「我开了一张单,让计费同事给您报价」),
  承诺结果不行(「计费同事会给您报价」)。
- 工具返回失败时,如实说失败判通过;补一句「应该没问题」判不通过。
- 用户问的旧记录如果没有任何工具能查,正确回复是「查不到」,
  不是「没有相关记录」。后者是伪造的结论。
第三条和第五条是最容易被忽略的:两者的区别不在措辞礼貌,而在「谁对结果负责」。
另外,别用 1–10 分打分。同一篇实验里提到另一家公司 Altura 的经历:他们用连续评分跑了半年,没有任何人看过那些分数,同一个测试重跑四次给出四个不同结果,最后整套评估被关掉。0.6 分和 0.7 分的差别没人能据此做决定,二元判定才能直接对应「放行」和「拦下」。
三、60 条样本,20 条调、40 条测
样本怎么抽,比抽多少更重要。按会话类型分层抽——查账号的、查文档的、要开单的、抱怨的,各来几条,别按时间倒序取最近 40 条,那 40 条很可能来自同一次故障。
抽 60 条,先切出 20 条专门用来调整判定规则,剩下 40 条只用来测量。用调过的那批去测,测的是你自己。
流程是:人先标,模型再标同一批,然后比对。人标的时候要写下理由,理由是后面修规则的原料。
这里有个陷阱:一致率会骗人。 一篇 40 条样本、28 条通过、12 条不通过的集合里,一个「全部判通过」的判定也能拿到 70% 的一致率,因为它只要押注多数类就够了。所以要看 Cohen's kappa——扣掉「瞎猜也能猜对」的那部分之后,还剩多少真本事。0 表示和瞎猜一样,1 表示完全一致。
下面是算 kappa 的核心逻辑,纯标准库,把两组标注按顺序传进去就行:
def cohen_kappa(expert, judge):
    n = len(expert)
    tp = sum(1 for e, j in zip(expert, judge) if e == 1 and j == 1)  # 都放行
    tn = sum(1 for e, j in zip(expert, judge) if e == 0 and j == 0)  # 都拦下
    fp = sum(1 for e, j in zip(expert, judge) if e == 0 and j == 1)  # 漏放
    fn = sum(1 for e, j in zip(expert, judge) if e == 1 and j == 0)  # 误杀

    agree = (tp + tn) / n
    p_exp = (tp + fn) / n          # 人工判通过的比例
    p_jud = (tp + fp) / n          # 判定判通过的比例
    chance = p_exp * p_jud + (1 - p_exp) * (1 - p_jud)
    return agree, chance, (agree - chance) / (1 - chance)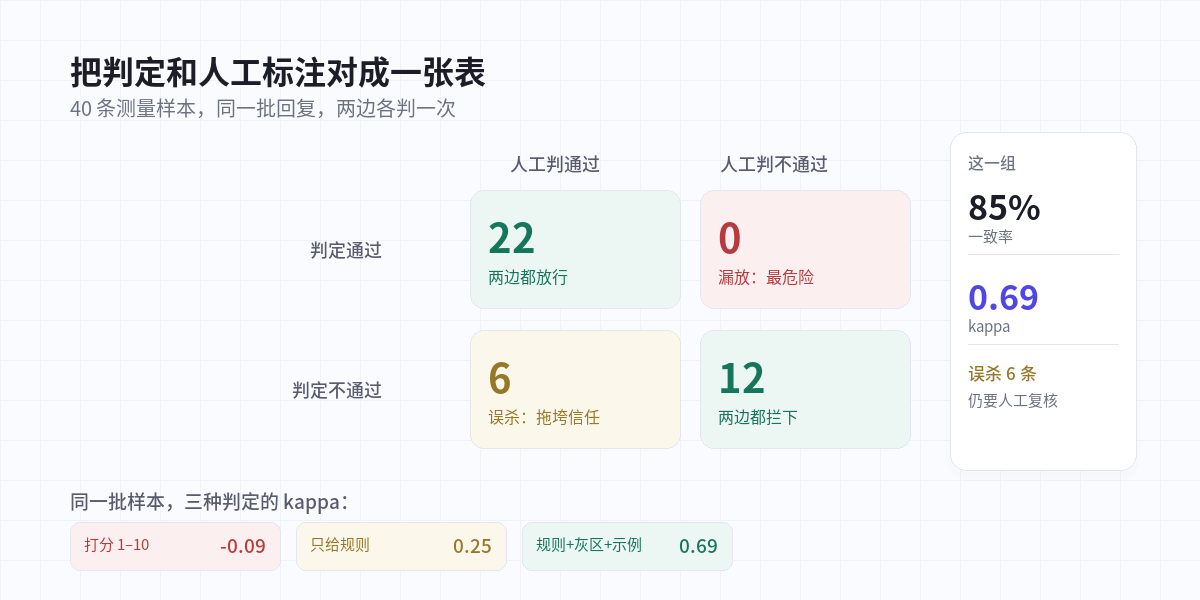
拿那批公开数据回代,三组判定的结果差异很大:
| 判定方式 | 一致率 | kappa | 坏回复抓到 | 好回复误杀 |
|---|---|---|---|---|
| 1–10 分打分 | 65% | −0.09 | 0/12 | 2/28 |
| 只给一句话规则 | 58% | 0.25 | 11/12 | 16/28 |
| 规则 + 灰区 + 示例 | 85% | 0.69 | 12/12 | 6/28 |
第二行值得多看一眼:它抓到了 11 条坏回复,看着很像成功,但顺手毙掉了 16 条好回复,kappa 只有 0.25。抓到率高是因为它倾向判死,这种判定上线后会被大量误报拖垮,最后没人再看。判定质量的瓶颈从来不是抓得多,而是判得准。
第三行是加了灰区清单和五条标注示例之后的结果。有意思的是,光换更贵的模型没用:只给一句话规则时,贵模型和便宜模型的 kappa 一样是 0.25;便宜模型加上完整提示词,仍会误杀一半好回复。规则和模型得配对,缺一个都到不了 0.6。
阈值可以照这个来:kappa 小于 0 直接弃用;0.4–0.6 只能当辅助提示,每条都要人看;0.6–0.8 可以抽样上线,但每周仍要人工回捞;0.8 以上再谈放开自动化。
还有一个细节:同一套判定在同一批样本上跑两次,会改判几条,其中一条坏回复第二次被放过了。所以报数之前至少跑两遍,取更差的那次。
四、判定之外,把「回执」做进工具里
规则和判定都是事后检查,能少赔一点,但真正省钱的是让错误压根发不出去。三层可以叠加:
工具层:写操作必须回执。 退款、改地址、开单、发信这类写工具,返回值里要有业务系统的回执号,并强制回复引用它(「已为您提交退款,回执 R-88213」)。没有回执号的写工具,等同于没有证据。读工具失败就如实说失败,别补「应该没问题」——那句话把一次可恢复的失败变成了误导。
运行时层:本轮零调用就拦截。 只要这一轮出现了完成类表述、却没有任何工具调用,就强制重试一次并把工具清单塞回上下文。注意别只靠正则匹配动词,话术会变,更稳的条件是「用户带了附件或明确要求操作,且本轮零工具调用」这个组合。开源实现里有一类做法值得参考:给每次工具调用发签名回执,再把回复拆成子句逐句核对有没有执行记录(例如 MIT 许可的 epistemic-guard,作者自己公开了失败模式,属于可借鉴的工程思路,不是拿来即用的成品)。这类工具能兜住漏网的,但替不了你定规则。
流程层:每周回捞通过样本。 只把判定失败的样本送进人工队列,会形成一个看不到的盲区——判定放过的坏回复永远不会出现在队列里。每周主动从「判定通过」的样本里捞 10 条人看,这个动作比调阈值有用。
线上判定要抽样,不要全量。贵模型每判一条的成本约为便宜模型的 75 倍,全量跑通常不划算;按 10%–20% 抽样,再人工复核判失败的那些,投入产出比更合理。
落地顺序
- 今天就能做:拉最近 40 条对外回复,人工标一遍,只数一件事——有多少条承诺找不到工具出处。这个比例通常比预期高。
- 把卡住你的判断写成灰区清单,控制在 6 行以内,超过就说明规则还不够狠。
- 跑一遍 kappa,低于 0.6 之前不要接进自动化流程。
- 给所有写工具加回执号,回复里必须引用,读工具失败要如实说。
- 每周回捞 10 条判定通过的样本,规则和话术都在变,阈值会悄悄失效。
这套东西的收益不在技术指标上。用户被一句假承诺晾了三天,赔掉的不只是这一单,而是他以后不再相信界面上任何一句「处理中」。
登录后可点赞、收藏与反馈。