#评测方法
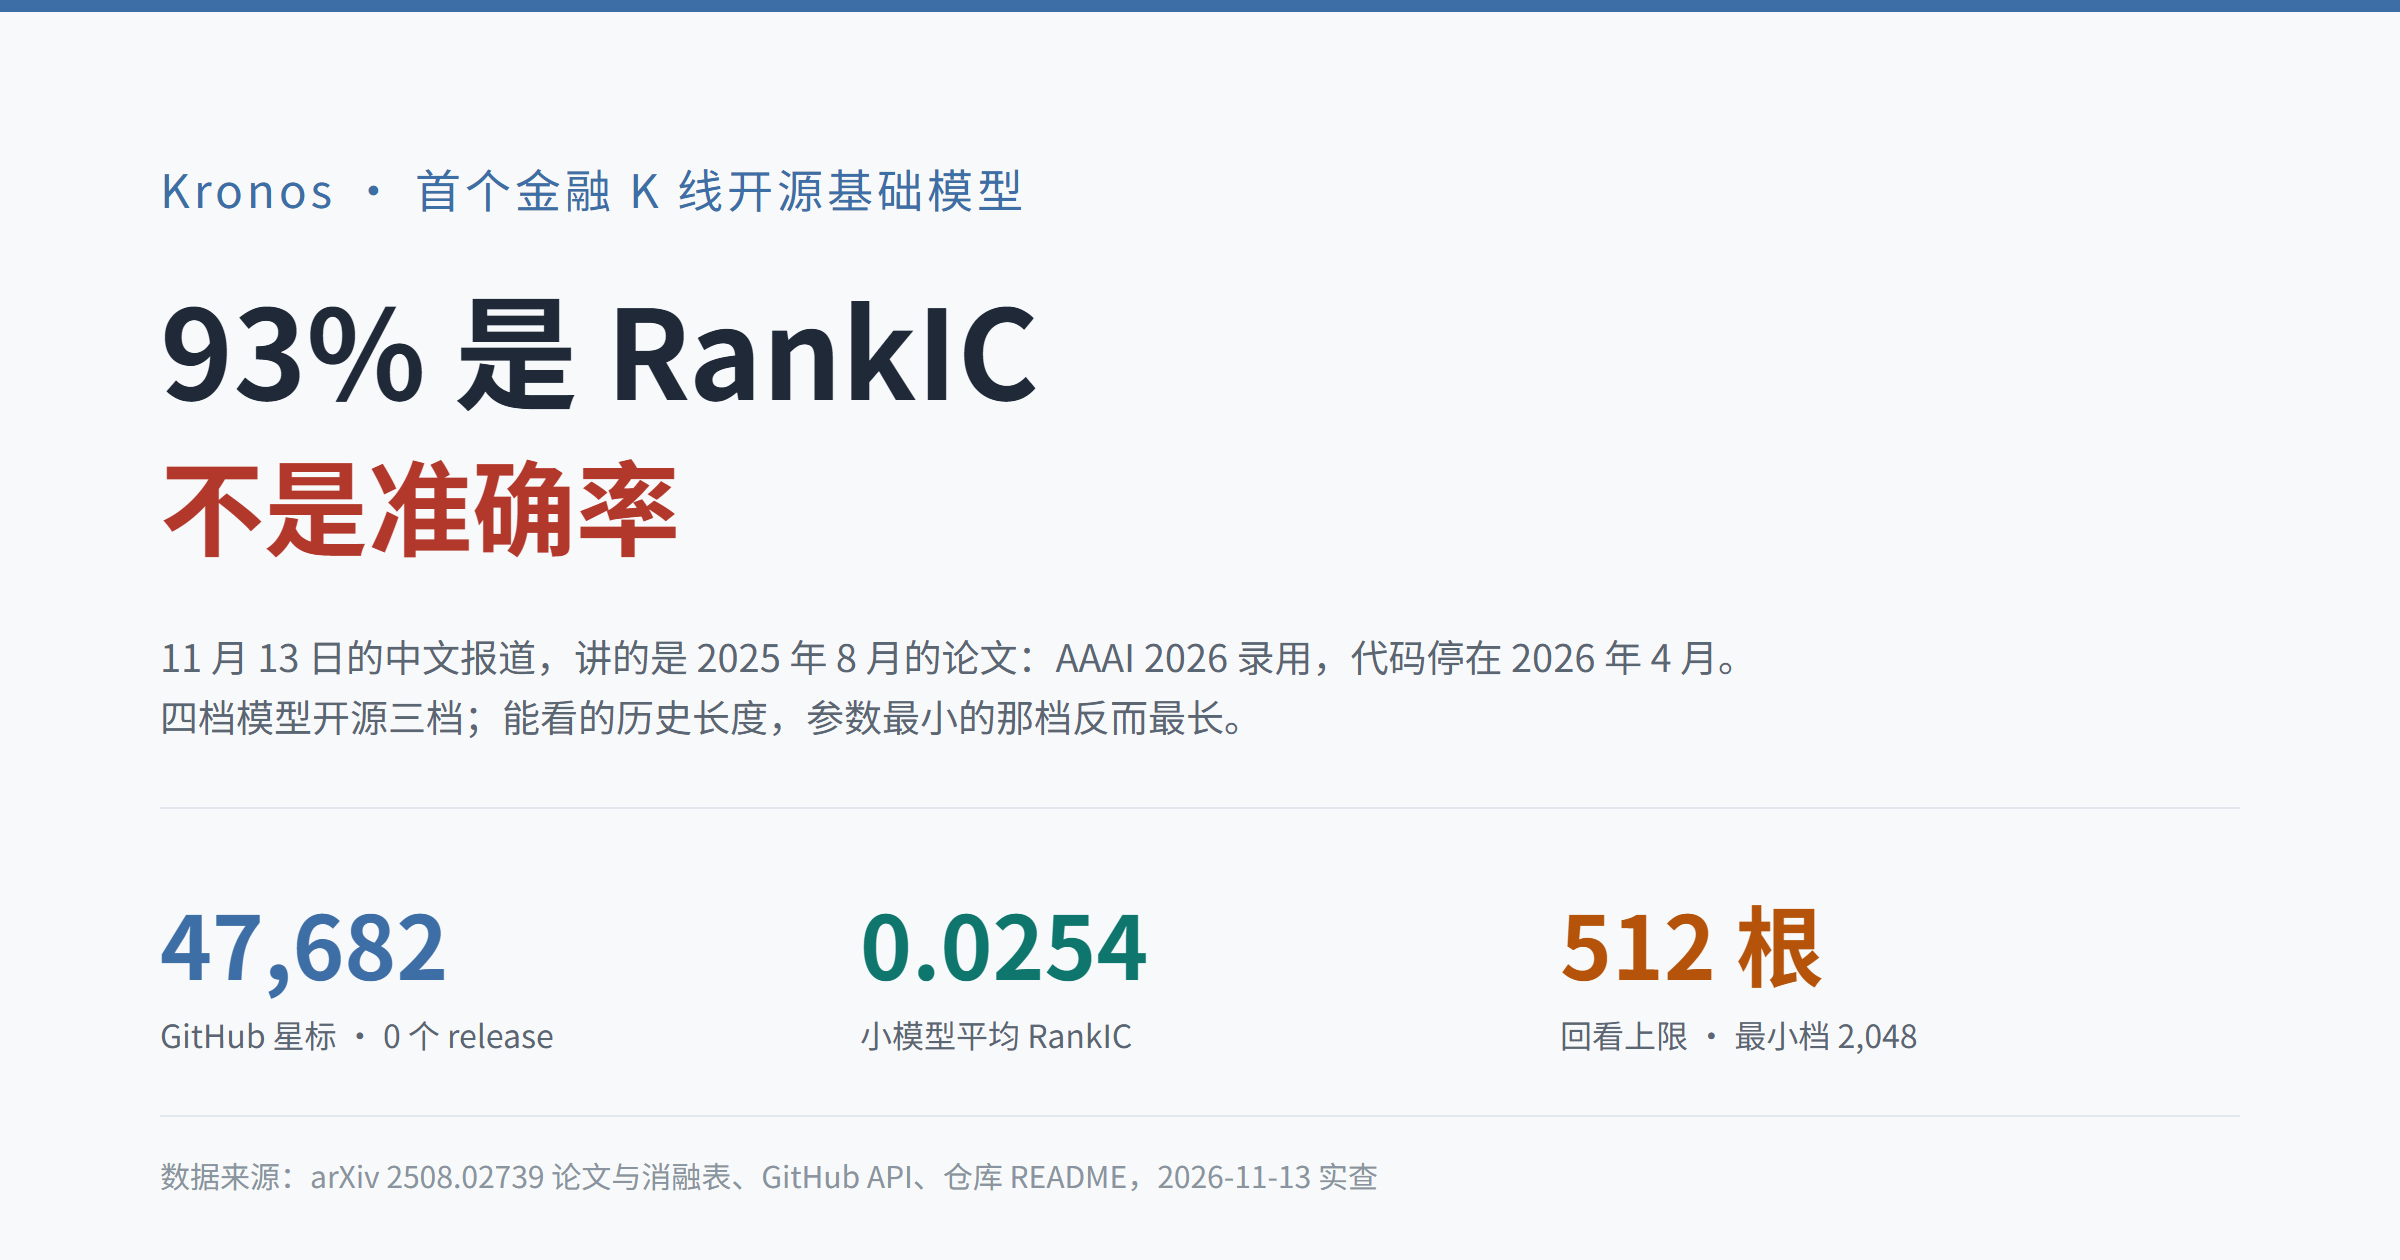
Kronos K 线模型:93% 是 RankIC,不是准确率
11 月 13 日报道的 Kronos 其实是 2025 年 8 月的论文:AAAI 2026 录用,代码停在 2026 年 4 月。本文把 93% 的 RankIC 提升还原成绝对值 0.0254,并算清 512 上下文与换手成本。
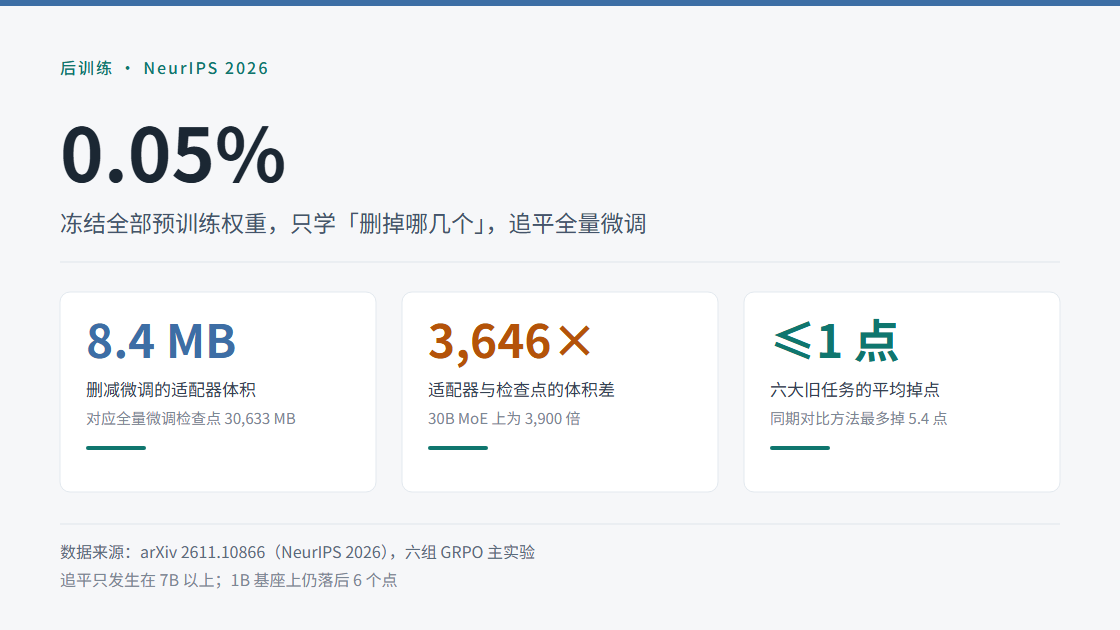
删掉 0.05% 权重追平全量微调,适配器只剩 8.4MB
NeurIPS 2026 的 Deletion Tuning 冻结全部预训练权重,只把不到 0.05% 的权重置零,在 8 个基座上追平全量微调。本文拆开机制、7B 门槛与三处不能照抄的地方。
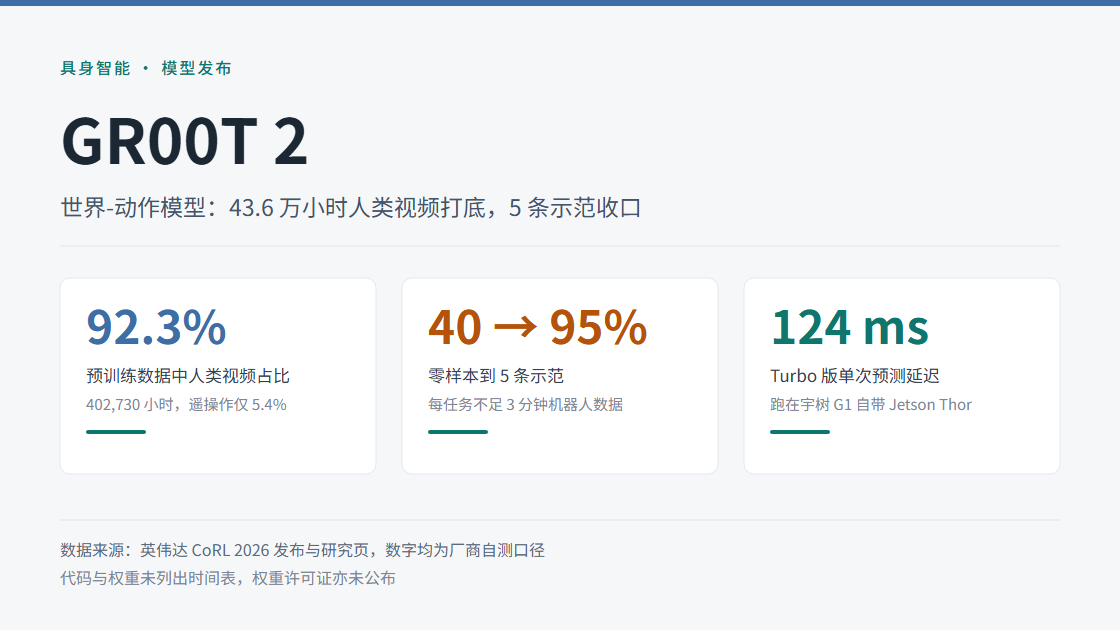
英伟达 GR00T 2:43 万小时视频,只换来 40% 零样本
英伟达在 CoRL 2026 发布 GR00T 2 世界-动作模型,预训练 43.6 万小时数据里 92.3% 是人类视频。零样本成功率 40%,一条示范到 71%,五条到 95%;而智能体等待占回合 38%,把有效吞吐压到 59%。
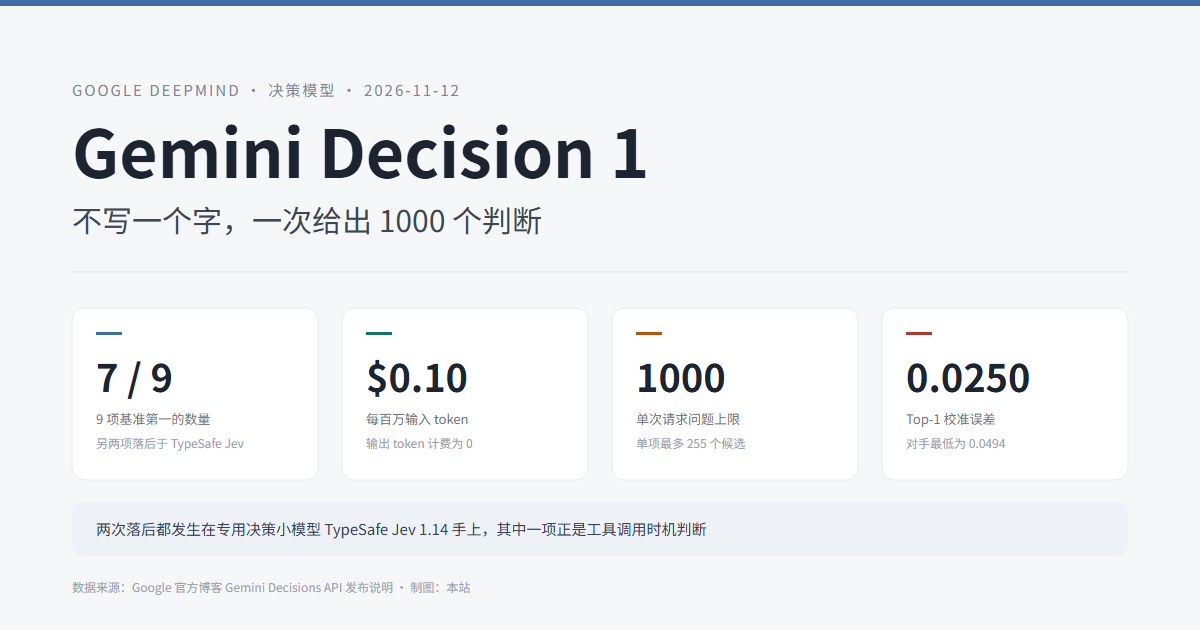
Gemini Decision 1:7 胜 2 负,单次请求 0.6 美分
谷歌发布首个专做封闭选项判断的模型:一次请求最多评分 1000 个问题,只按输入计费;9 项基准 7 项第一,两项输给专用决策小模型,校准误差低一个量级。
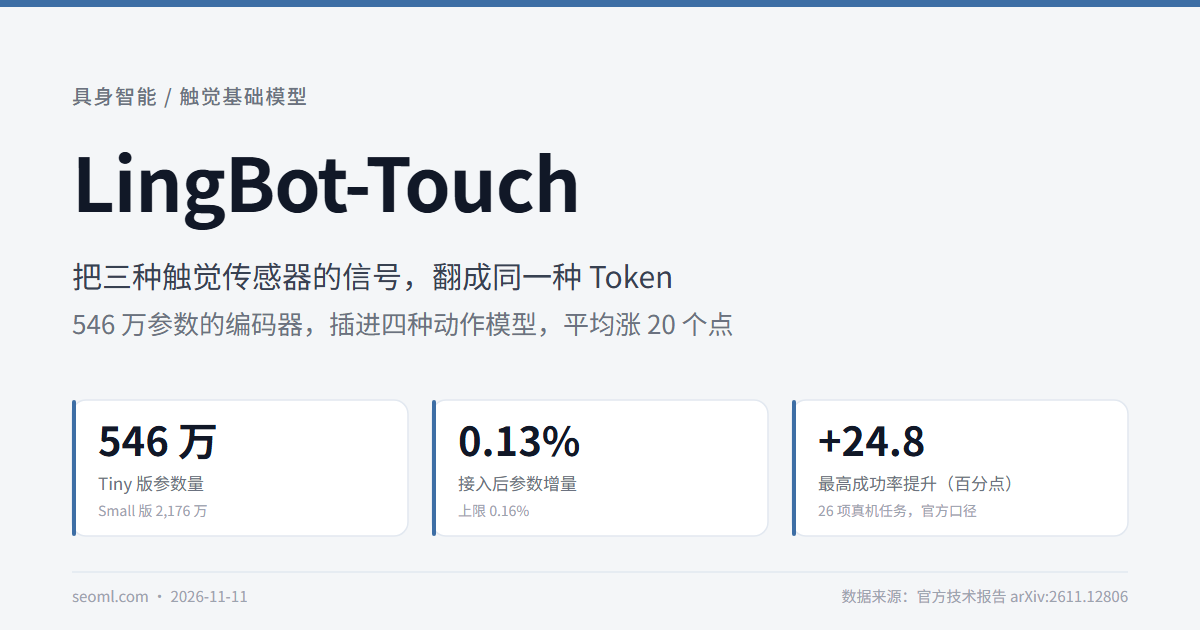
LingBot-Touch:0.13% 参数换 25 个点
蚂蚁灵波开源触觉基础模型,用 4983 小时真实触觉数据训出 546 万参数的编码器,插进四种动作模型平均涨 20 个点。拆开看它凭什么跨传感器通用,以及开源只开到哪一层。
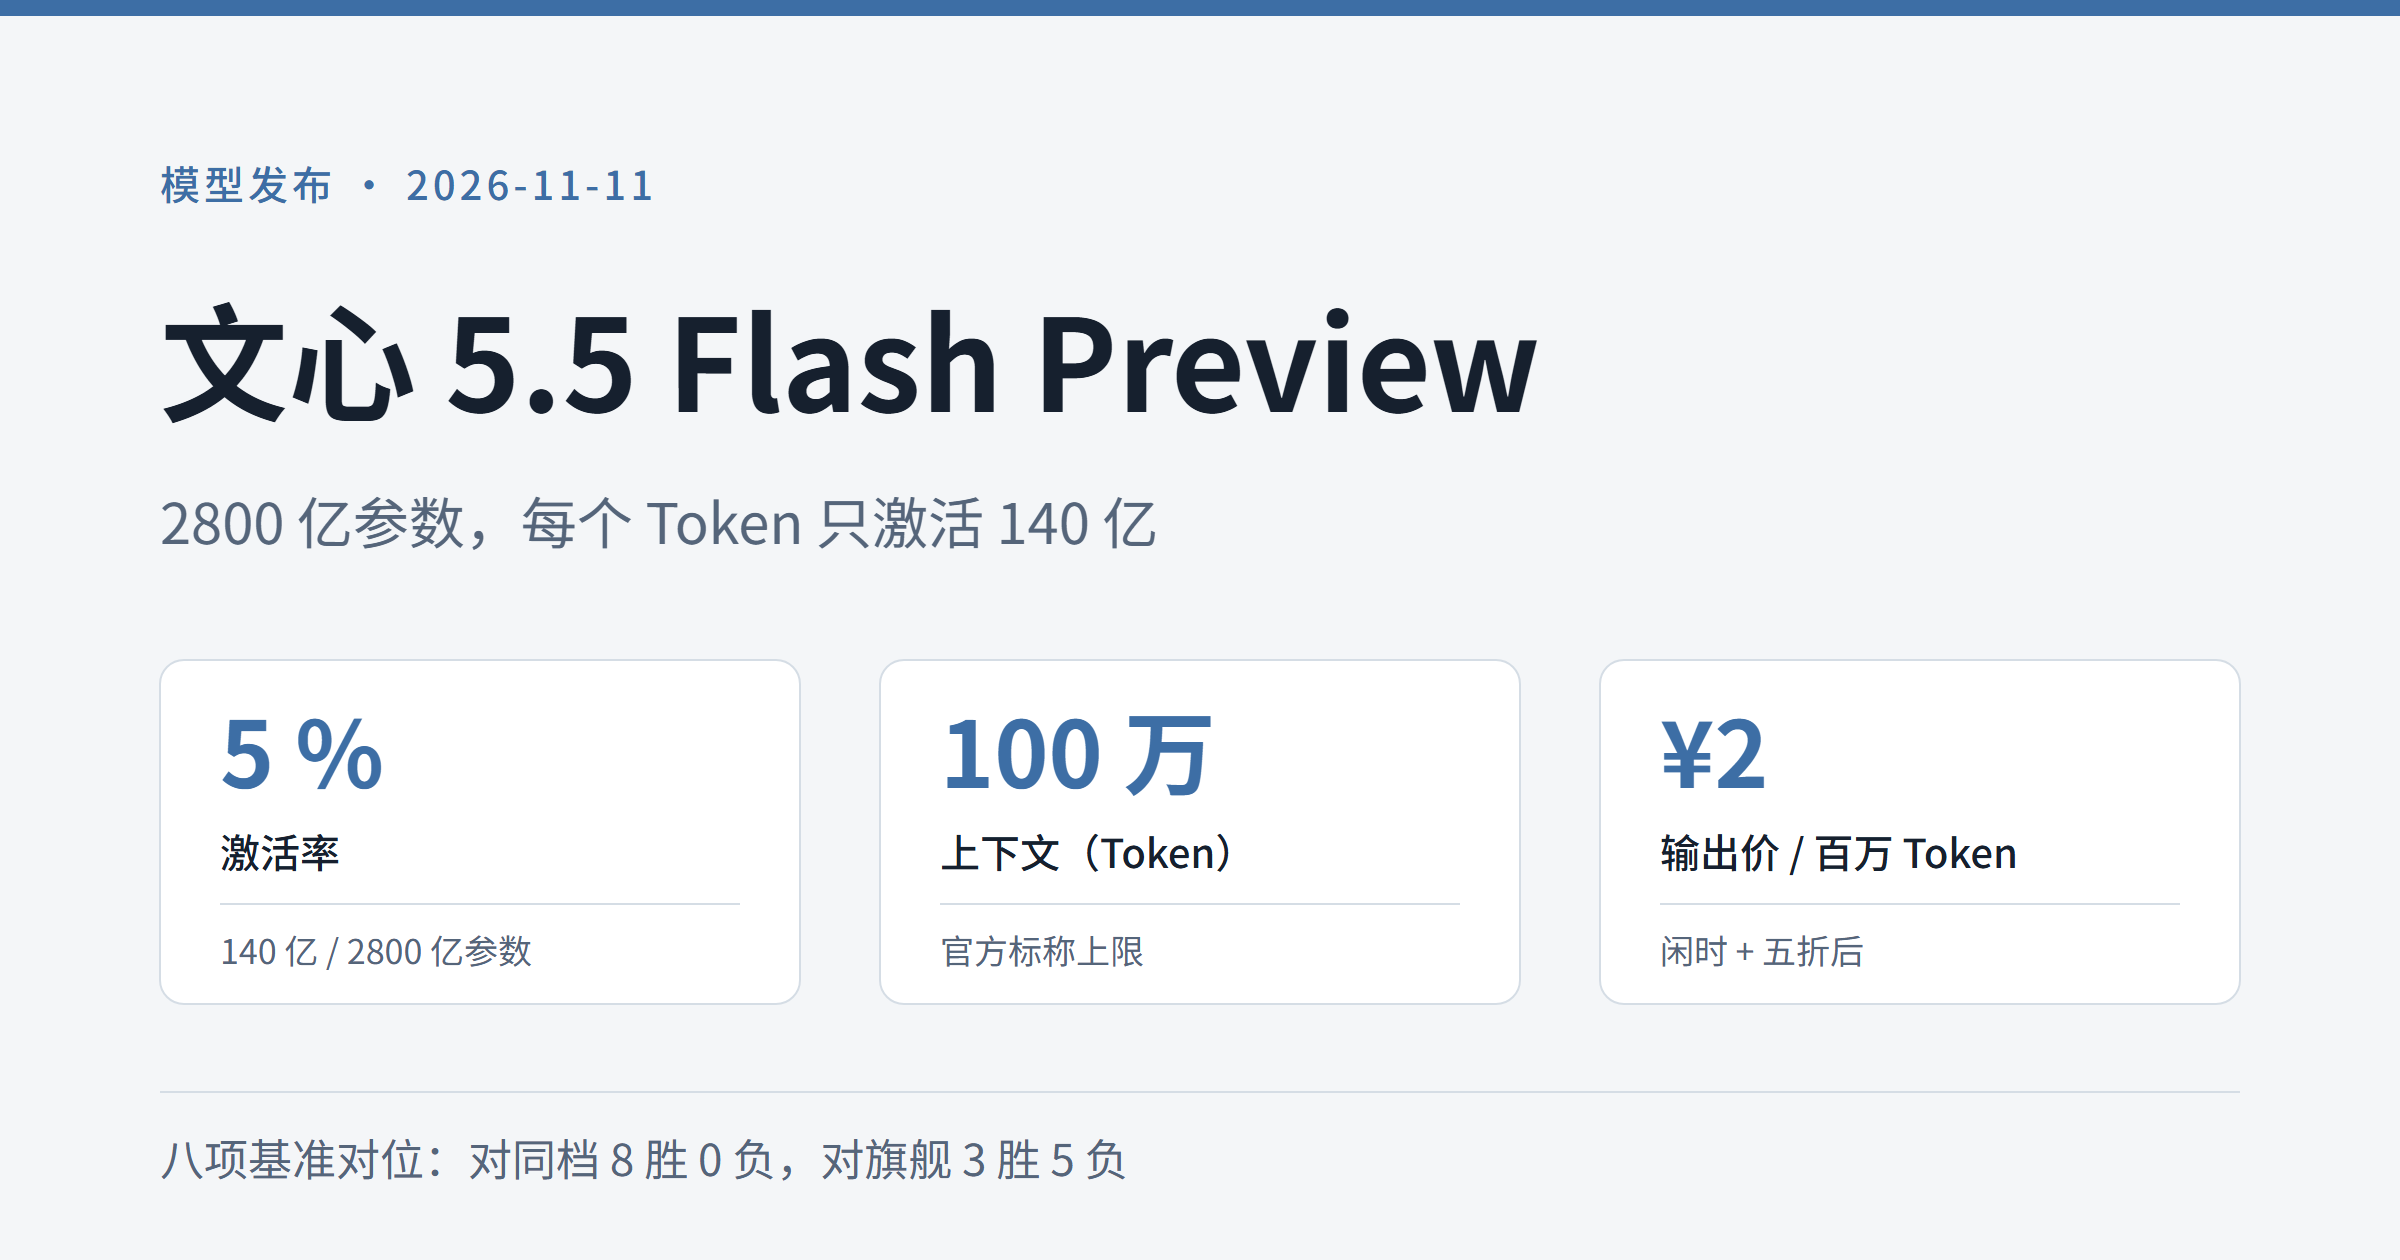
文心 5.5 Flash:同档全胜,旗舰只赢办公
文心 5.5 Flash Preview 把 8 项基准的对手拆成同档与旗舰两组:对同档 8 比 0,对旗舰只赢办公三项。输出价闲时折后每百万 Token 2 元,一小时 1.44 元。
DeepSeek-V3.2 规格速查
深度求索(DeepSeek)
671B MoE、每 token 激活 37B、128K 上下文、MIT 许可。DSA 稀疏注意力是这一代唯一的架构改动,它验证了后来 V4 把上下文推到 1M 的技术前提。
- 参数
- 671B(每 token 激活 37B)
- 上下文
- 128K tokens
- 价格
- 权重免费(MIT 许可);API 已由 V4 系列承接
- 模态
- 文本
DeepSeek-V4.1-Flash 规格速查
深度求索(DeepSeek)
552B MoE、1M 上下文、输入 8B / 输出 16B 非对称激活,配分级定价与一笔真实调用成本账。把 V4.1-Flash 的规格、结构变化与适用边界整理成可核对的条目。
- 参数
- 552B(MoE 总参数,输入激活约 8B / 输出激活约 16B)
- 上下文
- 1M tokens(最大输出 384K)
- 价格
- 缓存命中 0.02–0.04 元;未命中 1–2 元;输出 4–8 元(每百万 tokens,空闲为高峰半价)
- 模态
- 多模态