AI 生成的代码能商用吗:两道扫描与一份留证
许可证义务跟着代码走,不跟着谁写的走。用真实 GPLv2 代码实测:依赖扫描全绿、逐字比对 0.068、结构指纹 0.623 才抓到。附分级、留证与交付话术。
交付前客户法务发来一张表:列出项目里所有第三方代码和对应许可证,并说明哪些由 AI 生成。团队手里只有一份 requirements.txt。清单能列,但"这段代码是不是从别处搬来的"没人答得上来。
这篇按三层拆:依赖、片段、归属。结论先给:许可证义务跟着代码走,不跟着谁写的走。
先把三个问题分开
"AI 代码能不能商用"其实是三个问题挤在一起,各自有一条能查的证据线。
| 问题 | 证据从哪来 |
|---|---|
| 装了哪个包 | 包元数据(pip-licenses、syft) |
| 源码里有没有别人的片段 | 文本相似度(指纹、SCANOSS) |
| 这段代码你有没有版权 | 提交记录、人工改动、登记材料 |
第一个和第二个能扫,第三个扫不出来。
以 GPLv2 为例,这份许可协议第 0 条把"基于该程序的作品"定义成「a work containing the Program or a portion of it, either verbatim or with modifications」。原文和改过的都算。
也就是说,改函数名、调语句顺序、加注释,在定义上仍然是"基于该程序的作品"。义务不因此消失。这不是法律意见,是条文本身。
反方向还有一层。美国版权局 2025 年 1 月 29 日发布的《Copyright and Artificial Intelligence》第二部分认为:版权只保护人类作者身份,纯 AI 生成的内容不受保护;仅提供提示词不构成充分的人类控制。
含义是,一段完全由模型产出、你没有实质修改的代码,你可能既不能禁止别人使用,也很难作为资产去主张。
两个方向的风险相反:抄进来的,你承担别人的义务;纯生成的,你拿不到自己的权利。用一套话术应对两件事,通常两边都说不清。
第一道扫描查依赖:全绿也可能什么都没查到
我建了一个最小项目验证。requirements.txt 只有两个包:
rapidfuzz==3.14.1
python-dateutil==2.9.0.post0
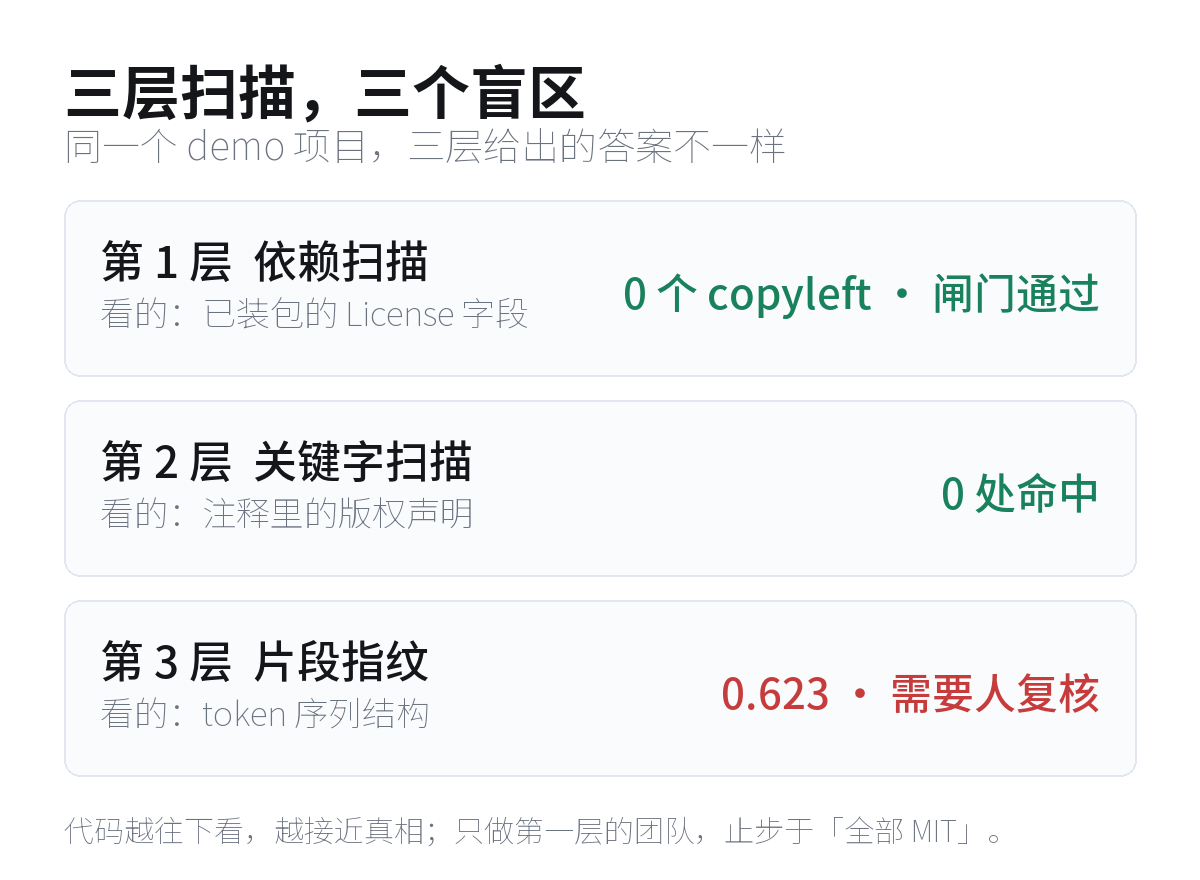
pip-licenses 的结果是:RapidFuzz 3.14.1 为 MIT,python-dateutil 为 Apache + BSD,连带装进来的 six 为 MIT。三个包,没有一个 copyleft。
再加一道闸门:pip-licenses --fail-on "GPL;LGPL;AGPL",退出码 0,通过。
同一个项目的 textnorm.py 里,有一段从 GPLv2 项目搬来的函数。改了函数名和变量名,重排了版式,还加了中文注释。
对它做源码级关键字扫描,统计 GNU|GPL|copyleft|copyright 的命中行数,结果 0。
两层都绿了。原因不复杂:pip-licenses 读的是安装树里的包元数据。它知道你装了 RapidFuzz,不知道你粘过什么。源码关键字扫描看的是注释,而动手复制的人,第一件事就是删注释。
再补一道片段指纹,同一个文件的结构相似度是 0.623。这个数怎么读,下一节展开。
| 层次 | 看什么 | 一定看不见 |
|---|---|---|
| 依赖扫描 | 已安装包的 License 字段 | 源码片段、复制进来但未安装的代码 |
| 关键字扫描 | 注释里的 SPDX 与版权声明 | 去掉声明头的复制 |
| 片段指纹 | token 序列或代码结构 | 重构后的衍生作品 |
三层不是替代关系,是串联关系。少一层,就多一个盲区。很多团队只做第一层,得出"全部 MIT"的结论,然后把它当成"代码干净"。
第二道扫描查片段:0.000 和 0.623
片段检测的原理不神秘:把源码切成 token,去掉注释和空白,取连续 k 个 token 做指纹,再看两段代码的指纹有多少重合。MOSS 是这个思路,商业的 SCANOSS、开源的 scancode-toolkit 也在同一方向。
我用真实 GPLv2 代码做了一组对照。语料取自 PyPI 上 fuzzywuzzy 0.18.0(GPLv2)的 partial_ratio 函数,约 35 行。
然后准备五个目标:
- A:原样粘贴
- B:改掉所有函数名、变量名,重新排版
- C:在 B 的基础上插入中文注释、调换独立语句顺序
- D:重构——拆辅助函数、换循环写法、提前返回
- E:按同样需求另写一版,穷举窗口,不用原实现的对齐技巧
用同一套 k=6 指纹,分别算"保留标识符"和"抹掉标识符只看结构"两个分数:
| 改法 | 逐字指纹 | 结构指纹 |
|---|---|---|
| A 原样 | 1.000 | 1.000 |
| B 改名 | 0.068 | 0.908 |
| C 加注释 | 0.034 | 0.723 |
| D 重构 | 0.014 | 0.492 |
| E 独立实现 | 0.000 | 0.194 |
三个读数值得记住。
一、逐字比对基本没有用。 只把名字改掉,分数从 1.000 掉到 0.068。凡是"搜某一行代码在不在库里"的检查,都过不了这一步。
二、结构指纹能穿透改名和注释,但穿不透重构。 B 还有 0.908,C 有 0.723,D 掉到 0.492。而 D 依然是衍生作品:同一个对齐技巧、同样的分支条件,只是换了写法。工具会给它判 ok。
三、阈值没有想象的厚。 拿 60 个毫无关系的 Python 文件当背景,结构指纹平均 0.199、中位 0.154、最高 0.531;真命中是 0.623。两者只隔 0.09。样本再大一点,很可能撞上。
核心逻辑只有十几行,可以自己写:
def shingles(tokens, k=6):
    return {" ".join(tokens[i:i + k]) for i in range(len(tokens) - k + 1)}

def containment(a, b):
    return len(a & b) / min(len(a), len(b))
所以这类工具的正确用法是:把 0.6 以上当成"请人看一眼"的名单,把 0.6 以下当成"没查出来",而不是"干净"。误报和漏报同时存在,只是方向不同。
一个容易忽略的细节:结构指纹抹掉标识符以后,两个都叫 parse 的无关函数会天然相似。所以它给你的分数是筛查信号,不是相似性判决。真到了纠纷,判断标准是实质相似,人来做。
扫不出来的时候靠什么
三道扫描之外,真正决定能不能商用的是三件流程上的事。它们决定的是合规能不能重复,而不是这一次能不能过关。
分级。 把许可协议按风险分三档,用 SPDX 标识符写成白名单,放进 CI 和 PR 模板:
| 类别 | 典型许可协议 | 处置 |
|---|---|---|
| 宽松 | MIT、Apache-2.0、BSD、ISC | 放行,保留版权与 NOTICE |
| 弱 copyleft | LGPL-2.1、LGPL-3.0 | 条件放行,动态链接且可替换 |
| 强 copyleft | GPL-2.0、GPL-3.0、AGPL-3.0 | 阻断,除非整项目同协议开源 |
Apache-2.0 的义务比多数人以为的多一条:修改过的文件要「carry prominent notices stating that You changed the files」,还要保留 NOTICE 里的署名。
AGPL-3.0 第 13 条更硬:只要修改后的版本支持网络交互,就要向远程用户提供对应源码。对 SaaS 来说,这条是实打实的,而且不发布二进制也躲不掉。
留证。 AI 参与的代码要能在事后说清哪些是人写的。做法不复杂:提交信息标 Assisted-by:,保留 review 记录,保留人工改动的 diff。
理由有两个。版权局按人类贡献个案判断,你的记录就是"人类贡献"的证据;万一撞上 GPL 片段,独立创作的抗辩也只能靠这条链。
没有记录时,两个方向都站不住:说不清哪些是自己的,也说不清哪些不是抄的。
交付话术。 客户法务要的通常不是"保证干净",是三句话:
- 依赖树及每个包的许可证,来自 SBOM,可附文件。
- 源码做过片段相似度筛查,工具、版本、阈值、人工复核结论。
- AI 参与范围与人工审查流程,含提交标记与 review 记录。
一条红线。 如果一段代码是抄的,AI 有没有参与都不影响义务归属;如果一段代码完全由模型产出且你没有实质改动,你可能既没有版权,也说不清来源。这两种情况都不该出现在要交付的仓库里。
这和审查 AI 提交的 PR 是同一类工作:先判断它做了什么,再判断该不该留。那篇讲的是测试被改弱怎么发现,这篇讲的是代码来源怎么交代。模型权重那侧的许可证是另一套规则,别混用,这里有三条红线。
五分钟自查
pip-licenses --format json --fail-on "GPL;LGPL;AGPL"能否通过- 依赖树里有没有 LGPL 被静态链接进主程序
- 最近三个月 AI 参与的提交,有没有
Assisted-by标记与 review 记录 - 交付物里是否附了 SBOM 与筛查报告
本文讨论的是工程侧的合规排查方法,不构成法律意见。涉及诉讼或大额交易,找律师。
登录后可点赞、收藏与反馈。


