AI 写的 App 能直接上线吗:六项自查,先关分享链接
Grok Build 3.5 万个应用无需登录即可打开,Supabase 有 1.6 万个数据库至少一张表可读。AI 生成的应用为什么在权限上留空,上线前按数据出口做的六项自查,每项都有判定标准、命令和修复提示词。
能打开,不等于能上线。11 月 10 日,安全公司 Claroc 公布 GhostShares 2 报告:Grok Build 生成的 37,571 个在线应用里,35,578 个(94.7%)不用登录就能打开。
一个半月前的另一次扫描指向同一个方向。UpGuard 在约 30 万个带 Supabase 指纹的域名里,找到 16,326 个数据库至少有一张表能被任何人读取,过半带个人信息字段。
两次事件的平台、地域、数据形态都不同,机制却一样:默认值是按「演示能跑通」设计的,不是按「数据只给该看的人」设计的。AI 只是把这个默认值执行得很快。
这篇文章只解决一件事:在你把链接发出去之前,按数据出口查一遍,并知道每一项不合格时该改哪里。
一、随机链接和登录页,都不算权限
先拆三个常见误解:链接猜不到、页面要登录、前端做了过滤。它们各自只挡住了最外层的一半。
随机词挡住了猜,挡不住查
Grok Build 是 xAI 的对话生成应用功能,它给每个应用一个独立地址,形如 able-acorn-ember-mist.grok.me,四个随机词。人猜不到,但地址在域名里,就会在域名系统里留下痕迹。
证书透明度日志(CT)记录每一张签发过的证书。我查了一次 crt.sh 的 %.grok.me:返回 2,726 个唯一子域,其中 1,685 个是四词样式,和 Claroc 描述的应用地址格式一致。
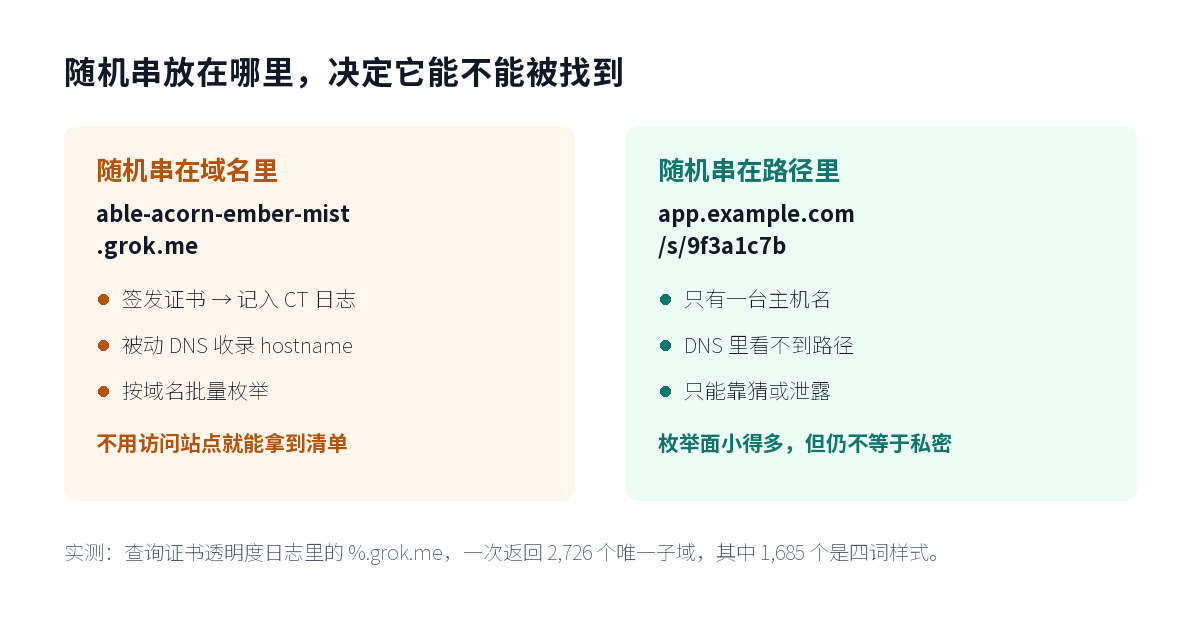
这不是我发现了什么漏洞,是公开日志的正常用途。Claroc 走的是被动 DNS,网撒得更大,所以统计到 43,601 个地址。两个数字不必相等,结论一致:随机不等于隐身。
还有更容易被发现的:100coliseumdrive.grok.me、75hardtracker.grok.me 这类,用户直接拿业务名当域名,连猜都不用。
对照路径式分享 app.example.com/s/9f3a1c7b:DNS 只记主机名,不记路径,枚举面小得多。但小不等于零——链接会出现在聊天记录、截图、浏览器同步和第三方统计里。
两边的说法需要摆在一起。SpaceXSI 回应称,应用在创建者主动分享前保持私密,员工账户默认「仅自己可见」;Claroc 称其付费账户在发布时,「知道链接的任何人」是预选项。双方对默认值的描述不一致,但都没有否认一个事实:那 35,578 个应用当时可以匿名打开。
401 只证明要登录,不证明只看得到自己
Claroc 的统计里,1,993 个应用返回 401,被算作「设置正确」。这个判断只对一半。
401 回答的是"要不要登录",没回答"登录后能看哪几行"。后者是越权(BOLA/IDOR):用 A 账号登录,把请求里的记录 ID 换成 B 的,服务端如果只校验"你有没有登录"、不校验"这条记录是不是你的",就会把 B 的数据交出来。
一组针对 AI 生成应用的审计里,18 份存在这样的路由,能读到或改到别人的数据;16 份的数据库规则允许任何已登录用户查询任意行。这一层,登录页挡不住。
数据库有两个开关,很多人只关了一个
Supabase 官方文档写得很直白:「A table in an exposed schema without RLS is readable and writable by any role with a grant on it.」暴露 schema 里的表如果没开行级安全,任何持有授权的角色都能读写。
更关键的是配套那句:加 policy 不会把 grant 收回来。旧项目在 public 新建一张表,默认把 select、insert、update、delete 全授给了 anon、authenticated、service_role 三个角色。
于是出现两种「看起来修好了」:写了 policy 但没收回 grant;或者开了 RLS 却没写 policy——读返回空、写影响 0 行,插入却报 42501,有人为了让它「能写」就把 RLS 关了。这是把门拆了修锁。
这套默认值正在改:Supabase 从 4 月底允许新项目关闭自动暴露,10 月 30 日起对旧项目执行。但已经建好的表不会自动补上策略,检查还是得自己做。
还有 service_role:它绕过 RLS。这个 key 只要进过前端包,等于把数据库管理员交出去。
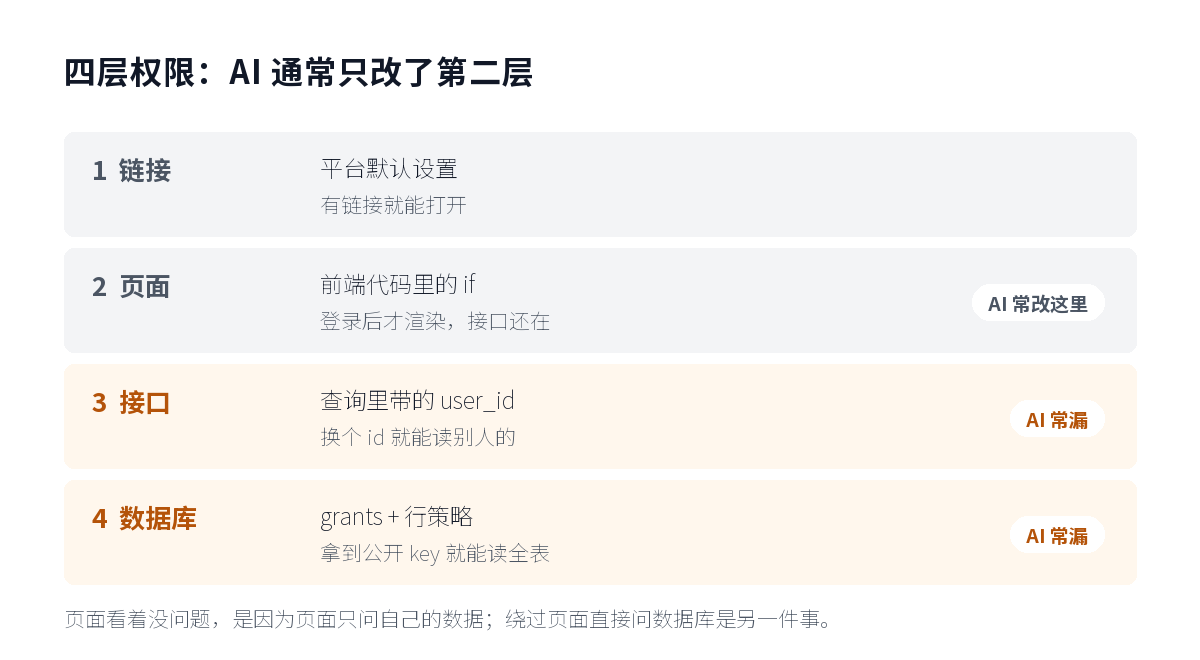
把四层摊开看,问题出在哪一层就很清楚。
| 层与管的人 | 绕过页面直接请求 | AI 生成时 |
|---|---|---|
| 链接 · 平台默认 | 有链接就能打开 | 生成一个可分享地址 |
| 页面 · 前端 if | 空白或 401,接口仍在 | 主要改这一层 |
| 接口 · 服务端校验 | 换个 id 读到别人的 | 只按当前用户过滤 |
| 数据库 · grants + 策略 | 公开 key 能读全表 | 常常没开 RLS |
二、上线前六项自查
顺序有讲究:从最外层往里查。外层不合格时,里层改得再对也没意义。
第 1 项 · 先分级:应用里有没有别人的数据
一级是没有真实数据的演示页、计算器,不用查,但别往里放真数据。二级只有自己的业务数据,查第 3、4、6 项。三级有客户姓名、电话、订单,六项全做。四级涉及钱、健康、证件、未成年人,六项全做,再加一次人工复核。
分级不是形式。Claroc 估计 35,578 个公开应用里只有 650 到 800 个存了私人数据,占比不到 2.5%。真正要修的是这一小撮,其余只要确认自己不在里面。
第 2 项 · 无痕窗口打开链接(30 秒)
换一台设备,或者用浏览器的无痕窗口,粘贴链接,不登录。
看到任何客户姓名、电话、订单、文件,先关分享,再谈修复。看到 401 或空白,算通过——但只通过了第一层。
第 3 项 · 这个链接能不能被找到(5 分钟)
先看随机串在域名还是路径。在域名的,按公开处理。想确认,就查一次证书日志:
curl -s "https://crt.sh/?q=%25.your-domain.com&output=json" \
  | grep -o '"name_value":"[^"]*"' | sort -u | head -20
能列出自己应用的地址,别人也能。要私密就三选一:关掉分享、改成登录后访问、或在最前面加一层平台鉴权。三条里没有一条是「把链接改短一点」,因为问题不在链接长度。
第 4 项 · 前端包里的密钥(10 分钟)
公开的 anon key 是设计如此,它只声明「我是匿名访客」,能读多少数据由 RLS 和 grant 决定。service_role 不同,它绕过 RLS。
两个 key 长得几乎一样,区别在 JWT 第二段的 role 字段。所以不要用「看到 eyJ 开头就报警」的规则,会把自己吓一跳。
最省事的做法是直接搜构建产物:
grep -rE "service_role|sk-|AKIA|ghp_|xox[baprs]-" dist/ build/ public/ 2>/dev/null搜不到,再用脚本把 JWT 解出来看角色。零依赖,一个文件:
python keyaudit.py --dir ./dist
python keyaudit.py --url https://your-app.example.com
我用一份故意埋了 key 的构建产物跑了一遍,输出是这样:
sources scanned: 2
[CRITICAL] supabase_service_role_key  assets/app.js  -> eyJhbGciOi...(195 chars)
[CRITICAL] openai_key                 assets/app.js  -> sk-proj-Q2...(47 chars)
[CRITICAL] aws_access_key             assets/app.js  -> AKIAIOSFOD...(20 chars)
[MEDIUM]   sourcemap_reference        assets/app.js  -> app.js.map
[INFO]     supabase_public_key        assets/app.js  -> eyJhbGciOi...(184 chars)
summary: 3 critical, 0 high, 1 medium, 1 info
三个 critical 都对,anon key 只报 INFO。换成干净产物是 0 critical;对 www.seoml.com 实跑,扫了 3 个资源,0 命中。
顺带一个坑:第一次跑自己的站直接抛了 403,是 WAF 拦了脚本默认的 User-Agent。我特意让它在抓取失败时直接报错退出,而不是返回一个空的「没发现问题」——假通过比报错危险得多。
脚本只查静态特征,证明不了接口安全,替代不了下面两项。
第 5 项 · 换一个 ID 再请求(15 分钟)
登录 A 账号,打开开发者工具的网络面板,找一条读取自己记录的请求,右键复制成 curl。把里面的记录 ID 换成 B 的,重发。
返回 200 且是 B 的数据,就是越权,优先级最高。返回 200 空数组,可能对了,也可能只是前端过滤,去看第六项。返回 403 或 404,大概率对了。
没有第二个账号,就自己注册一个,两分钟的事。
第 6 项 · 数据库的两个开关(10 分钟)
需要后台权限。Supabase 的 SQL Editor 里跑这四条:
-- 1. 没开行级安全的表
select schemaname, tablename
from pg_tables
where schemaname = 'public' and rowsecurity = false;

-- 2. anon 与 authenticated 拿到了哪些权限
select table_name, grantee, string_agg(privilege_type, ', ') as privs
from information_schema.role_table_grants
where table_schema = 'public' and grantee in ('anon', 'authenticated')
group by 1, 2
order by 1;

-- 3. 开了 RLS 却没有 policy 的表
select c.relname
from pg_class c
join pg_namespace n on n.oid = c.relnamespace
where n.nspname = 'public' and c.relrowsecurity
  and not exists (select 1 from pg_policy p where p.polrelid = c.oid);

-- 4. 对所有行放行的读策略
select tablename, policyname, cmd, qual
from pg_policies
where schemaname = 'public'
  and cmd in ('SELECT', 'ALL', 'UPDATE', 'DELETE')
  and (qual = 'true' or qual is null);
第一条有行是红;第二条里 anon 出现 insert、update、delete 是红;第三条有行是黄,读默认拒绝,但插入会报 42501,别用关 RLS 的办法解决;第四条有行,说明这张表对所有登录用户开放。
顺手看两处:接口报错里会不会吐出表名和完整的 GRANT 语句(PostgREST 在缺授权时会这样提示,等于帮陌生人枚举表);响应头是不是 Access-Control-Allow-Origin: * 配上凭证,那意味着任意站点能代用户发请求。
| 检查 | 多久 | 不合格的信号 |
|---|---|---|
| 分级 | 3 分钟 | 说不清存了谁的数据 |
| 无痕打开 | 30 秒 | 出现真实客户数据 |
| 可被找到 | 5 分钟 | 证书日志里能列出你的应用 |
| 前端密钥 | 10 分钟 | 出现 service_role 或 sk- |
| 换 ID | 15 分钟 | 返回了别人的记录 |
| 数据库 | 10 分钟 | 表没开 RLS,anon 有写权限 |
三、修的顺序:先关出口,再收权限,最后改页面
顺序错了会白干。先改前端,等于给漏水的桶刷漆。
第一步,关出口,5 分钟。 撤掉分享链接、暂停公开部署、把项目从公开改私有。目的是止损,不是修好。
第二步,收授权,30 分钟。 收回默认授权,再按需要发回去:
alter table public.orders enable row level security;
revoke all on table public.orders from anon, authenticated;
grant select, insert, update, delete on table public.orders to authenticated;

create policy "own rows" on public.orders
  for all to authenticated
  using (user_id = auth.uid())
  with check (user_id = auth.uid());
using 决定你能看到、能改哪些行,with check 决定写入后的新行是否合法。拆成按命令的策略时,insert 一定要写 with check,否则新行不受约束。
第三步,轮换 key,15 分钟。 service_role 进过前端包就当作已泄露,直接轮换,别等「确认有没有人用过」。旧 key 一失效,风险窗口就关了。
第四步,加两条断言,1 到 2 小时。 把「看不见」变成可回归的测试。第一条在数据库里跑:
begin;
set local role authenticated;
set local request.jwt.claim.sub = '11111111-1111-1111-1111-111111111111';
select count(*) as should_be_zero
from public.orders
where user_id <> auth.uid();
rollback;
把这条留在仓库里。以后 AI 每次改完,跑一遍,两秒钟。业务侧的能力边界怎么分层,可以参考四道闸与一张授权表那篇的思路。
再加一条从外面打的,不给 key,只看未登录能拿到什么:
curl -s -o /dev/null -w "%{http_code}\n" \
  -H "apikey: $ANON_KEY" \
  "https://PROJECT.supabase.co/rest/v1/orders?select=*"
期望 401、403,或者一个空数组。返回数据行就是没修好。
第五步,最后改页面。 删掉前端的「管理员视图」开关,别把权限判断留在 UI。
工作量有对照:那批审计里,Critical 与 High 的修复集中在 12 到 30 个工程小时;35 份里有 4 份因为业务逻辑和权限都压在前端,最后选择重写后端。修比建贵,但比泄露便宜。
四、让 AI 修之前,把这三句写进提示词
AI 不是不认真,是太听话。你说「加个登录」,它就加登录页;你说「只显示我的订单」,它就在查询里加 user_id=eq.当前用户。它照做了,只是做在了界面层。
所以修的时候,别描述界面,描述约束。三句话,可以直接粘:
- 权限判断只能写在数据库策略或服务端,前端只负责展示,不能作为唯一防线。
- 新建表的同一个迁移里,必须 enable row level security、revoke 默认授权、按操作写 policy,并给出一条能证明 A 用户读不到 B 用户数据的测试。
service_role、sk-、AKIA这类凭据不得出现在客户端代码和构建产物里,只能从服务端环境变量读取。
再加一句验收,比十句叮嘱管用:给我一条命令,证明未登录拿不到数据。
这和提示词注入的三层防线是同一个思路:把约束放在它绕不过去的地方,而不是放在它愿意遵守的地方。另外,AI 改完代码后测试有没有被顺手删掉,可以按先查测试、再读业务代码的方法过一遍。
上线前最后一遍,只看五件事:链接是否只发给了该发的人;无痕窗口是否空白;构建产物里有没有 service_role;换个 ID 是否 403;数据库里 anon 有没有写权限。
五件事都过了,也不代表应用安全,只代表你没有把门开着。对绝大多数 AI 生成的应用来说,这已经是最大的那一步。
分享链接是发布动作,不是内部动作。
登录后可点赞、收藏与反馈。