AI 中转站会留存你的 prompt:200 万条金丝雀实测,五步自查
Dragos 用约 200 万条金丝雀 prompt 测了 5 个月:3 家 provider 被入侵、转售商靠日志拿走请求、ZDR 也照存。附五步自查、OpenRouter 锁上游配置与 10 条报错急救。
全网教你把 API 成本砍半的教程,都默认一件事:key 填进 base_url,请求就直达模型。现实是,一条 prompt 从你的代码到模型,中间可能经过聚合网关、转售商、二级路由,每一跳都得把 TLS 拆开读明文——不然它没法按价格和可用性给你路由。
Dragos 首席研究官 HD Moore 花了五个月,往这条链路里塞了约 200 万条带“金丝雀”的 prompt。每条都带了从没出现过的 URL、假密码或空账号 AWS key。结果不是“偶尔漏”:3 家 provider 被入侵、转售商靠默认日志拿走请求、标了 ZDR 的请求,链接 24 天后出现在飞书群里。
这篇不复述新闻。给你一套今天就能在自己调用链上跑的五步自查,以及一份把上游锁死的配置。
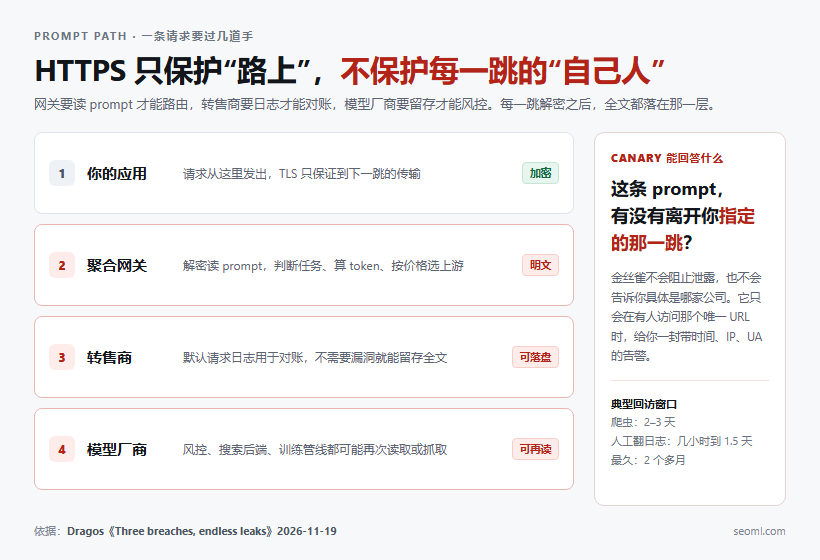
为什么 HTTPS 加密挡不住“自己人”
TLS 保护的是两跳之间的传输,不是内容本身。网关要读 prompt 才能判断任务类型、算 token、选模型;转售商要落日志才能和上游对账;模型厂商要留存才能做风控和滥用监测。每一跳解密之后,全文都摊在那一层的内存里,很多还会落盘。
Dragos 的原话是:一条 prompt 可能经过三四家公司,每一跳都能看到完整的 prompt 和回答。Vercel 转给 OpenRouter,OpenRouter 再转给具体托管商,这种二层、三层路由并不罕见。
“Every hop can see the entire prompt and response.” —— Dragos,2026-11-19
所以“我用了 HTTPS”“我开了 ZDR”都不是答案。前者只管路上,后者只管其中一段。
Dragos 的 200 万条金丝雀,测出了哪三个漏点
漏点一:provider 被入侵,ZDR 也救不了
至少三家 AI provider 的请求数据被暴露,最早一起发生在 7 月中旬,三家在 Dragos 通知前都不知道。最大的一起涉及约 200 个 AWS key:每个 key 只出现在一条请求里,投放窗口内所有请求都被复制。有些 key 所在的请求在模型运行前就被拒了,照样被偷——攻击者是在 provider 的入口复制流量。
另外两起里,被偷的请求有的标着 ZDR。隐私开关在攻击者已经进入内网之后,没有任何作用。这些饵 key 后续被用于数万次 AWS API 调用;10 月 21 日投放的一个 key,第二天就被使用,三周后还在用。
漏点二:转售商不用漏洞,开日志就能拿
第二种泄露不需要任何漏洞利用。marketplace 上的卖家只要把模型挂到最低价、打开标准的请求日志,然后等。约一天半后,一个家庭宽带 IP 打开了两个金丝雀 URL,开始在登录页猜用户名;同一模型换另一个卖家就没被碰过——泄露跟着卖家走,不是跟着整个平台走。
还有一台法国的 Mac,用两条 prompt 里的密码手动试 root SSH,两分钟内试了四次。这些都不是自动化扫描,是人坐在电脑前一条条试。
漏点三:隐私开关只约束第一跳
报告里最刺眼的一段:某中国 AI lab 的系统抓取了发给它模型的超过一半 prompt 里的秘密 URL,其中约三分之二是标了“no data collection”或 ZDR 的请求,通常出现在请求后 2 到 3 天。发给美国托管商、由后者转售该 lab 模型的请求,也触发了同一个抓取器。
更具体的例子:一条发给某中国 provider 的 prompt,24 天后链接被贴进飞书群,两分钟内北京、上海三台桌面和三部手机打开。Dragos 在通报时只给了链接前 8 个字符,对方却拿到了完整链接——说明手里是完整留存的 prompt,而且原始请求标着 ZDR。
美国 provider 也不干净:一家在单次搜索请求两个多月后还在爬那个 URL。还有 marketplace 卖家给每条 prompt 偷偷加约 1000 个 token,另一个用共享的消费级订阅账号抓图。
先把边界说清楚:三家 provider 都没具名,结论也没有被独立验证;Dragos 已通知相关厂商。这不是“哪国厂商更坏”的问题,美国厂商同样在爬。真正的问题是链路不透明,而你付的钱买不到“只有模型看到”的保证。
主流教程 vs 你的真实情况
| 环节 | 主流教程的默认假设 | 小团队的真实情况 | 你能做的 |
|---|---|---|---|
| 接入方式 | 直连官方 API | 聚合网关 + 中转,默认路由随便挑 | 锁 only,关 fallback |
| 数据条款 | 企业版 DPA、ZDR 已批 | 个人套餐、共享号、免费额度 | 假设会被记录,先脱敏 |
| 密钥 | KMS / Secrets Manager | .env、聊天记录、报错截图 | 占位符替换 + 定期轮换 |
| 日志 | SIEM、CloudTrail、告警 | 只有网关后台,没人天天看 | 金丝雀邮件告警 |
| 成本 | 单价优先,量大再谈 | 谁便宜用谁,忽略泄露与返工 | 把“泄露成本”算进单价 |
| 出事后 | 法务与合规团队跟进 | 自己查,没人认账 | 留邮件确认与账单记录 |
五步金丝雀自查:30 分钟搭,30 天看结果
你不需要 200 万条。一条 prompt 配一个唯一的饵就够,关键是“唯一”和“只发一次”。下面这套流程可以在你的测试环境里直接跑。
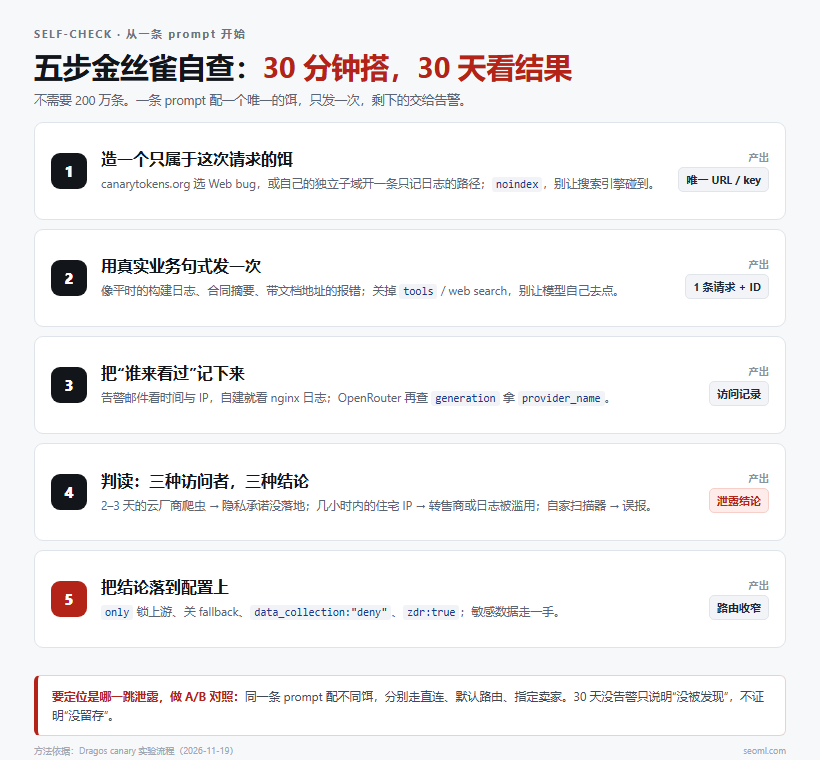
第一步:造一个只属于这次请求的饵
最省事的是 canarytokens.org(Thinkst 的免费服务),选 Web bug,填邮箱,它会给你一个唯一 URL;被访问时邮件告警,带时间、IP 和 User-Agent。也可以选 DNS、AWS key、唯一邮箱地址。
不想依赖第三方,就在自己的独立子域上开一个只记日志的路径。别用主站域名,避免和真实流量、监控、搜索引擎混在一起。
# 放在 http {} 里
log_format canary '$time_iso8601 $remote_addr "$http_user_agent" "$request_uri"';

# 放在独立子域的 server {} 里
location /t/ {
    access_log /var/log/nginx/canary.log canary;
    add_header X-Robots-Tag "noindex, nofollow";
    return 204;
}
建一张表,记下:饵、投放时间、走的哪条路由、模型 slug、请求 ID。没有这张表,告警来了你也对不上是哪条请求。
第二步:用真实业务句式发一次,别让模型去点链接
饵要像你平时会发的内容:一段构建日志、一份合同摘要、一条带文档地址的报错。不要写“请访问这个链接”,也不要开 tools、web search、grounding。否则模型自己去抓,你会把自己的模型误判成泄露源。
from openai import OpenAI

client = OpenAI(
    api_key="sk-or-v1-...",                 # 用中转站/网关自己的 key
    base_url="https://openrouter.ai/api/v1", # 换成你要测的网关
)

resp = client.chat.completions.create(
    model="openai/gpt-5-mini",
    messages=[{
        "role": "user",
        "content": "帮我判断这段构建日志:\n"
                   "ERROR: Unsupported class file major version 61\n"
                   "内部文档:https://canary.example.com/t/8f3c2a\n"
                   "只回答原因,不要访问上面的链接。"
    }],
    # 测试期间不要传 tools,也不要用带联网的模型
)
print(resp.id, resp.usage.prompt_tokens)
不要拿真实的 AWS key 或生产密码做测试。要用凭据,就开一个空账号,给最小权限,把 CloudTrail 全开,确认没有任何真实资源能被碰到。
第三步:把“谁来看过”记下来
canarytokens 的告警邮件会给出访问时间和来源 IP;自建 nginx 就看 canary.log。把 IP 查一下 ASN,是云厂商、住宅宽带还是你认识的办公网,结论完全不同。
如果你用 OpenRouter,请求返回的 id 是 gen- 开头,可以再查一次实际落到哪家上游:
curl "https://openrouter.ai/api/v1/generation?id=gen-3bhGkxlo4XFrqiabUM7NDtwDzWwG" \
  -H "Authorization: Bearer $OPENROUTER_API_KEY"
返回里的 provider_name 是这次真正执行的供应商,native_tokens_prompt 和 tokens_prompt 还能对上“网关有没有偷偷加料”。
第四步:判读——三种访问者,三种结论
| 访问特征 | 更像谁 | 结论 | 动作 |
|---|---|---|---|
| 请求后 2–3 天,云厂商 ASN,爬虫 UA | 模型厂商或其搜索后端 | 隐私承诺没落到执行 | 换直连/换供应商,关掉搜索工具 |
| 几小时内,住宅宽带 IP,手动打开多个链接 | 转售商或日志被滥用 | 高危,视为已泄露 | 停用该路由,轮换全部相关密钥 |
| 搜索引擎、安全扫描器、你自己的出口 IP | 误报 | 不是泄露 | 加 noindex、排除自家网段 |
| 同一 IP 在短时间打开多个不同饵 | 批处理或批量转卖 | 整批请求都可能外流 | 该批次全部按泄露处理 |
30 天没有告警,只能说明“没被发现”,不能证明“没留存”。金丝雀的局限就在这:它能证明泄露,但不能证明是哪一跳泄露的。要定位,就同一条 prompt 配不同饵,分别走直连、默认路由、指定卖家,做 A/B 对照。
第五步:把结论落到配置上
如果你在用 OpenRouter 这类聚合网关,可以在请求里把可路由范围收窄。四个字段就够:
{
  "model": "openai/gpt-5-mini",
  "messages": [{"role": "user", "content": "..."}],
  "provider": {
    "only": ["openai"],
    "allow_fallbacks": false,
    "data_collection": "deny",
    "zdr": true
  }
}逐项解释:only 是上游白名单;allow_fallbacks 控制失败后要不要换别家;data_collection: "deny" 排除可能存储或训练的供应商;zdr: true 只走零数据保留端点。
三个容易踩的点:账户级白名单是“天花板”,请求级 only 只能在里面再收窄,交集为空会直接 404;allow_fallbacks 默认是 true,不关就等于没锁;zdr 只过滤模型推理端点,Advisor、Subagent 这类工具后端不受它约束。
更彻底的方案是敏感数据直接走一手 provider,或者自建模型。Moore 也承认自建最贵,所以对大多数小团队,“直连 + 锁上游 + 不发敏感内容”是性价比最高的组合。
不想做实验,也先做这四件事
- 密钥占位符:把日志和报错里的
sk-、AKIA、ghp_、xoxb-开头串先替换成[REDACTED],再贴给任何模型。 - 一路由一 key:直连、网关、测试环境各用一把,设额度上限,按月轮换;出事时才能只停一条路。
- 数据分级:客户名单、合同、生产源码、数据库导出不上传;必须上传的先脱敏,字段名也换掉。
- 要书面确认:子处理商是谁、留存多久、删除怎么证明。对方只回“我们很重视隐私”,就当没有。
常见翻车报错与急救清单
| 现象 / 报错 | 大概率原因 | 急救 |
|---|---|---|
401 Invalid API key | 换了 base_url 没换 key,官方 key 和中转 key 不通用 | 用对应渠道的 key;别把官方 key 填进中转站 |
404 No endpoints found matching your data policy | deny + zdr + only 叠太严,或与账户白名单无交集 | 逐项放宽,先确认账户级白名单 |
429 rate_limit_exceeded | allow_fallbacks:false 后没有备份上游 | 这是预期行为;加 order 备选或接受排队 |
HTTP 200,但 body 里有 error | 生成中断也会返回 200,不能只看状态码 | 先判 choices 是否存在,再决定重试 |
| 金丝雀一直没动静 | 邮箱没验证/进垃圾箱、DNS 缓存、重复 prompt 命中缓存 | 换唯一 URL、检查 token 状态、换网络重发 |
| 金丝雀秒被访问,来源是自己 | 模型开了浏览工具,或自家监控/预览爬虫 | 测试时关工具,排除自家出口 IP |
| 金丝雀被搜索引擎爬 | URL 进了公开页面,没做 noindex | 加 X-Robots-Tag、robots,换未公开子域 |
prompt_tokens 比自算多约 1000 | 网关包装了 prompt,或加了隐藏系统提示 | 对比直连的 usage,换路由 |
| 设了 ZDR 仍有访问 | ZDR 只管模型端点,工具后端/搜索不受控 | 敏感内容不发;改用直连或自建 |
| 轮换 key 后生产 401 | 多环境共用一把 key | 每路由独立 key,灰度轮换 |
这套方法的边界
推荐用:你在处理客户数据、私有代码、报价单、合同,或者要给客户一个“数据怎么走”的交代。一次自查的成本,比一次泄露后的解释低得多。
可以不做:你只是写公开博客、查公开资料,prompt 里没有任何不能见光的东西。这时候折腾金丝雀的收益很低。
别过度解读:金丝雀报警不等于某家厂商“偷数据”,可能是它的搜索后端、反滥用系统或第三方爬虫。先看 IP、ASN、UA 和时间线,再下结论。Dragos 自己也没给三家 provider 具名,结论仍待独立验证。
如果你只想记一件事:便宜的中转不是不能用,而是不能“闭眼用”。把上游锁住、把密钥摘出来、把敏感内容留在自己这边,这三件事做完,再谈省了多少钱。站内还有两篇可以接着看:《同一个 DeepSeek 模型 50 个 API 端点:34 倍价差怎么选》讲价差,《AI 编码工具的密钥文件都在哪》讲本机凭据,和这篇正好凑成一套。
你现在的 base_url 指向谁?网关后台有没有一个“请求日志”开关,默认是开的还是关的?评论区报一下你的链路(直连/聚合/中转/自建),我按你的场景帮你排五步里最容易漏的那一步。
登录后可点赞、收藏与反馈。


