同一个 DeepSeek 模型 50 个 API 端点:34 倍价差怎么选
Hugging Face 把 160 个开源模型的推理交给路由后,你写的模型名背后可能是 80 家供应商之一。我拉了 19 个模型的 API 端点数据:同一个 DeepSeek 模型输出价差 34.3 倍,13 个模型的上下文在不同端点不一致。这篇给出四个字段的核对方法、一份钉住端点的配置和一个自查脚本。
11 月 16 日,Hugging Face 把 Hub 上 160 个开源聊天模型的推理整体交给了 OpenRouter 的路由层:38 个实验室、80 多家供应商,代码和 token 都不用改。这是一次静默替换——你写的模型名没变,接单的那家公司变了。
模型名从来不是实例名。同一个 deepseek-v4.1-flash-1017 挂着 50 个端点,输入价 $0.036 到 $0.600,输出价 $0.070 到 $2.400。我拉了 19 个常用模型的 API 端点数据对了一遍,这篇只说一件事:在点「换一家更便宜的」之前,先核对四个字段。
你调用的不是模型,是某一家的一次实例
路由的默认逻辑值得先看清。按 OpenRouter 文档,它给每个端点按六个维度打分:有效价格(含缓存命中与典型输入输出配比)、吞吐、首字延迟、429 率、可靠性、工具调用返回格式是否正确。
接近最优的几家分走大部分流量,每个请求按权重随机选一家;落后的保留少量流量以便被重新发现;429 或错误率明显偏高的会被暂停派单。
关键在于优化目标。10 月重构这套路由后,官方给出的实测是:容量类错误减少 46%、首字快 16.9%、吞吐高 16.3%,代价是单请求成本上升 6.0%。默认路由愿意多花 6% 换「别报 429」。它不是最便宜的路径,是一条尽量不出错的路径。
把 19 个模型的端点摊开看,价格区间取最低到最高:
| 模型 | 端点 | 输出价 $/M |
|---|---|---|
| deepseek-v4.1-flash | 50 个 | 0.070 → 2.400 |
| kimi-k3.1-pro | 24 个 | 6.100 → 20.000 |
| gpt-oss-120b | 24 个 | 0.150 → 0.950 |
| gemma-4-31b | 18 个 | 0.100 → 1.150 |
| llama-3.3-70b | 9 个 | 0.320 → 2.253 |
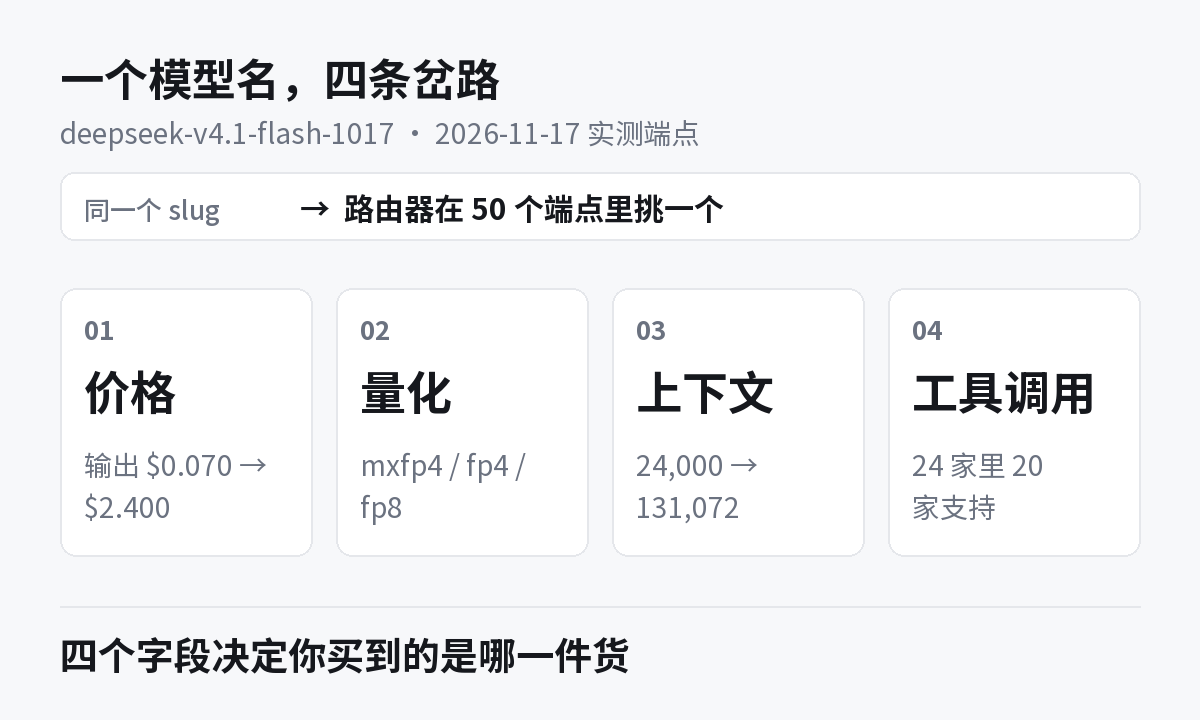
以上为 2026-11-17 抓取的挂牌价,随时会变。五组里价差最小的是 kimi(3.3 倍),最大的是 deepseek(34.3 倍)。19 个模型里 15 个有多于一个端点,这 15 个里又有 13 个的上下文长度在不同端点之间不一致。三个后果:账单不可横向比较、评测结果不可复现、长文档会在某几条路上必然失败。
价差 16 倍:按输入价挑,会挑到最贵的输出
deepseek 的 50 个端点里,输入最便宜的是 Wafer(mxfp4,$0.036/$0.500),输出最便宜的是 Sail Research(fp4,$0.040/$0.070)。两家不是同一家。
按输入价排第一的 Wafer,输出价 $0.500,是最低输出价的 7 倍。只比输入价,等于只看了账单的一半。
kimi-k3.1-pro 的价差方向正好相反:输入价差 16.6 倍,输出价差只有 3.3 倍。Relace 输入 $0.240、输出 $8.402;Decart 输入 $1.220、输出 $6.100。谁更便宜,取决于你的 token 结构:
| 供应商(量化) | 10:1 有效价 | 1:10 有效价 |
|---|---|---|
| Relace(fp4) | 0.982 | 7.660 |
| Decart(mxfp4) | 1.664 | 5.656 |
| Moonshot 官方(mxfp4) | 5.455 | 18.545 |
单位是每百万 token 的综合价。长文档抽取、RAG 拼上下文这类输入为主的活,Relace 领先;写作、代码生成、长推理链这类输出为主的活,Decart 反超,比 Relace 便宜 26%。同一对供应商,换个比例结论就反了。算法只有一行:
def effective(pin, pout, rin=1, rout=10):
    return (pin * rin + pout * rout) / (rin + rout)
把 rin、rout 换成你自己近一周的输入输出比再排序。成本控制的第一步不是找最低价,而是先把自己的 token 结构算清。用输入价排序是最常见的错,它在 1:10 的场景里会系统性高估便宜的那家。
还有一层容易漏:缓存价。deepseek 各家端点的 input_cache_read 从 $0.002 到 $0.014,差 7 倍。命中率高的链路(多轮对话、固定系统提示)实际成本由缓存价决定,输入价只是名义值。
同名不同货:int4 顶替 bf16,24k 的上下文悬崖
模型选型走到这一步会变成端点选型。gpt-oss-120b 有 24 个端点、6 种量化,价格与精度的对应并不整齐:
| 供应商(量化) | 输入 $/M | 输出 $/M |
|---|---|---|
| Venice(int4) | 0.030 | 0.150 |
| DekaLLM(bf16) | 0.030 | 0.180 |
| DeepInfra(bf16) | 0.037 | 0.170 |
| Cerebras(fp16) | 0.350 | 0.750 |
从 int4 换到 bf16,输入价一分没多,输出只贵 20%。反过来,Cerebras 的 fp16 比最便宜那档贵 11.7 倍——贵的是它的推理硬件,不是精度。「便宜没好货」在这张表上不成立,得逐端点看。
量化到底影响多少?官方只给到一句「量化模型在特定 prompt 下可能出现性能下降,取决于所用方法」,没有定量保证。判断只能自己测:同一批 prompt、固定两家端点、各跑 20 次,比 JSON 合法率、工具调用成功率、输出长度分布。不要比文本相似度,同义改写会让它失真。
上下文的问题更硬。llama-3.3-70b 的 9 个端点里,Cloudflare 那个只给 24,000,其余是 128,000 到 131,072。一份 12 万 token 的合同解析打到它上面必然失败,而报错信息不会告诉你「这次路由选了 Cloudflare」。
更尴尬的是这家输出价 $2.253,是 DeepInfra $0.320 的 7 倍——最贵的那条路同时上下文最短。
工具调用是第三个静默降级点。llama-3.3-70b 的 9 个端点里 4 个不支持 tools,gpt-oss-120b 的 24 个里 3 个不支持。智能体链路打到这些端点上会直接失败,而不是退回文本解析。
把路由钉住:一份配置、一个脚本、一条评测纪律
固定端点的写法如下,字段名来自 OpenRouter 的 provider 路由文档:
{
  "model": "openai/gpt-oss-120b",
  "provider": {
    "order": ["dekallm/bf16"],
    "allow_fallbacks": false,
    "quantizations": ["bf16"],
    "data_collection": "deny",
    "max_price": {"prompt": 0.05, "completion": 0.3}
  }
}
order 里要写端点 tag 而不是供应商名:deepinfra 会匹配它的全部变体,deepinfra/bf16 只匹配那一个。allow_fallbacks: false 是钉死的关键,不关掉,主端点不可用时仍会换人。
max_price 与性能阈值不同——价格不满足会直接拒绝执行,而 preferred_min_throughput 只是把慢的排到后面,不会阻断请求。
不想手写配置,可以先跑一遍核对,再照着输出粘。脚本从 /api/v1/models/<model>/endpoints 读端点数据,按你的输入输出比算有效价,再用三个硬条件筛:
python routercheck.py openai/gpt-oss-120b --need-tools --min-ctx 131072 --min-quant bf16 --pin实测输出里有一条值得单独讲:
已排除可用率 59.8% 的 DeepInfra(deepinfra/bf16):更便宜但会掉线。
满足条件的端点 3 个,最便宜的是 DekaLLM(dekallm/bf16),有效价 0.1050
按「价格 + 量化」筛,DeepInfra 的 bf16 排第一($0.037/$0.170),但它近一天可用率 59.8%,四成请求会失败或重试。加上可用率护栏后落到 DekaLLM,价格几乎一样($0.030/$0.180),可用率 98.7%。
这就是把 uptime 做成硬条件而不是参考项的原因:便宜和能用之间的距离,常常是一家已经掉线的供应商。
评测纪律比配置更重要。跑 A/B 之前先 allow_fallbacks: false 把端点钉死,把响应里实际使用的 provider 写进日志。
不固定就发结论,等于用一次抽样代表一个分布。Token 消耗太快怎么查 里提到的放大系数,也只有同一端点才可复现。
最后一层是数据。data_collection 默认是 allow,允许非临时存储、可能用于训练;要禁就显式写 deny,zdr: true 只走零保留端点。国内做聚合与中转的平台机制相同——一次请求转发给上游某一家——但多数不公开端点级的量化、上下文与可用率,你无法验证买到的到底是哪一个。这本身就是采购判据:不公开参数的路由,等于把选择权交给对方。
渠道层面的额度怎么选,见 免费大模型 API 怎么选;自家网关的密钥治理,见 AI 网关密钥泄露怎么处置。
边界要说清楚:本文数据来自 OpenRouter 公开接口,2026-11-17 抓取,只覆盖我拉取的那 19 个模型;国内平台不开放同类接口,结论按转发机制类推,价格与可用率以你抓取时点为准。
下次换供应商之前,按这六条对一遍:
- 用有效价排序(输入输出比例加权),不要用输入价。
- 量化低于 fp8 的端点,没有自测数据就不进生产。
- 上下文按端点里的最小值算,不按模型页的最大值算。
- 智能体链路必须过滤掉不支持
tools的端点。 - 跑评测前设
allow_fallbacks: false,把实际 provider 写进日志。 - 含客户数据的链路,
data_collection显式设deny。
登录后可点赞、收藏与反馈。