AI 推荐的软件隔天换一批:选型前把「一次回答」变成十次采样
210 个购买类问题隔天重问:84% 的 AI 推荐换了名单,Gemini 上是 95%。写给中小团队采购者的五步采样法:换措辞重问、看出现率不看名次、查引用信源、反向提问交叉验证、只认官方硬指标。
2026 年 11 月 17 日和 18 日,Supercite 把同一批 210 个购买类问题(覆盖 21 个品类)在 ChatGPT、Gemini、Google AI Overviews 和 Google AI Mode 上各问了一遍,得到 839 条可比答案:84% 的答案隔天换了一批推荐品牌,Gemini 上是 95%。昨天问 AI「哪个 CRM 好用」、截图存档当结论,今天再问一次,很可能得到一份不同的名单。
这篇写给准备采购软件或服务的中小团队:AI 的推荐不是榜单,是一次快照。先看数据,再给一套把「问一次」变成「采样十次」的问法。
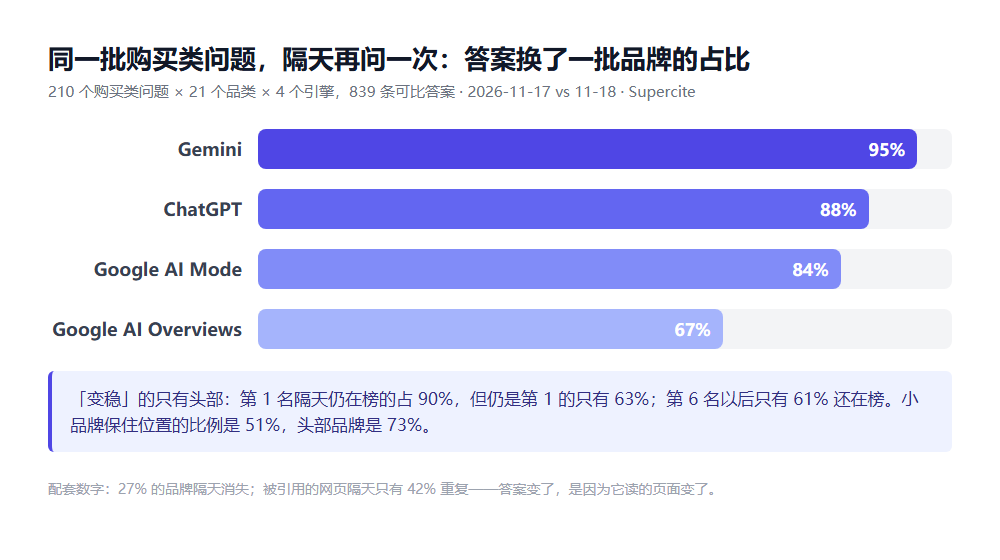
先看数字:隔天变了多少
| 引擎 | 隔天换名单 | 隔天消失的品牌 | 第一名两天一致 |
|---|---|---|---|
| Gemini | 95% | 33% | 57% |
| ChatGPT | 88% | 23% | 71% |
| Google AI Mode | 84% | 28% | 58% |
| Google AI Overviews | 67% | 24% | 66% |
| 四引擎合计 | 84% | 27% | — |
位置越靠后越不稳:第 1 名隔天仍有 90% 在榜,但保住第 1 的只有 63%;第 2–3 名 79%,第 4–5 名 66%,第 6 名以后只有 61%。曝光量小的品牌只保住 51% 的位置,头部品牌是 73%。被 AI 引用的网页换得更快——隔天只有 42% 重复。
为什么隔天就变:它每次现读几页
Supercite 手工核对过一个例子。问题:「对没用过 CRM 的团队,哪个最容易上手」。11 月 17 日,Google AI Mode 把 Less Annoying CRM 排第一,理由是「零门槛」,那天它只读了一页:Zapier 的《11 best CRMs for small business》。11 月 18 日,同一个问题,第一名变成 HubSpot,Less Annoying CRM 整个消失——这次它读了两页:Slack 博客的一篇指南,和 HubSpot 自家产品页。
两家产品一夜之间什么都没变,变的是引擎那天恰好读到哪几页。AI 的回答是一份「几页内容的摘要」,不是一份排好的名次。多组独立研究指向同一结论:SparkToro 与 Gumshoe 2026 年 1 月发现,同一问题问 60–100 次,得到完全相同品牌名单的概率不到 1%;Detailed(Ahrefs 旗下)追踪 1300 多个问题、28 天、7 万多条回答后算出,ChatGPT 两次完全一致的占比只有 0.3%,ChatGPT 和 Google 对同一问题「谁出现最多」的看法只有 27% 一致。
各家研究的口径:不能横向比,方向一致
| 研究 | 规模 | 关键数字 |
|---|---|---|
| Supercite(2026-11) | 210 问 × 4 引擎 × 2 天 | 84% 隔天换名单 |
| SparkToro & Gumshoe(2026-01) | 志愿者每题问 60–100 次 | 完全相同名单不足 1/100 |
| Detailed / Ahrefs(2026-08~09) | 1300+ 问 × 28 天,7 万条回答 | 两次完全一致 0.3%;出现最多的品牌 82% 的天数在榜 |
| MaxAEO(2026-03~05) | 1247 问 × 8 平台 × 90 天 | 每天 17% 的问题换名单;名单中位 5 天不变;65% 的问题 90 天内第一名换过 |
注意口径:「变化」的定义、问题类型、平台集合都不同,这些百分比之间不能互相比较。能比的只有方向——四家独立结论一致:同一道题,AI 几乎不会给你同一份名单。另有一个容易误读的细节:Detailed 手工核对 55 个品牌后发现,36% 的「隔天消失」其实是同一家公司换了写法(产品名和公司名混用),采样时要把别名一起算。
采购前的五步采样法
- 同一问题问 5 遍,每遍换措辞:不要只问「最好的 CRM」,把真实场景放进去——「10 人团队、预算每月几百元、要对接现有客服系统」和「最便宜的 CRM」是两道不同的题。Conductor 2026 年 6 月测过:对比类问题(「A 还是 B」)50 次里第一名 91% 一致,泛泛的科普类问题只有 30%。问题越具体,答案越稳。记录每个候选出现的次数。
- 跨引擎、跨两天采样,看出现率不看名次:至少 2 个引擎 × 2 天,每题拿到 4 条以上答案。Supercite 的数据:同一道题的 8 条答案里出现过 14 个不同品牌,其中 30% 只出现 1 次,8 次全勤的只有约 2 个。只出现一次的直接降权,出现率高的进短名单。
- 让它交出信源,逐条点开:要求列出「参考了哪些网页」。看到厂商自家页面要打折扣——例子里 HubSpot 登顶那天,它读的正是 HubSpot 自己的产品页。第三方榜单也算信源,但引用网页隔天只有 42% 重复,依据本身每天在轮换。
- 追加反向问题交叉验证:问「XX 在什么场景下不合适」「XX 和 YY 各有什么坑」。如果正问反问给出的优缺点互相矛盾,说明那条推荐是从榜单页背下来的,不是推理出来的。
- AI 只当候选池,决策看三个硬指标:价格页——原价与计费方式(按席位还是按用量);数据导出——能不能整库带走、有没有锁定;合同与退款条款。这三样必须回到官方页面核实,AI 的转述不算数。
| 用它做什么 | 靠谱程度 | 依据 |
|---|---|---|
| 生成候选名单 | 较高 | 主流产品基本都能被覆盖 |
| 排出「哪个第一」 | 低 | 第一名隔天只有 63% 还是同一个 |
| 解释选型理由 | 中 | 理由跟着它当天读到的页面走 |
| 替代比价与试用 | 不可用 | 价格、合同、迁移必须看官方页 |
边界与判断
Supercite 这组数据只有两天、每天采样一次、以美国用户身份用英文提问、品牌名靠自动匹配(作者自注有噪声),属于初步数据,作者承诺整周跑完后更新——这些数字看方向,不要当精确统计。MaxAEO 的 90 天样本里各家波动能差到 3 倍(Perplexity 每天 27% 换名单,Claude 只有 9%),换一批问题重测结果也会漂。
国内引擎(元宝、豆包、文心等)都不在这些样本里,比例数字不能直接平移;但采样方法——多问几次、看出现率、查信源——不依赖具体引擎,可以照用。
判断一句话:AI 推荐值得当输入,不值得当结论。问一次就下单,等于照着一张每天重印的地图走路;五步跑完再决定,成本低得多。选定之后、付费之前,先过一遍退路与迁移出口:《13 款 AI 产品退场或调整:付费前先试这四个出口》。如果选的是模型本身而不是软件,同一家模型在不同端点的价差能到 34 倍,见《同一个 DeepSeek 模型 50 个 API 端点:34 倍价差怎么选》。
登录后可点赞、收藏与反馈。


