Arc A770 跑本地大模型:IPEX-LLM 已归档,只剩 Vulkan 能开箱跑
Intel 在 2026 年 1 月归档了 IPEX-LLM,llm-scaler 又不支持 A770。本文在 A770 16G 上实测 llama.cpp Vulkan:9B 生成 44.1 tok/s、prefill 只比 CPU 快 1.66 倍,附 26B MoE 塞法与九条报错急救。
这张卡的二手价和一张 RTX 3060 12G 差不多,参数却是 16GB GDDR6、560 GB/s 带宽、512 个 XMX 引擎、262 TOPS INT8。按纸面算,它该是本地推理的性价比之王。
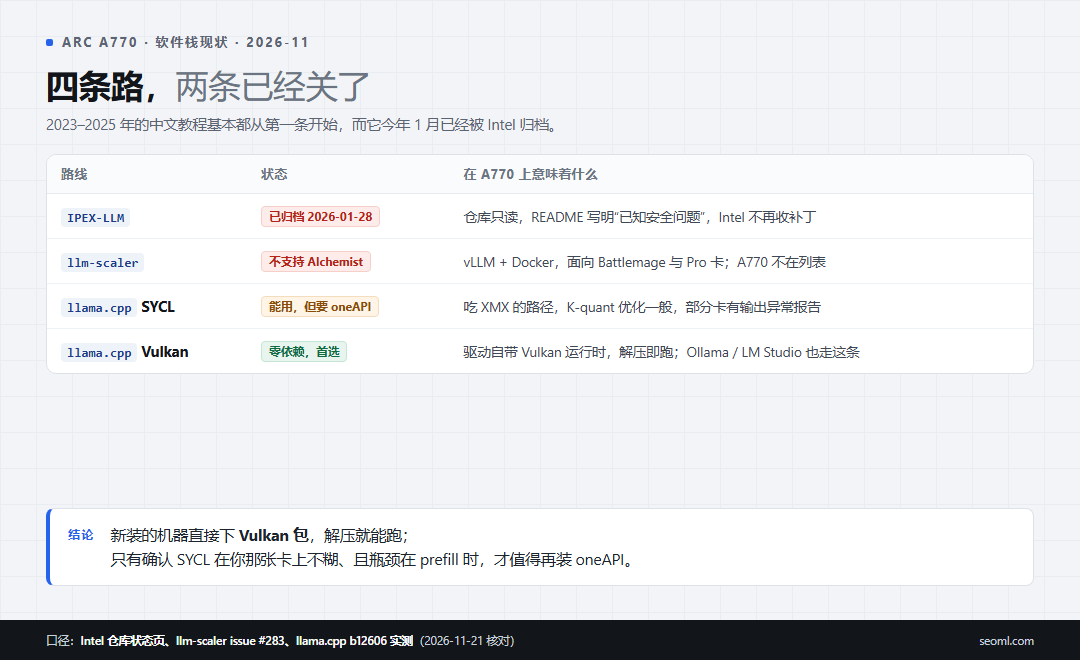
但你翻出 2025 年那篇《Arc A770 部署本地大模型》,第一步就卡住:pip install ipex-llm 装完跑不起来。不是你的问题——Intel 在 2026 年 1 月 28 日把整个 IPEX-LLM 仓库归档了,README 写明「不再提供开发或支持」,并且「已被认定存在已知安全问题」。继任者 llm-scaler 走 vLLM + Docker,官方至今没把 Alchemist(A770 这一代)放进支持列表。
也就是说,2023 到 2025 年的中文 A770 教程,现在基本是负资产。但卡没坏。我用一张 A770 16G 在 Windows 11 上把现存的路线跑了一遍:9B 模型全量卸载到显存能到 44.1 tok/s。更值得说的是那个反差——同一张卡,提示处理只比 6 核 CPU 快 1.66 倍,生成却快 5.2 倍。这个数字决定了它适合干什么、不适合干什么。
先说结论:四条路里,两条已经关了
把「能不能在我这张 A770 上跑起来」当成唯一标准,2026 年 11 月的现状是这样:
| 路线 | 状态 | 在 A770 上的实际表现 |
|---|---|---|
IPEX-LLM | 2026-01-28 归档 | 仓库只读,Intel 不再收补丁;README 自述存在已知安全问题 |
llm-scaler | 不支持 Alchemist | vLLM + Docker,面向 Battlemage 与 Pro 卡;issue #283 开了九个月仍无官方答复 |
llama.cpp SYCL | 能用,但前置重 | 要吃 XMX 就得装 oneAPI 运行时;K-quant 优化一般,个别卡有输出异常报告 |
llama.cpp Vulkan | 零依赖,首选 | Vulkan 运行时随驱动装好,解压即跑;Ollama / LM Studio 在 Arc 上也走这条 |
所以这不是「哪条更快」的选择题,而是只有 Vulkan 一条能开箱跑。SYCL 值得试,但要先接受它的三个前提:oneAPI 运行时(Windows 上是一套几百 MB 的安装器)、对 Q4_K_M 这类 K-quant 的优化不如 legacy 量化、以及不同驱动版本下的输出稳定性要自己验。
为什么 A770 不能照抄 N 卡教程(三个结构性差异)
差异一:没有 CUDA,nvidia-smi 那一套全部失效
N 卡教程的第一步通常是 nvidia-smi 看显存、CUDA_VISIBLE_DEVICES 选卡。A770 上这两个都不存在:显存要看 llama-cli --list-devices,多卡选设备用 GGML_VK_VISIBLE_DEVICES,而且它按 Vulkan 设备序号排,不按 PCI 顺序。
:: 看卡(Windows,llama.cpp 解压目录下)
llama-cli.exe --list-devices

:: 只让 llama.cpp 看到第 0 张 Vulkan 设备
set GGML_VK_VISIBLE_DEVICES=0
差异二:16GB 不是 16GB
Vulkan 后端报的是 16258 MiB,可用 15488 MiB,差的那部分被驱动和桌面占走了。更隐蔽的是 llama.cpp 1.0 的 --fit 默认是 on:它按每张卡保留 1024 MiB 余量、上下文不低于 4096 来自动降层。也就是说,你什么都不设,它也可能不把 9B 全塞进显存,然后你会以为是卡不行。
要看真实占用,把 --fit off 打开,再读日志里的 Vulkan0 KV buffer size 与 Vulkan0 compute buffer size。想复现别人的跑分,这两个数必须一起报,否则没有可比性。
差异三:matrix cores: none 不是故障
启动日志里这一行最容易劝退人。A770 有 512 个 XMX 引擎,为什么显示 none?因为 Vulkan 后端走的是 VK_KHR_cooperative_matrix 扩展,不是直接点 XMX。驱动没暴露、构建没开,或者环境里存在 GGML_VK_DISABLE_COOPMAT,都会显示 none——注意这个变量只要存在就生效,设成 0 也算禁用。
而且 A770 这一代(DG2)上,强开协作矩阵历史上是负优化:llama.cpp 在 Linux 上对 Intel 显卡直接绕开这条路径,有 A770 卡主在 Linux 上实测开启后慢了约 6 倍。所以看到 none 不用修,它只是解释了你的 prefill 为什么快不起来。
三分钟体检:确认卡真的被 Vulkan 接住
装完 llama.cpp 的 win-vulkan-x64 包,先跑这两条,把输出留在手里——后面所有问题都靠它定位:
llama-cli.exe --list-devices

Available devices:
  Vulkan0: Intel(R) Arc(TM) A770 Graphics (16258 MiB, 15488 MiB free)

ggml_vulkan: 0 = Intel(R) Arc(TM) A770 Graphics (Intel Corporation)
| uma: 0 | rebar: 1 | fp16: 1 | bf16: 0 | fp4: 0 | warp size: 32
| shared memory: 49152 | int dot: 1 | matrix cores: none
三个字段决定你后面能跑多快:
rebar: 1:大 BAR 窗口开没开。是 0 就先去 BIOS 打开 Above 4G Decoding 与 Re-Size BAR,再谈优化——这张卡大量显存访问要走窗口映射,ReBAR 关着时跑分普遍偏低。fp16: 1:半精度可用。是 0 说明驱动或系统层面有问题,先重装 Intel 驱动。bf16: 0:正常。A770 没有 bf16,所以别选要求 bf16 KV cache 的模型或参数。
驱动版本也要记下来。我这台是 32.0.101.9175(2026-11-04)。Arc 的性能红利很大一部分藏在驱动里,同卡不同驱动差一截是常态,报跑分不报驱动版本没有意义。
实测:Qwen3.5-9B 在 A770 上到底多少 tok/s
测试条件:Ryzen 5 7500F(6 核 12 线程)、32GB DDR5、A770 16G、Windows 11、llama.cpp b12606(v1.0.0-dev)、Qwen3.5-9B-Q4_K_M(5.68GB),llama-bench 跑 pp512 / tg128,3 次取平均。
| 配置 | pp512(提示处理) | tg128(生成) | 谁在算 |
|---|---|---|---|
| 纯 CPU,6 线程 | 553 tok/s | 8.4 tok/s | Ryzen 5 7500F |
Vulkan,-ngl 99,-fa off | 915 tok/s | 44.1 tok/s | A770 全量 |
Vulkan,-ngl 99,-fa on | 920 tok/s | 44.1 tok/s | A770 全量 |
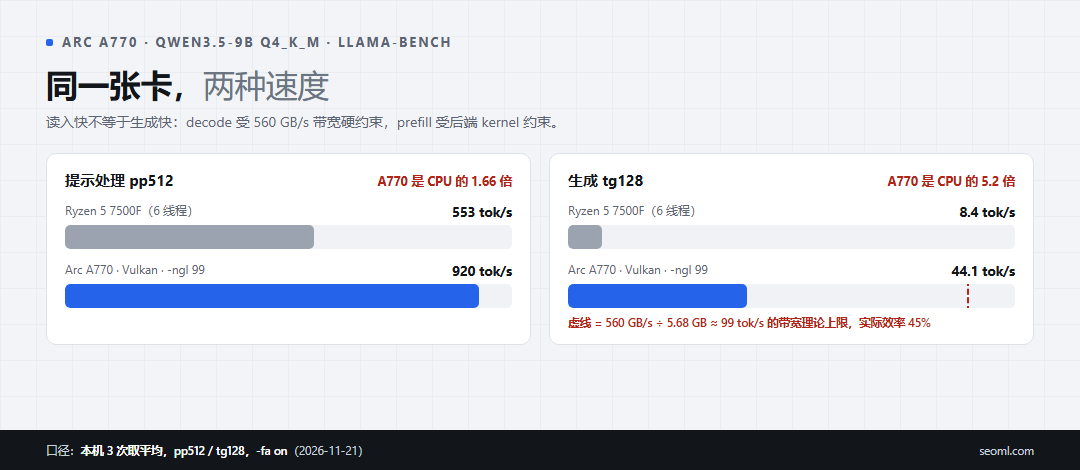
两个数字的方向完全相反,这是 A770 最容易被误解的地方:
- 生成(decode)是它的主场:44.1 tok/s 是 CPU 的 5.2 倍。每吐一个 token 都要把 5.68GB 权重读一遍,560 GB/s ÷ 5.68GB ≈ 99 tok/s 是理论上限,实测效率约 45%——剩下那 55% 卡在后端 kernel,不在显存。
- 提示处理(prefill)没有想象中强:915 tok/s 只有 6 核 CPU 的 1.66 倍。一台 7500F 能干到 A770 的六成,这在 N 卡上很少见。原因就是上一节那行
matrix cores: none——矩阵乘走的是 shader 路径,512 个 XMX 没参与。
这条差异直接决定用途:长文档灌进去、只让它总结一句,A770 的首字延迟不比 CPU 好多少;反过来,短问题、长回答、Agent 连续调用这类「写得多、读得少」的活,5 倍生成速度才是真优势。
FlashAttention 这一项在 A770 上可以不用纠结:-fa on 与 -fa off 的差距是 920 对 915、44.1 对 44.5,都在噪声里。开不开看你顺眼。
16G 显存的第二笔账:上下文比模型更吃显存
很多人算显存只算模型文件,然后 8K 上下文一开就 OOM。实测这版 9B 的 KV 是每 1K token 32 MiB,加上计算缓冲,翻倍算很快(合计为 Vulkan0 上的模型 + KV + 计算 + 状态缓冲):
| 上下文 | KV cache(f16) | 显存合计 | tg128 |
|---|---|---|---|
| 4096 token | 128 MiB | 5.0 GiB | 43.1 tok/s |
| 8192 token | 256 MiB | 5.2 GiB | 42.0 tok/s |
| 16384 token | 512 MiB | 5.4 GiB | 40.0 tok/s |
| 32768 token | 1024 MiB | 5.9 GiB | 38.0 tok/s |
想省显存有三个档:-ctk q8_0 -ctv q8_0 大约砍一半,q4_1 再砍一半但长文会掉点。唯独 q4_0 要避开——社区在 Vulkan 上有过 prefill 从 64 t/s 掉到 13 t/s 的实测记录,省下的显存不值这个价。
并发是隐形杀手:
--parallel 4会把 KV 按 4 份开,等于上表每个数字乘 4。16G 卡上跑 9B,稳妥的是 1 路 32K,或者 4 路 8K,二选一。
想跑更大的:26B MoE 的三种塞法
llama.cpp 1.0(11 月 13 日)把 MoE 专家缓存并进了主分支,这是 16G 卡今年最实用的一次更新。三个参数分工很明确:
:: 1. 所有专家都留在 CPU,只把注意力层放显存
llama-cli -m model.gguf -ngl 99 -cmoe

:: 2. 只把前 12 层的专家留在 CPU(层数自己试,越少越快、越容易爆)
llama-cli -m model.gguf -ngl 99 -ncmoe 12

:: 3. 给 GPU 上的专家开 8GB 缓存,缓存未命中时按比例交给 CPU 算
llama-cli -m model.gguf -ngl 99 --moe-cache-mib 8192 --moe-cache-cpu-share 1.0
我用 gemma-4-26B-A4B 的 UD-Q4_K_M(16.95GB,比 16G 显存大 1GB 出头)试了这三种塞法:
| 塞法 | 结果 | pp512 | tg128 |
|---|---|---|---|
-ngl 99,专家全进显存 | 加载失败:ErrorOutOfDeviceMemory | — | — |
-ncmoe 30(全部专家留 CPU) | 能跑,最慢 | 155 | 16.4 |
-ncmoe 20 | 能跑 | 187 | 24.6 |
-ncmoe 10(推荐) | 能跑,最快 | 271 | 29.4 |
-ncmoe 5 | 能跑,反而变慢 | 202 | 23.4 |
-ncmoe 2 / 0 | 加载失败:显存不够 | — | — |
结论有点反直觉:不是把越多专家塞进显存就越快。-ncmoe 10 是这台机器的甜点,20 层专家在显存里、10 层留在内存,生成 29.4 tok/s;再往下压到 5,显存被吃满,速度掉回 23.4;压到 2 就直接 ErrorOutOfDeviceMemory。26B 的 MoE 在这张卡上能跑到 29 tok/s,是 9B 纯 CPU(8.4 tok/s)的 3.5 倍——代价是模型文件 17GB、加载要等,以及 -ncmoe 的层数得自己一格一格试。
还有一个应急开关:set GGML_VK_ALLOW_SYSMEM_FALLBACK=1,显存不够时直接用系统内存兜住,不 OOM,但会明显掉速。适合「今天必须跑通」,不适合日常——真日常用,还是按上面的 --moe-cache-mib 分配。
常见翻车报错与急救清单
| 现象 | 真实原因 | 解法 |
|---|---|---|
ggml_vulkan: No devices found | 驱动没装好,或 Vulkan 运行时缺失 | 装最新 Intel 驱动,重跑 --list-devices;仍为空就换 win-vulkan-x64 包 |
device memory allocation of size ... failed | 权重 + KV 超了 15488 MiB | 降上下文、降 -ngl、-ctk q8_0,或交给 --fit on |
| 跑起来了但只有 3–5 tok/s | 其实全在 CPU 上跑 | 看日志 offloaded 0/XX layers to GPU,补 -ngl 99 |
error: unknown argument: --flash-attn | 老 b 版本的参数名不同 | 换 b12606 或更新,参数是 --flash-attn on|off|auto |
| 显存只显示 4GB | Windows WMI 的 32 位字段溢出 | 以 --list-devices 为准,任务管理器也别信 |
| Ollama 里 100% CPU | Vulkan 后端没启用 | 设 OLLAMA_VULKAN=1 重启,用 ollama ps 看是不是落到 GPU |
| 长上下文突然卡死、驱动重置 | KV 爆了在换页,或撞上 WDDM 超时 | 降 -c,关浏览器硬件加速,别在后台跑游戏 |
| 装 IPEX-LLM 报模块找不到 / 跑不通 | 项目 2026-01 已归档 | 别修了,换 Vulkan 包,十分钟能跑起来 |
设了 GGML_VK_DISABLE_COOPMAT=0 还是 none | 该变量存在即禁用,值是 0 也算 | set GGML_VK_DISABLE_COOPMAT= 清空后再启动 |
谁该买,谁别买
该买:预算一千出头、需要 16GB 显存跑 7B–14B 量化模型、任务偏「短输入、长输出」的人。写代码补全、批量改写、Agent 连续工具调用这类场景,5 倍生成速度是实打实的体感;它还能把 9B + 32K 上下文压进 6GB 显存,剩下的空间给桌面和浏览器。
别买:靠长文档 RAG 吃饭的人(prefill 只比 6 核 CPU 快 1.66 倍,首字延迟不会给你惊喜)、想跑 30B 以上稠密模型、想做微调、想用 vLLM 做多并发服务的人。A770 的软件栈现在是「能用」,不是「好用」——它已经被 Intel 停产(最后出货 2026-05-20),不会再有新特性砸过来。
同一条「非 N 卡」路线上,站内还写过 RX 7900 XTX 跑 125B 的五道关 和 MTT S80 跑通第一个模型,可以对照看各家的坑在哪。
最后一句实话:这张卡今天的位置很像 2023 年的 AMD——硬件不差,软件在补课。你要是愿意当那个「把日志贴出来的人」,它现在依然是千元档里显存最宽的一张。
你手上是哪张非 N 卡?把 --list-devices 那两行贴到评论区,尤其是 rebar 和 matrix cores,我按你的输出帮你看卡在哪一步。
登录后可点赞、收藏与反馈。