DeepSeek 全家桶 API 上手:五项能力、五个端点与一张账单
DeepSeek 把 App 里的联网搜索、文件输入、阅读链接、语音与安全校验做成了请求参数,Search、Fetch、OCR、ASR、TTS 也能单独调用。按官方文档给出三种协议的可跑写法,再用三个场景把账单算清。
11 月 13 日之后,DeepSeek 的 API 多了五个开关和五个端点。开关负责把 App 里的对话能力塞进原有请求,端点负责让工作流单独调用。这篇不讲概念,只讲怎么写、怎么算、哪里会报错。
一、开放的是一层能力,不是一个新模型
这次更新没有新模型。deepseek-flash 就是 V4.1-Flash-1017,参数没变,变的是请求里能开的开关。
1. 五个开关
| 能力 | 怎么开 | 触发条件 | 典型用途 |
|---|---|---|---|
| 联网搜索 | tools 里声明 deepseek_web_search | 非思考模式 | 时效性问题,需要附引用 |
| 深度思考搜索 | 同上,并开启思考模式 | thinking 为 enabled | 多步求证、比价、核对数字 |
| 阅读链接 | tools 里声明 deepseek_read_url | 最后一条用户消息里有 URL | 让模型读你指定的页面 |
| 文件输入 | 先 POST /files,再引用 file_id | purpose 指定解析方式 | 合同、财报、幻灯片 |
| 安全校验 | 顶层传 safety_check | level 为 high | 对外服务时的合规兜底 |
2. 五个端点
底层能力同时拆成了五个可独立调用的端点,价格与限速各算各的:
| 端点 | 方法与路径 | 计费单位 | 价格 |
|---|---|---|---|
| Search | POST /v1/tools/search | 每千次成功请求 | 5 元 |
| Fetch | POST /v1/tools/fetch | 每千次成功请求 | 5 元 |
| OCR | POST /v1/tools/ocr | 每千页 | 1.5 元 |
| ASR | POST /v1/tools/asr | 每小时音频 | 0.78 元,限时 5 折 0.39 元 |
| TTS | POST /v1/tools/tts | 每万计费字符 | 3 元,限时 5 折 1.5 元 |
有个前提要先记住:五个对话能力都绑定 deepseek-flash。联网工具那页文档写的是「请使用 deepseek-flash 模型」,价格表里图像理解一栏也是 flash 支持、v4-pro 不支持。
v4-pro 在 Responses 下另有一个 web_search 工具,与 deepseek_web_search 不能同时声明。两者不是同一套东西,别混着写。
二、价格与计费口径
1. 两档模型,一条峰谷线
模型价格按百万 token 计,单位是元:
| 项目 | flash 空闲 | flash 高峰 | v4-pro 空闲 | v4-pro 高峰 |
|---|---|---|---|---|
| 输入(缓存命中) | 0.02 | 0.04 | 0.15 | 0.30 |
| 输入(缓存未命中) | 1 | 2 | 4.5 | 9.0 |
| 输出 | 4 | 8 | 13.5 | 27.0 |
峰谷划分是:北京时间周一至周五,不含法定节假日,9:00–12:00 与 14:00–18:00 为高峰;其余时段,包括周末与节假日全天,都按空闲价计。空闲价正好是高峰的一半。
缓存命中与未命中的价差是 50 倍(0.02 对 1)。这条比例决定了提示词怎么写:固定不变的系统提示、少样本、文档正文放前面,让它们稳定命中缓存;每次都变的用户问题放后面。
改动一个字,后面的缓存全部失效。这不是省钱技巧,是接口的计价结构。
2. 工具侧的四个口径
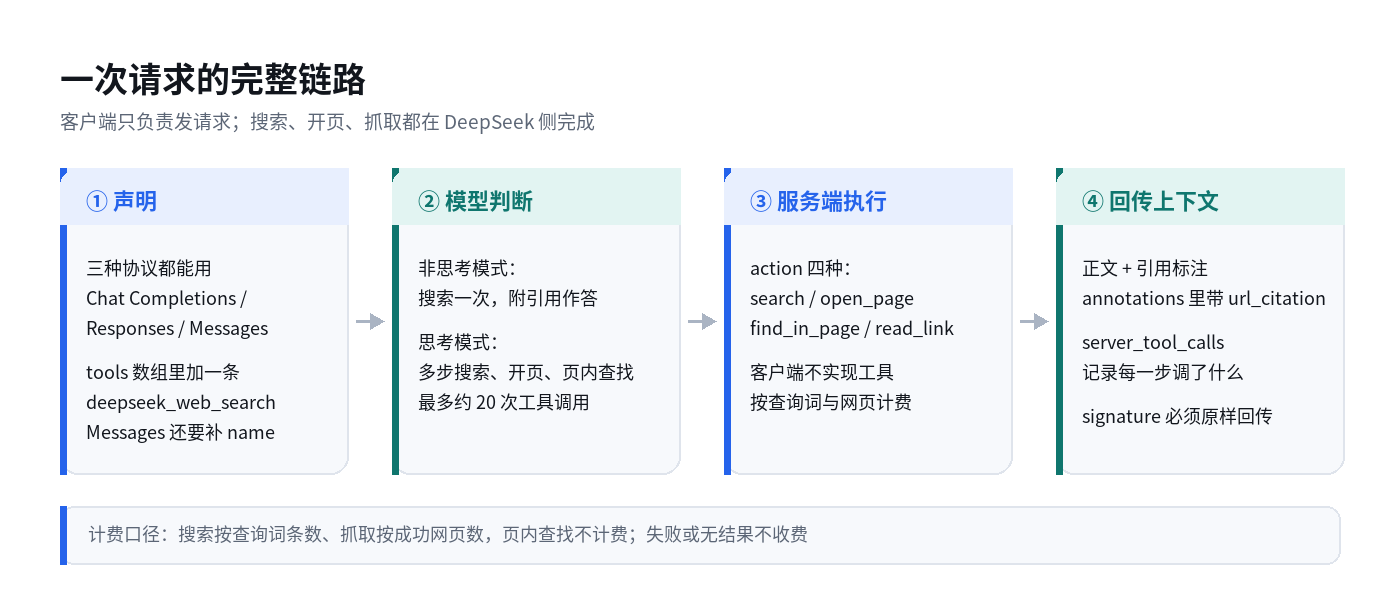
Search按查询词条数计费。一次调用带 3 个查询词算 3 次,count只控制返回条数,不影响单价。- 抓取按成功网页数计费。开启安全校验后,被判为
url_not_allowed的网页也算一次。 - 页内查找(
find_in_page)不计费;失败或无结果的搜索不计费。 - TTS 的计费字符:汉字算 2 个,字母、数字、空格算 1 个。
三、怎么写:从最小请求到独立端点
1. 最小可跑
三个字段就够:模型固定,工具声明,风控打开。
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -d '{
        "model": "deepseek-flash",
        "messages": [{"role": "user", "content": "DeepSeek V4.1 有哪些更新?"}],
        "tools": [{"type": "deepseek_web_search"}],
        "safety_check": {"level": "high"},
        "stream": false
      }'
Python 版本把三处返回读出来:正文、引用、工具调用过程。
import os
import requests

resp = requests.post(
    "https://api.deepseek.com/chat/completions",
    headers={"Authorization": f"Bearer {os.environ['DEEPSEEK_API_KEY']}"},
    json={
        "model": "deepseek-flash",
        "messages": [{"role": "user", "content": "DeepSeek V4.1 有哪些更新?"}],
        "tools": [{"type": "deepseek_web_search"}],
        "stream": False,
    },
    timeout=120,
)
data = resp.json()
msg = data["choices"][0]["message"]

print(msg["content"])

for step in msg.get("server_tool_calls", []):
    for call in step["calls"]:
        print(call["kind"], call["action"], call.get("status"))

for ann in msg.get("annotations", []):
    c = ann["url_citation"]
    print(c["title"], c["url"], c["start_index"], c["end_index"])
三个位置各管一件事:
message.content是最终回答,正文里没有角标。message.annotations是引用,按 URL 与start_index/end_index定位,下标按 Unicode 码点算,不是字节。message.server_tool_calls按「步」组织,每一步带自己的reasoning_content和calls。
calls[].kind 标明能力:search、deep_search、read_link、image_search、deep_image_search。这是这套接口里最有用的一个字段——前端能据此区分「搜出来的」和「读你给的链接得到的」,日志里也能把成本归到具体能力上。
2. 三种协议的写法差异
同一件事在三个协议里写法不同,差异集中在声明位置与过程返回的位置:
| 项目 | Chat Completions | Responses | Messages |
|---|---|---|---|
| 声明写法 | {"type":"deepseek_web_search"} | 同左 | 还要补 "name",与 type 同名 |
| 过程返回 | message.server_tool_calls | output[] 里的 web_search_call | content[] 里的 server_tool_use 块 |
| 引用位置 | message.annotations | output_text 的 url_citation 注解 | text 块的 citations[] |
| 结束标识 | finish_reason | status | stop_reason |
| 继续生成 | 仅 beta 接口加 prefix | 不支持 | 用过工具后 400 |
Responses 里不需要 name,顶层参数直接放风控:
{
  "model": "deepseek-flash",
  "input": "根据 https://api-docs.deepseek.com/zh-cn/quick_start/pricing 说明空闲时段便宜多少",
  "tools": [{"type": "deepseek_read_url"}, {"type": "deepseek_web_search"}],
  "reasoning": {"effort": "high"},
  "safety_check": {"level": "high"}
}
Messages 走 Anthropic 兼容路径,鉴权换成 x-api-key,工具要带 name:
curl https://api.deepseek.com/anthropic/v1/messages \
  -H "Content-Type: application/json" \
  -H "x-api-key: ${DEEPSEEK_API_KEY}" \
  -d '{
    "model": "deepseek-flash",
    "thinking": {"type": "enabled"},
    "tools": [
      {"type": "deepseek_web_search", "name": "deepseek_web_search"},
      {"type": "deepseek_read_url", "name": "deepseek_read_url"}
    ],
    "messages": [{"role": "user", "content": "DeepSeek V4.1 有哪些更新?"}],
    "stream": true
}'一个容易误判的地方:tool_choice 不能强制指定这两个工具,指定就返回 400。Responses 与 Chat Completions 里的 required 会被当作 auto——模型自己决定要不要联网,你没法逼它搜。
3. 文件输入:先上传,再引用 file_id
文件不是直接塞进请求里的,而是先上传、解析,拿到 file_id 再引用。解析方式决定模型能不能看到文档里的图:
| purpose | 模型看到什么 | 适合的文档 |
|---|---|---|
text_recognition | 只有文字 | 合同、论文、扫描的文字材料 |
rich_layout_recognition | 文字 + 按原位置裁出的图表 | 财报、幻灯片、带示意图的说明书 |
user_data | 不解析,表格与电子书转 Markdown | txt、md、csv、json、xlsx、epub |
curl https://api.deepseek.com/files \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -F purpose="text_recognition" \
  -F file="@report.pdf"
purpose 必须写在 file 之前。顺序反了直接 400,这是最容易踩的一个坑,因为多数表单工具会按字段名发送。
引用时在用户消息里挂 document 块:
{
  "role": "user",
  "content": [
    {"type": "document", "source": {"type": "file", "file_id": "file-api-xxxxxxxxxxxxxxxx"}},
    {"type": "text", "text": "总结这份文档的要点。"}
  ]
}
Messages 协议要额外带请求头 anthropic-beta: files-api-2025-04-14。
限制清单:单文件 100 MiB、1000 页;单请求最多引用 20 个文档,文字合计不超过 8 MiB。
上传要在 120 秒内完成,解析另有 120 秒。上传接口是同步的,解析完成才返回 file_id,所以客户端和中间代理的超时要按「上传 + 解析」设置,默认 30 秒一定不够。
4. 五个独立端点
Search 适合自己控流程的检索场景,不经过模型:
curl https://api.deepseek.com/v1/tools/search \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{"query": "DeepSeek V4 发布 lang:zh after:2026", "count": 5, "need_content": true}'
query 限 1–128 字符,count 为 1–50、默认 10,ori_question 传用户原话有助于理解意图,need_content 决定是否返回正文。
返回里两个分数可以直接当阈值用:rerank_score 为 0–3 分,≥1.5 算优质;authority 为 0–4,≥3 是极权威来源。查询语法支持 site:、-site:、-"短语"、"精确短语"、lang:zh,en、after:2026-01-01、before:2026-06-01。
Fetch 只做一件事,把一个 URL 变成 Markdown:
curl https://api.deepseek.com/v1/tools/fetch \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://api-docs.deepseek.com/zh-cn/quick_start/pricing"}'
返回 {"title": "...", "content": "Markdown 正文"}。403 是被安全策略拒绝,404 是抓不到可提取的正文,两者都不计费。
OCR 按页返回文本。逐页识别会保留 <|ref|>、<|box|> 标记与坐标,坐标原点在页面左上角、归一化到 0–1000,可以据此裁出图片区域。它不写入 Files API,也不交给模型,纯粹是文字提取。
ASR 只接受 16 位 PCM WAV 或 Ogg Opus,最大 8 MiB、最长 120 秒,双声道只识别左声道。语种自动判断,没有语种参数。
TTS 有整段与流式两种。整段用 JSON 请求体,voice_id 选 stella(女声)或 tide(男声),format 为 wav 或 pcm。
流式走 wss://api.deepseek.com/v1/tools/tts,文本分段发,最后发一条 {"event": "finish_text"},音频以二进制帧返回。单次最多 1 万计费字符、30 分钟音频。
四、算账与踩坑
1. 三个场景
先给结论,再给拆解。以下都按空闲价、限时 5 折的语音价估算,实际账单会随峰谷比例浮动。
| 场景 | 口径 | 用量 | 估算成本 |
|---|---|---|---|
| 客服问答 | 1 万次对话,每次输入 1500 token(1200 命中缓存)、输出 400,30% 触发一次搜索 | 3M 未命中 + 12M 命中 + 4M 输出;3000 次搜索 | 约 44 元 |
| 文档审阅 | 1000 页 PDF,富版式解析,每页 800 token,输出 1 万 token | 80 万输入 + 1 万输出;1000 页 OCR | 约 2.3 元 |
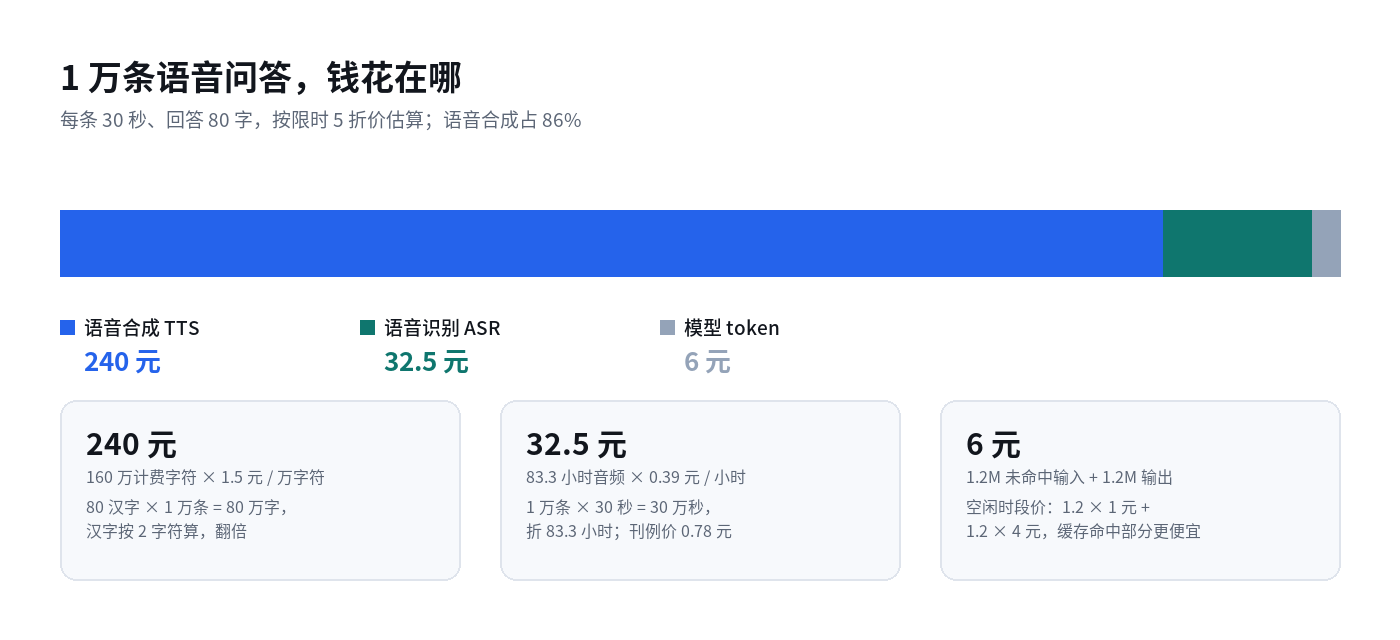
| 语音问答 | 1 万条,每条 30 秒,回答 80 字 | 83.3 小时音频;160 万计费字符 | 约 279 元 |
拆解过程:
- 客服:空闲时段 3×1 + 12×0.02 + 4×4 = 19.24 元;高峰 3×2 + 12×0.04 + 4×8 = 38.48 元;按一半一半取 28.86 元。搜索 3000 次 × 5 元/千次 = 15 元。合计 43.86 元。
- 文档:OCR 1000 页 = 1.5 元;模型 0.8×1 + 0.01×4 = 0.84 元。合计 2.34 元。
- 语音:ASR 83.33 小时 × 0.39 = 32.5 元;TTS 80 万汉字折算为 160 万计费字符,即 160 个「万字符」,×1.5 = 240 元;模型 1.2M 未命中输入 + 1.2M 输出 = 6 元。合计 278.5 元。
三个可以直接用的结论:
- 搜索能占到对话成本的约三分之一(15 元对 44 元)。把它当免费附赠,预算会算错。
- 语音链路里 TTS 占 86%,成本与回答长度线性相关。降本先压回答字数,再考虑缓存高频话术。
- 文档是最便宜的一档:一千页两块三。瓶颈在 1000 页、100 MiB、180 秒这些限制上,不在钱上。
第二条还有一层:汉字按 2 个字符计费,一句「很高兴为您服务」就是 14 个计费字符。它在文字界面里是客套,在语音链路里是成本。
还有一档要单独提醒:深度思考搜索最贵。文档写明一次调用最多发起约 20 次工具调用,搜索又按查询词累计计费。按这个上限推算,一次深度搜索的检索费可以是普通搜索的数倍到十倍。它适合查证事实,不适合当默认开关。
2. 九个坑
purpose必须写在file之前,顺序反了 400。tool_choice不能强制指定联网工具,指定就 400;required只按auto执行。- Responses 里
deepseek_web_search不能和web_search同时声明;不认识的工具类型会被静默忽略。 - 声明联网工具后,Chat Completions 不能传非
text的response_format,不能传logprobs/top_logprobs,也不能再传web_search_options。 - 多轮必须原样回传
server_tool_calls与signature。丢了不报错,只是之前读过的网页不再进上下文。 - 用过联网工具的回复不能续写,Messages 会返回 400,只能重发上一次请求。
- 流式响应里,完整的过程记录只在最后一个带
finish_reason的 chunk 中发送一次。 - 被拒答的请求,之前的 token 照常计费;输入没过审返回 400,输入 token 也按缓存命中价收。
- 文件解析是同步阻塞的,客户端超时按「上传 + 解析」放大到分钟级。
第五条值得多说一句:这种静默降级是最难查的一类故障。请求 200、回答正常,只是模型再也想不起上一轮读过的那个网页。上线前一定要在日志里记录 server_tool_calls 的长度。
3. 谁该现在接
做问答产品的:safety_check 基本是必开项。文档明确写了,对外提供服务要开启该参数,并自行承担内容安全审核、大模型登记、AI 标识等义务。它提供的是基础风控,不替代你的审核责任。
做 RAG 的:Search 返回的 rerank_score 与 authority 可以直接当过滤阈值。这两个分数省掉的不只是自建重排的模型,还有调阈值的时间。
做语音入口的:ASR 的 8 MiB、120 秒限制决定了要自己切段。传整场会议录音不行,前端得按静音切。
做批处理的:把任务挪到 18:00 之后或周末,模型部分直接省一半,工具费用不随峰谷变化。
最后提醒一句:这套接口把「调用衔接」从客户端搬到了服务端,省掉的是工程量和中间层,不是钱。
计价口径要先对上:usage.server_tool_use 里的 tool_search、tool_fetch、tool_image_search 才是计费依据,web_search_requests 只是结果块的数量。两个数字不一样,对账时差的就是这一块。
站内可对照的材料:上下文上限的实际表现见 DeepSeek 的 1M 上下文,单价横向对比见 11 月大模型 API 价格表,模型选型见 DeepSeek 和豆包的区别。
登录后可点赞、收藏与反馈。