Doubao-Seed-Realtime-1.0 接入避坑:别照抄语音版教程,视频帧超 2 FPS 直接被丢
SeedRealtime 1.0 API 于 11-19 全量上线,全网语音版教程照抄必踩坑。按官方文档拆解:视频帧 2 FPS 上限、静音保活、会话管理与 0.196 元/分钟成本账,附报错急救清单。
打开搜索引擎输入「豆包实时语音 API 接入教程」,能翻出满屏结果——但它们全部写于 2026 年 11 月 19 日之前,针对的是只有声音的端到端语音模型。11 月 19 日,火山引擎正式全量上线了另一款东西:豆包实时音视频通话模型 1.0(Doubao-Seed-Realtime-1.0,官方代号 SeedRealtime 1.0)的 API 服务。它把声音、画面、时序与表达统一进同一个端到端模型,官方管这叫「边看、边听、边说」。
对独立开发者和小团队来说,这里有个当下最典型的陷阱:照抄语音版教程的代码,不发视频帧也能跑通对话——你以为自己接的是「实时音视频模型」,实际上「边看」这层能力全程缺席。等你哪天把摄像头画面塞进去,又会一头撞上「帧率超限被静默丢弃」这种不报错、只表现成画面卡顿的坑,排查半天都找不到原因。
先给定心丸:这条路线的门槛和成本比想象中友好。官方计费页显示资源包 100 分钟 19.6 元,折合 0.196 元/分钟;接入协议与语音版同源(同一套 Realtime 事件协议、纯 JSON 文本帧),你在语音版教程里积累的事件处理代码大部分可以复用。这篇文章把官方文档里散落在产品页、协议文档、模型列表和计费页的参数整理成一份能直接对照开工的清单——包括那些官方没放在显眼位置、但一踩就卡半天的细节。
为什么语音版教程不能照抄?先分清火山的三条实时产品线
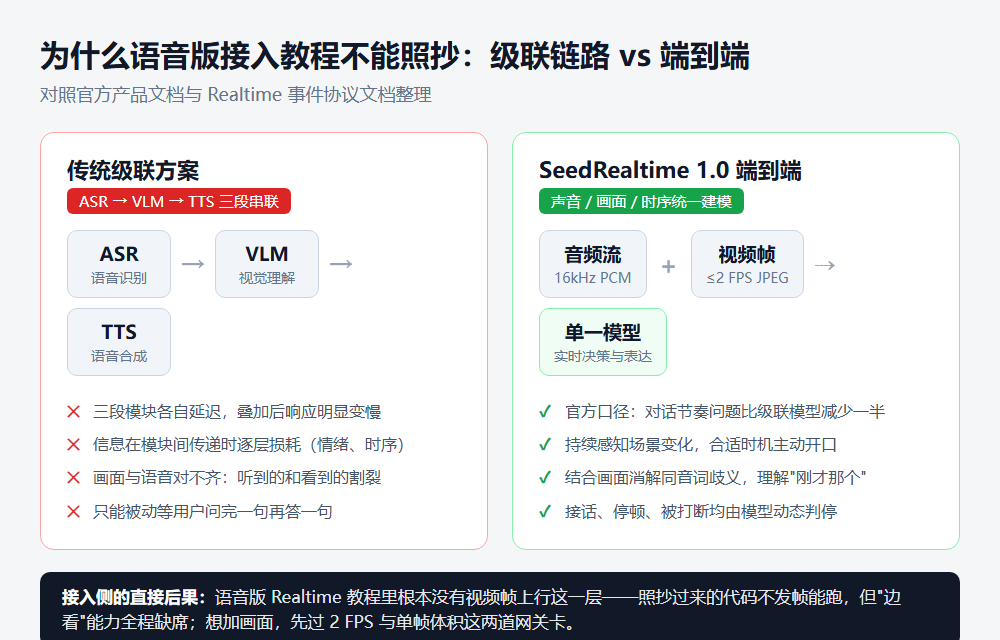
踩坑的根源往往是分不清产品线。火山引擎「豆包语音」下至少有三条容易混淆的实时产品:端到端实时语音大模型(O 系列/SC 系列,纯语音)、豆包实时语音模型 3.0(Seeduplex,全双工纯语音)和本文的主角 Doubao-Seed-Realtime-1.0(全双工、端到端、音频+视频+文本融合)。三者共用同一套 Realtime 事件协议(session.create、input_audio_buffer.append、response.output_audio.delta 这一套),这就是语音版代码能「跑通」的原因——但也正是「跑通了却没在看」的迷惑性所在。
按官方模型列表的对比维度,Doubao-Seed-Realtime 1.0 相比纯语音版多出的核心能力是视觉画面理解:结合画面、声音与时序信息理解用户意图,理解「这个」「刚才那个」这类视觉指代,并用画面上下文消解同音词歧义。官方口径下,它的对话节奏问题比级联模型减少了一半,接话、停顿、被打断均由模型动态判停。其余能力(精品音色 vv/xiaohe/yunzhou/xiaotian、System Prompt 配置、声音复刻 v3 克隆音色、唱歌、联网搜索、热词、正则替换词、AIGC 内容标识)与语音版一脉相承。
一句话判断你该不该用这款模型:如果你的场景里摄像头或屏幕画面本身就是对话的一部分(导览、陪练、设备操作指导、带屏幕共享的实时客服),它才物有所值;纯语音对话请回到更便宜的语音版。
关键一步:视频帧按这些参数发,才不会被网关丢弃
这是语音版教程里完全没有的一层。官方 Realtime 协议文档的「采集最佳实践」给出了明确数字,直接照做即可:
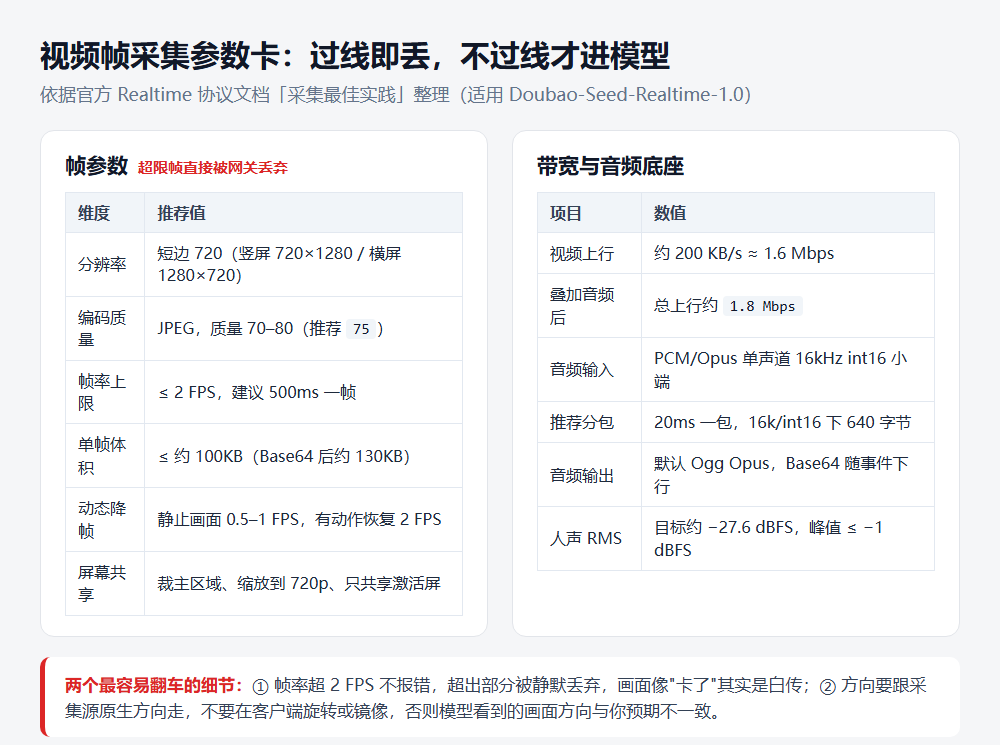
其中最容易翻车的是三条。第一,帧率硬上限 2 FPS:超出的帧不报错、直接被网关丢弃,表现就是模型「看不见你刚展示的东西」——很多人以为是模型能力问题,其实是白传了一堆帧。第二,单帧体积约 100KB 以内(Base64 编码后约 130KB),JPEG 质量开到 70–80(推荐 75)即可,盲目追求清晰度只会撑爆上行。第三,方向跟随采集源,不要在客户端自己旋转或镜像,否则模型看到的画面方向和你预期的不一致。
带宽账也要提前算:720p、2 FPS 的视频流上行约 200KB/s(≈1.6 Mbps),叠加音频后总上行约 1.8 Mbps。移动端弱网场景(地铁、电梯、户外)务必先压测。官方还建议做动态降帧:画面静止时降到 0.5–1 FPS,有动作或画面变化再回到 2 FPS——这既是带宽优化,也是成本优化。如果做屏幕共享,先裁剪到主区域、缩放到 720p、只共享激活屏;涉及人脸、工牌、账号、合同金额等敏感信息的画面,官方的建议是打码后再上行。
音频侧的两个隐形坑:静音保活与电平对齐
第二个从语音版教程里学不到的细节:关麦时必须显式发静音事件。这套协议要求客户端严格按实时节奏发送音频,如果你关闭麦克风、直接停发音频包,服务端会因为收不到音频而判定异常——超过 10 分钟无交互,连接会被直接释放(错误码 45000003)。正确做法是:关麦发 input_audio_mute.commit,恢复麦克风发 input_audio_unmute.commit。陪伴类应用、需要长时间挂机的客服场景,这一步漏了就是「聊着聊着突然没反应」的线上事故。
第三个坑是电平。官方对输入音频给出了具体推荐值:PCM 单声道 16kHz 采样、int16 小端序,20ms 一包(每包 640 字节);人声 RMS 推荐在 −31.7 ~ −23.9 dBFS 区间(中心目标约 −27.6 dBFS),峰值不超过 −1 dBFS;背景噪声 RMS 最好不高于 −50 dBFS。别被这些数字吓到——翻译成白话就是:别把增益拉得太小(模型听不清),也别拉得太大(削波失真),麦克风离嘴别太远。如果你的录音链路自带 AGC(自动增益控制),先确认它没把 RMS 推到准入线之外。
会话与上下文管理:20 轮历史、成对注入与关闭顺序
协议层面的几个硬规则,写代码前先记住:
- 会话建立:客户端发
session.create,服务端回session.created并下发session.id。想接续上一次对话,就在session.update里把这个 id 带回去——服务端默认保留最近 20 轮问答记录。 - 注入历史上下文:用
conversation.item.create预置问答对,必须 user/assistant 成对提交、数组长度为偶数;时间戳要么全部携带(严格递增且不超过当前时间),要么全部不带,混着写会出问题。 - 工具调用:Function Calling 在
session.update的tools字段里用标准 JSON Schema 声明,注意它是全量覆盖而非增量;工具执行结果通过conversation.item.create(role=tool)带原call_id回传,并行调用要聚合后一次性回传。 - 关闭顺序:先发
session.close并收到服务端回复后再断开 WebSocket。直接断开会触发 55000001(ContextCanceled)。
限流默认值也值得写进运维清单:按 AppID 维度,QPM 60(每分钟建会话次数)、TPM 10 万(每分钟 token 消耗)。个人 demo 阶段碰不到,但多人内测时如果几个人同时开摄像头会话,QPM 很容易打满——扩容要提前联系商务,别等到上线当天。
成本怎么算:0.196 元/分钟只是起点
官方计费页目前给出的是资源包预付费档位(计费单位:分钟):
| 资源包档位 | 价格 | 折合单价 |
|---|---|---|
| 100 分钟 / 1 年 | 19.6 元 | 0.196 元/分钟 |
| 5 万分钟 / 1 年 | 9600 元 | 0.192 元/分钟 |
| 50 万分钟 / 1 年 | 94000 元 | 0.188 元/分钟 |
| 200 万分钟 / 1 年 | 360000 元 | 0.18 元/分钟 |
按调用后付费的单价以官方计费页为准,本文不引用估算值。举一个量级感受的例子(纯假设数字,仅演示算法):一个「看画面对话」的原型,内测期每天累计通话 10 分钟、每月 30 天 = 300 分钟,按 100 分钟包折合单价估算约 58.8 元/月——买三张 100 分钟包即可覆盖。视频帧不单独计费、按时长走,所以动态降帧省的是带宽和电量,不省分钟数;真正影响账单的是会话挂机时长,这也是为什么上一节的静音保活和关闭顺序同时是「稳定性问题」和「成本问题」。
常见翻车报错与急救清单
以下错误码与处理方式整理自官方 Realtime 协议文档,建议直接存成团队的运维速查表:
| 特征 | 含义 | 处理 |
|---|---|---|
| 45000003 · Abnormal silence audio | 超 10 分钟无交互,服务端释放连接 | 关麦时发 input_audio_mute.commit,不要直接停发音频 |
| 55000001 · ContextCanceled | 未发 session.close 就断开 WebSocket | 先 close、收到回复再断连 |
| 55000001 · ExceededConcurrentDurationLimit | 并发时长超限 | 控制并发会话数,具体上限官方未公布,需压测确认 |
| 55000001 · InvalidSpeaker | 音色名不合法 | 检查音色 ID;克隆音色需先走声音复刻 v3 接口 |
| 42000020 · volc_websearch_bot_id / api_key is required | 联网搜索模式缺配置 | 在 extension 里补齐 bot_id 与 api_key |
| 50000000 · found unknown escape character | System Prompt(speaking_style/system_role)含非法转义字符 | 清洗 prompt 中的转义符 |
| 5xx 系列 | 服务端错误 | 统一触发重连;每条上行事件带 event_id,配合响应头 X-Tt-Logid 追踪 |
| 4xx 系列 | 鉴权/参数类错误 | 停止重试,核对 API Key 与参数 |
排障通用姿势:给每条上行事件带客户端生成的event_id,服务端会在下行事件里回带,配合X-Tt-Logid找客服定位,比干等快得多。
什么场景值得上,什么场景先劝退
客观边界说在前面。值得上的场景:画面本身参与对话的应用——AR 导览与翻译讲解、设备操作实时指导(官方演示的咖啡萃取提醒就属于这类)、口语陪练与作业辅导(跟着手指的方向纠音)、带屏幕共享的实时客服与远程协助。这类场景里,级联方案(ASR+VLM+TTS 拼起来)的延迟和信息损耗确实难以接受,端到端是正解。
先劝退的场景:一是纯语音对话,语音版模型更便宜也更成熟,没必要为用不到的视觉能力付费;二是弱网移动端——1.8 Mbps 的上行要求在地铁、电梯、车上会直接暴露,除非你能接受降帧降质;三是把「联网搜索、唱歌、克隆音色」当核心卖点的产品——这些能力在本协议里是通过 extension 透传的专有能力,配置项多、坑也不少,建议先跑通音视频主链路再叠加。另外,模型上下文长度等更细的规格参数官方文档暂未在公开页列出,接入前建议在控制台核对最新文档。
写在最后
SeedRealtime 1.0 的 API 选在 11 月 19 日「全量上线」,意味着此前的内测门槛已经撤掉——它大概率会成为国内开发者做「带眼睛的语音助手」的第一站。语音版教程的存量代码是你的起点而不是终点:补上视频帧这一层、记住静音保活和关闭顺序,剩下的协议事件两边完全通用。
你接的是哪条产品线——语音版还是音视频版?卡在哪一步、报的哪个错误码?评论区报一下配置(机型、网络、SDK 版本),看到我会帮你排查。
参考来源
- 火山引擎官方文档:豆包语音产品页「实时音视频通话」(volcengine.com/docs/6561/163032)
- 火山引擎官方文档:端到端实时 Realtime 事件协议与采集最佳实践(docs.volcengine.com/docs/6561/2549732)
- 火山引擎官方文档:豆包语音模型列表与功能对比(volcengine.com/docs/6561/2499930)
- 火山引擎官方文档:模型价格页(Doubao-Seed-Realtime-1.0 资源包档位,volcengine.com/docs/6561/1359370)
- 36氪《火山引擎上线豆包实时音视频通话模型 API 服务》(2026-11-19 14:50)
- IT之家《豆包实时音视频通话模型 1.0 API 全量上线》(2026-11-19 14:55)
登录后可点赞、收藏与反馈。