Gemini 工具装多了怎么省:Tool Retrieval 按需加载三步开启
Gemini API 11 月 19 日上线 Tool Retrieval 预览版:tool_search 加 defer_loading 两处改动,schema 按需加载。官方示例 200 个工具省 86% token,但 10 个工具的小库开了反而多花 36%;三步开启、成本分界线与八个翻车点一篇说清。
11 月 19 日,Google 在 Gemini Interactions API 上线 Tool Retrieval(预览版):请求里加一个 tool_search 工具、给不想前置加载的工具标上 defer_loading: true,参数 schema 就不再塞进每次请求,模型要用谁就按名字取谁的完整定义。官方 setup guide 的说明性示例里,200 个工具的智能体输入 token 从 164,000 降到 23,650。
但同一份 guide 的第二个示例把话说反了一半:10 个工具的小工具库开了检索,token 反而从 68,000 涨到 92,830。这个功能不是「开了就省」的开关,工具数量和上下文大小决定它是省钱还是烧钱。这篇把三步开启、成本分界线和翻车急救一次说清,所有数字都来自官方博客与 setup guide,没有自测估算。
为什么工具一多,token、延迟和准确率一起翻车
常规做法是把所有工具的完整参数 schema 放进每次请求。工具到几十上百个时,官方博客列的问题有三条:input token 被撑大、延迟跟着上来、候选列表越长工具选择准确率越低。第三条最隐蔽——你给模型装更多工具本想提升能力,结果它反而更常选错。
两种方案的差异一眼看清:
| 维度 | 静态全量加载 | Tool Retrieval |
|---|---|---|
| 每次请求发什么 | 全部工具的完整 schema | 名字 + 描述(每个条目约 26 token,官方早期测试值) |
| schema 何时进上下文 | 从第一轮就一直在 | 用到才加载,加载后会话内不卸载 |
| 前缀缓存 | 动态增删工具会打碎缓存前缀 | deferred 不占提示词开头,prefix 轮次间稳定 |
| 改造成本 | 自己写裁剪脚本、维护白名单 | 两个声明式字段,无需自建索引 |
三步开启:tool_search 加 defer_loading
官方示例的代码改动只有两处:tools 数组开头加一个 {"type": "tool_search"},再给要延后的工具加 defer_loading: True。高频工具保持前置加载,不标 defer:
from google import genai

client = genai.Client()

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "issue_refund",
        "description": "Refund an order to the original payment method.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string"},
                "amount": {"type": "number"},
            },
            "required": ["order_id", "amount"],
        },
    },
    # ... 50+ 个同样标 defer_loading 的长尾工具
]

interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Order A-1042 arrived damaged. Please refund 40 dollars.",
    tools=tools,
)
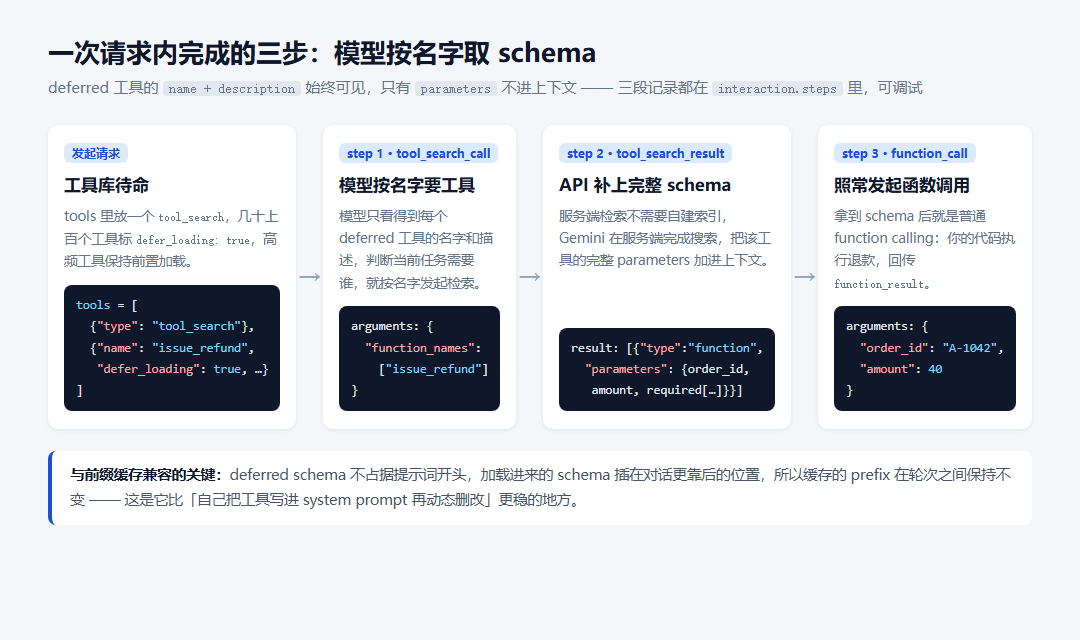
关键在模型「看得到什么、看不到什么」:deferred 工具的名字和描述始终可见,所以它知道货架上有什么,只是看不到参数定义。需要时按名字发起检索,API 补上完整 schema,然后照常发起 function_call——三步发生在同一次请求内,全部落在 interaction.steps 里。调试工具名写得不好导致选错时,看这三段记录就能发现模型当时考虑过哪些候选。
哪些工具该 defer,哪些不该
- 前置加载:高频主力工具不标 defer,保持完整 schema 常驻,避免多一次检索开销。
- defer 长尾:低频、参数 schema 很长的工具(如各类导出、查询类接口)标
defer_loading,每个条目只付约 26 token 的名字+描述成本。 - 总量参考线:官方 function calling 指南建议工具库过了 20-30 个再考虑检索;以下就老老实实全量发。
客户端检索:什么时候用 execution: "client"
如果你维护自己的工具注册表、向量索引,或者要按用户权限过滤可调用工具,把检索放到客户端执行:
tools = [{
    "type": "tool_search",
    "execution": "client",
    "name": "search_tools",
    "description": "Search the internal tool registry for functions.",
    "parameters": {
        "type": "object",
        "properties": {"query": {"type": "string"}},
        "required": ["query"],
    },
}]
# 模型发出 search_tools 的 function_call 后,
# 在 function_result 里返回你检索到的完整 schema三个差异要记住:每次检索多一个网络往返,查询由你的应用执行;工具不必预先声明,用户中途接入新集成时可以当场暴露新工具;服务端和客户端检索不能在同一个请求里混用,且整个请求只允许一个 tool_search 定义。
远程 MCP 服务器一行 defer
给 mcp_server 工具设 defer_loading: true,该服务器暴露的所有工具整体按需加载,接一个大服务器不用逐个列出工具。如果你之前是手写脚本裁剪 MCP 工具定义来压上下文(我们在 《MCP 工具装太多怎么裁》里做过四步裁剪),这条官方声明式方案可以直接替掉大半个脚本。
成本账:省 86% 和多花 36% 的分界线
计费规则四条:没有单独收费项;开启 tool_search 增加一小块固定 input token;加载进来的 schema 在会话剩余部分按普通输入计费,与事先声明一个工具的单价相同;每次服务端检索是一次带全量上下文和新 schema 的模型调用,按 tool-use tokens 以输入价结算——这最后一项就是小工具库翻车的根源。
| 官方示例 | 规模 | 静态全量 | Tool Retrieval | 结果 |
|---|---|---|---|---|
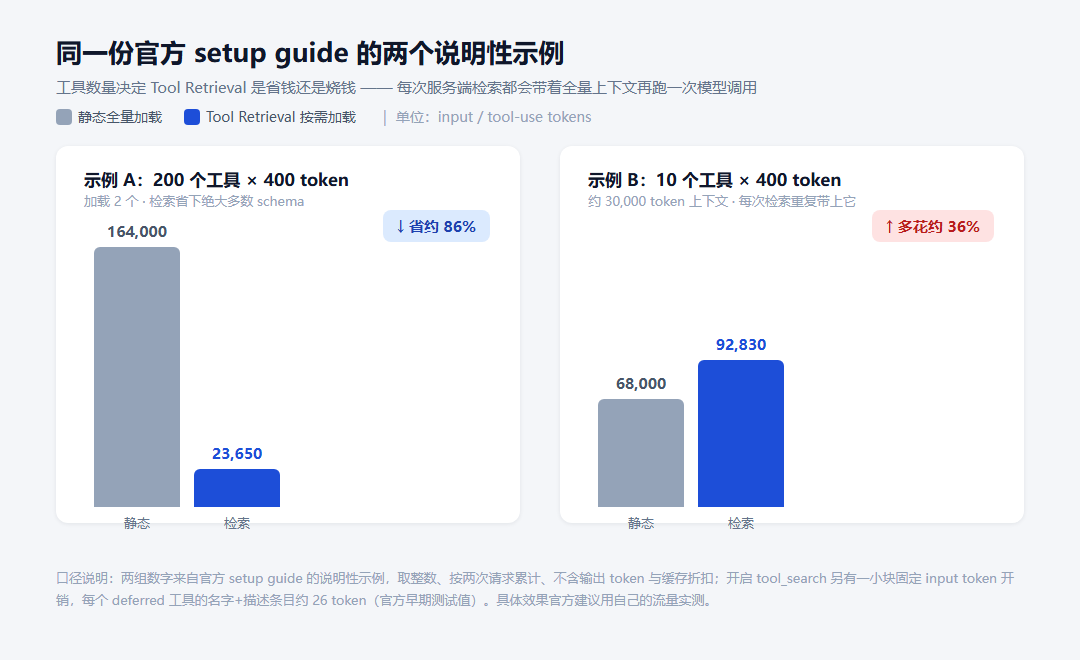
| 示例 A | 200 个工具 × 400 token,加载 2 个 | 164,000 | 23,650 | 省约 86% |
| 示例 B | 10 个工具 × 400 token + 约 30,000 token 上下文 | 68,000 | 92,830 | 多花约 36% |
口径先说清:这是官方 setup guide 的说明性示例,取整数、按两次请求累计、不含输出 token 与缓存折扣。分界线逻辑很直白——省的是「重复发送的 schema」,烧的是「每次检索重复携带的上下文」。上下文越大、工具越多、检索次数越少,越划算;工具少、上下文大、检索频繁,就反着来。官方的建议也是拿自己的真实流量实测,别套示例数字。
常见翻车报错与急救清单
| 症状 | 原因 | 处理 |
|---|---|---|
| 设置 defer_loading 直接 400 | 模型不支持 | 官方已列明支持 Gemini 4 Argon、3.8 Flash、3.6 Flash 等 3.6 及以后模型;换模型再试 |
| 配置了但完全没效果 | 用在了旧接口上 | 仅 Interactions API 支持,旧版 generateContent 不行;换接口 |
| 开了之后 token 反而变多 | 小工具库 + 大上下文,检索重复带上下文 | 关掉,或只 defer 真正的长尾工具、减少检索次数 |
| 请求被拒 | 服务端与客户端检索混用,或配了多个 tool_search | 一个请求二选一,tool_search 定义只留一个 |
| 账单只涨不降 | 加载后的 schema 会话内不能卸载,一直计费 | 拆短会话;或把该工具重新标回 deferred |
| 链式轮次报工具不存在 | tools 数组不跨请求存储 | 每次请求(含用 previous_interaction_id 链的轮次)都重发完整 tools 数组 |
| 某天行为突变 | preview 状态,API 面可能调整 | 锁版本,关注官方 setup guide 变更再升级 |
边界:这三类场景劝退
诚实边界:工具 20 个以下、单轮或极少轮次的调用、上下文本身很大而工具很小的任务——官方两个示例的数据都指向「开了更贵」,全量加载反而便宜。值得开的是:多轮 agent、工具库几十上百个、调用集中在少数工具上(长尾 defer + 主力前置)的组合。另外它现在只是预览版,生产环境建议先在旁路流量验证。
成本侧的姊妹问题是输出:Gemini 4 Neon 的文档切片场景里,输入省了九成、账单大头其实在输出,见 《Gemini 4 Neon 读一叠 PDF》。两篇合起来看,输入输出的省钱杠杆就齐了。
你的 agent 现在挂了多少个工具?token 是从哪一步开始涨的?评论区报一下工具数、上下文规模和模型,帮你判断该不该开。
登录后可点赞、收藏与反馈。