Gemini 4 Neon 读一叠 PDF:输入切片省九成,输出才是账单大头
谷歌 11 月 18 日上线的按页切片,能把文档输入费砍掉九成;但输出单价是输入的 5 倍,思考 token 另计。用一份 100 页 PDF 算清四个杠杆,并列出三个会静默出错的硬上限。
谷歌 11 月 18 日发布 Gemini 4 Neon:每百万 token 输入 3 美元、输出 15 美元、缓存输入 0.15 美元,上下文 1,048,576 token,思考档位四档(low / medium / high / xhigh,默认 high)。
同一份 API 更新说明里还有一条对实际工作更有用的改动:Gemini API 开始直接接收 Word、PowerPoint、Excel 与 OpenDocument 文件,并且可以按页码范围、工作表标签、单元格区间、音视频时间段、内容层(页面图像 / 正文 / 公式 / 字幕)切片,「只为选中的内容付费」。
对一周要过几十份合同、对账单、投标资料的人来说,第二条才是能省钱的那条。但切片只动输入侧:输出单价是输入的 5 倍,而且输出价里包含思考 token。算下来,省掉的输入费经常被输出吃回去。
一、先记住这六个数字
| 项目 | 官方数值 | 对你的影响 |
|---|---|---|
| 输入 / 输出 | $3 / $15 每百万 token | 输出是输入的 5 倍,且输出价含思考 token |
| 缓存输入 | $0.15 每百万(标准价 5%) | 只有「同一段前缀反复问」才吃得到 |
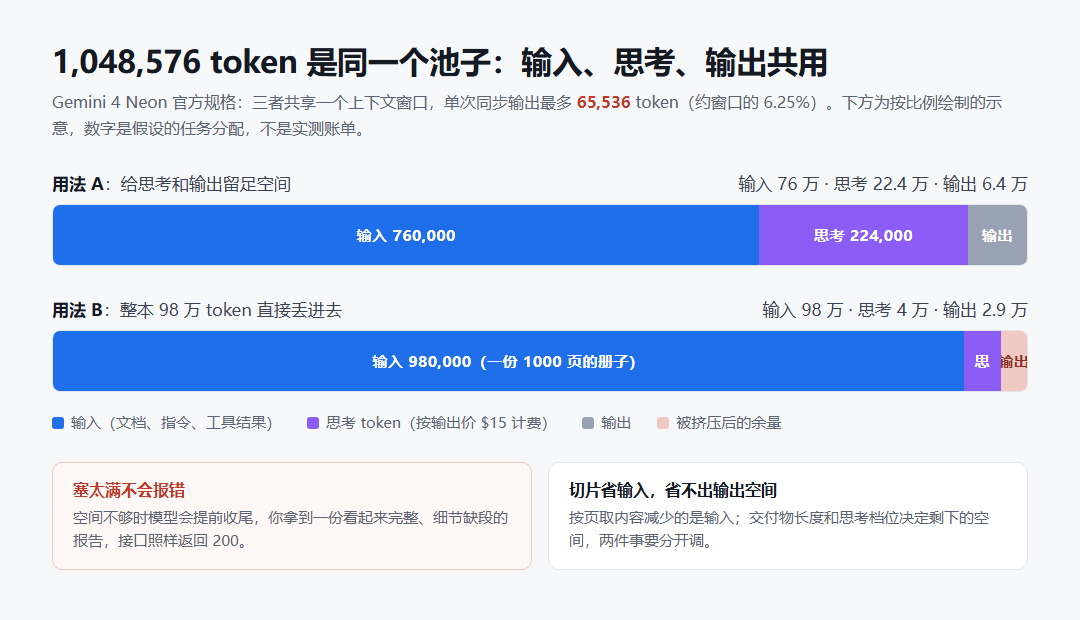
| 上下文窗口 | 1,048,576 token | 输入、思考、输出共用这一个池子 |
| 单次同步输出 | 65,536 token | 超过就截断,不报错 |
| Batch / Flex | 五折($1.50 / $7.50) | 非实时批量任务直接省一半 |
| 免费层 | 无 | 要试用得先开付费 |
以上为 2026 年 11 月 19 日的官方定价。同一张价目表上还有一个时间点要注意:Gemini 4 Carbon 与 Argon 现在还是 $2 / $10 的促销价,12 月 1 日起翻倍到 $4 / $20。
二、别急着重构:11 月 30 日之前 Neon 按 token 算更贵
Carbon 现在拿的是促销价,Neon 的输入与输出单价比它各高 50%。谷歌的说法是「默认 high 档下每任务成本比 Carbon 低 32%」——按任务算便宜,按 token 算更贵,两个口径并不矛盾:Neon 一次做完的概率更高。
判断方法很简单:如果你的任务现在在 Carbon 上要来回三四轮才收敛,换 Neon 未必省钱,按 token 计费的差距会在多轮里放大;如果一轮就出结果,按任务算才是真的降本。12 月 1 日 Carbon 翻倍之后,这笔账才无条件倒向 Neon。
三、切片到底省多少:一份 100 页的账
文档按图片层计费时,谷歌给的量级是低 / 中 / 高分辨率每页约 280 / 560 / 1,120 token。以一份 100 页 PDF、中分辨率、实际只需要其中 10 页为例:
| 做法 | 输入 token | 输入成本($3 / 百万) |
|---|---|---|
| 整本上传 | 56,000 | $0.168 |
| 只取需要的 10 页 | 5,600 | $0.017 |
输入省了九成,绝对金额 0.15 美元。同一份文件如果还要模型写一份 3,000 token 的摘要,输出就是 0.045 美元——已经抵掉切片省下的三成。若开高档思考,思考 token 按输出价计费,输出侧很容易超过整本输入的价钱。
另一个反直觉的点:文字层不一定比图片层便宜。中文密排 A4 一页正文约 700–1,000 token(估算值,实际要用 countTokens 量),比中分辨率图片层的 560 更贵。要数字和条款准确就得用文字层,要版面、印章、手写批注才叠图片层;两层可以同时选,按需叠加,不必二选一。
四、四个杠杆,一次只拉一个
切片、缓存、Batch、表格区间,这四个手段解决的不是同一个问题。选错杠杆,钱花了效果没到。
| 你的场景 | 该拉的杠杆 | 原因 |
|---|---|---|
| 同一份 300 页制度文件,反复问 20 个问题 | 整本上传 + 靠隐式缓存 | 首轮全价,后续读同一前缀按 5% 计;切片反而每轮都要重传 |
| 80 份供应商合同,每份只抽 6 个字段 | 按页码范围切片 | 每份只付需要的页,成本随页数线性下降 |
| 月度对账、批量分类这类不急的活 | Batch / Flex | 五折,代价是排队,适合夜里跑 |
| 几十个 sheet 的财务模型 | 指定 sheet_index + visible_cells | 默认只给值和公式,不渲染整表;要看图表再叠视觉层 |
表格类要多看两眼
官方文档里,表格默认层是「值 + 公式」,视觉层要显式添加;visible_cells 用 A1 区间裁剪,不填 sheet_index 就是整本所有工作表。三个坑:
- 公式不等于算过:拿到公式文本,不代表它被重新计算过,结果仍以你本地的表格为准。
- 裁剪不补上下文:单元格里的数字可能依赖表头、币种、别处的引用,这些不在选中区间就不会进模型。
- 工作簿版本要对得上:「第二个 sheet」在同事调整过顺序之后,指的可能是另一张表。
五、思考档位:贵 72% 只换 1 分
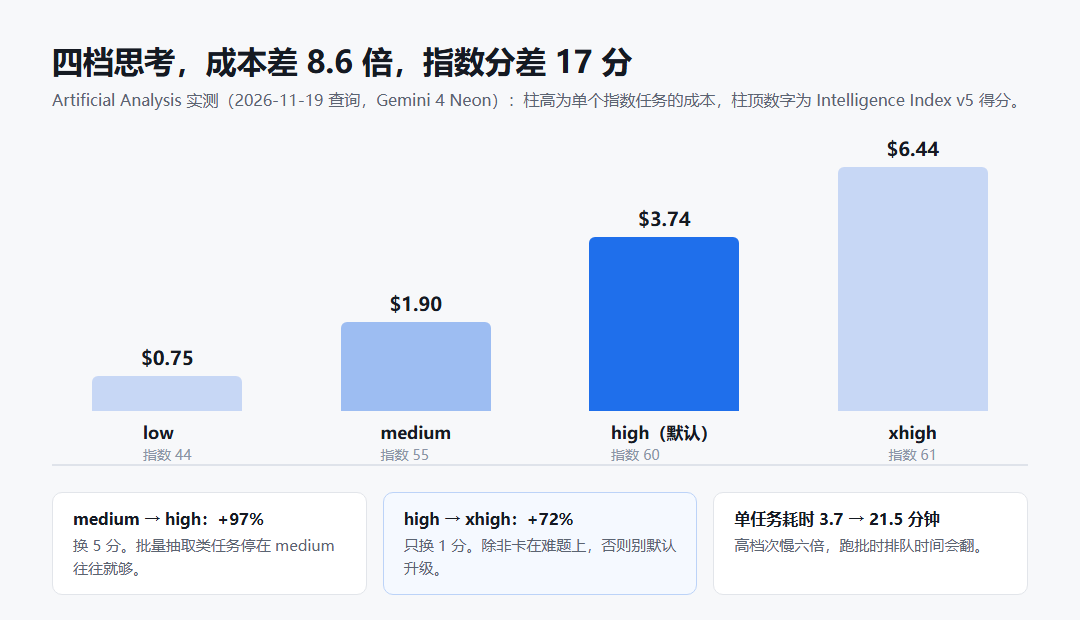
Artificial Analysis 在 11 月 19 日的实测里,四档的成本与得分是:low $0.75 / 44 分,medium $1.90 / 55 分,high $3.74 / 60 分,xhigh $6.44 / 61 分。从 medium 提到 high 接近贵一倍换 5 分,还算划算;从 high 提到 xhigh 贵 72% 只换 1 分,只有在真的卡住时才值得。
注意这是「单个指数任务」的成本,不是你的文档任务成本。它能说明的是方向:批量抽取类任务停在 medium 往往就够,跨文件推理才需要 high。
六、三个会静默出错的边界
- 共享的 1M 池子:输入、思考、输出共用 1,048,576。传一份 98 万 token 的册子,留给思考和输出的不到 7%,模型会提前收尾,接口照样返回 200,你拿到一份看起来完整、细节缺段的报告。经验阈值是把单次输入留在 70 万以内,再按任务实测微调。
- 65,536 的同步输出上限:想一次生成上百页的结构化报告,会在中途断。拆成多份交付物,或者走后台长解码模式。
- 切片不豁免上传限制:谷歌文档写明,上传体积与页数上限针对的是整个文件;选 3 页不能让一个超限文件变得合规。
七、上线前的四步,和四种别用的情况
- 先量 token,再算钱:不要拿页数估。把真实文件跑一遍 countTokens(写法见本节末尾),拿到真实用量再乘单价。
- 抽 20 份已知答案的文件人工核对:把错误分三类记下来——整段漏掉、字段串行错位、凭空补全。三类错误的修法完全不同,混在一起看不出问题。
- 记录每次调用的实际用量(含思考 token):和你的估算逐项对比,看偏差落在输入、思考还是输出。多数人的预估错在思考,不在文档。
- 设两条止损:每份文件的成本上限、单份文件的重试上限。重试一次等于成本翻倍,没有上限的批处理会在一个坏文件上烧掉整批预算。
from google import genai

client = genai.Client(api_key="YOUR_KEY")
f = client.files.upload(file="2026-q3-contracts.pdf")

r = client.models.count_tokens(model="gemini-4-neon", contents=[f])
print(r.total_tokens)   # 用这个数 × $3 / 1,000,000
反过来,有四种情况别用 Neon:单份文档做简单字段抽取,Gemini 4 Hydrogen($1.50 / $7.50,有免费层)就够,Neon 的溢价买的是跨文件、多步骤、长会话;要求金额零误差的结算;资料不能出境;需要完整留痕审计。后三种别把模型输出当最终结果,把它当预填,人再过一遍。
扫描件先解决文字层,再谈切片和计费——详见《扫描件提取不出文字:AI 档案检索上线前先查这四步》。合同条款的核对方法看《AI 审合同怎么核对:三道校验,把结论压回原文》。要压上下文开销,还可以参考《MCP 工具装太多怎么裁:工具定义先吃掉 12% 上下文》。
一句话总结:切片解决的是「别为不需要的页付钱」,思考档位解决的是「付了钱拿到什么」。先量 token,再定档位,最后才是选模型。
登录后可点赞、收藏与反馈。