盖德化工:18 份 sitemap,16 份是空文件
一个化工 B2B 站跑着两套站点地图:robots 只报备 2020 年的旧图,90.8% 是同一批分类页的两条地址;没报备的那套 18 份子图里 16 份是 133 字节的空文件。57 条抽样地址,没有一条拿到正文。
一个化工 B2B 站可以同时得两种地图病:报备给爬虫的那份是 2020 年的旧图,90.8% 是同一批分类页的两条地址;没报备的那套挂着 18 份子图,16 份是 133 字节的空文件。这两件事都发生在 guidechem.com 上。
本文把 7 份地图逐份下完、57 条地址逐条复测,然后说明一件事:地图失效不一定是死链,更常见的是「地图交错了对象」。
一、三套地图,只有一套被 robots 报备
guidechem.com 的 robots.txt 只有 16 行、13 条有效指令,其中 Sitemap 指向 /sitemap.xml。这份 520 条 loc 的文件,是整站唯一被正式报备的地图。
但同一域名下 /sitemap_index.xml 也返回 200,里面挂着 18 个子图,命名为 sitemap_product_1..16、sitemap_company、sitemap_buyinfo。
两份地图没有任何一条 URL 重合:旧图全是 /product/list* 分类骨架,新图是产品、供应商、求购三类。也就是说,站内跑着两套地图系统,爬虫只看得到旧的那套,而且没有任何一处注明哪套是准的。
| 地图 | 是否报备 | 文件数 | loc 总数 | 抽样结果 |
|---|---|---|---|---|
| sitemap.xml | 是 | 1 | 520 | 39 条全部 202 空壳 |
| sitemap_index.xml | 否 | 18 | 2,000 | 16 份为空;company 12 条全 404;buyinfo 6 条全 202 |
| 站点实际内容目录 | — | — | — | /trade/、/dictionary/、/expo/ 一条未入图 |
报备的那份:520 条里 236 组是双地址
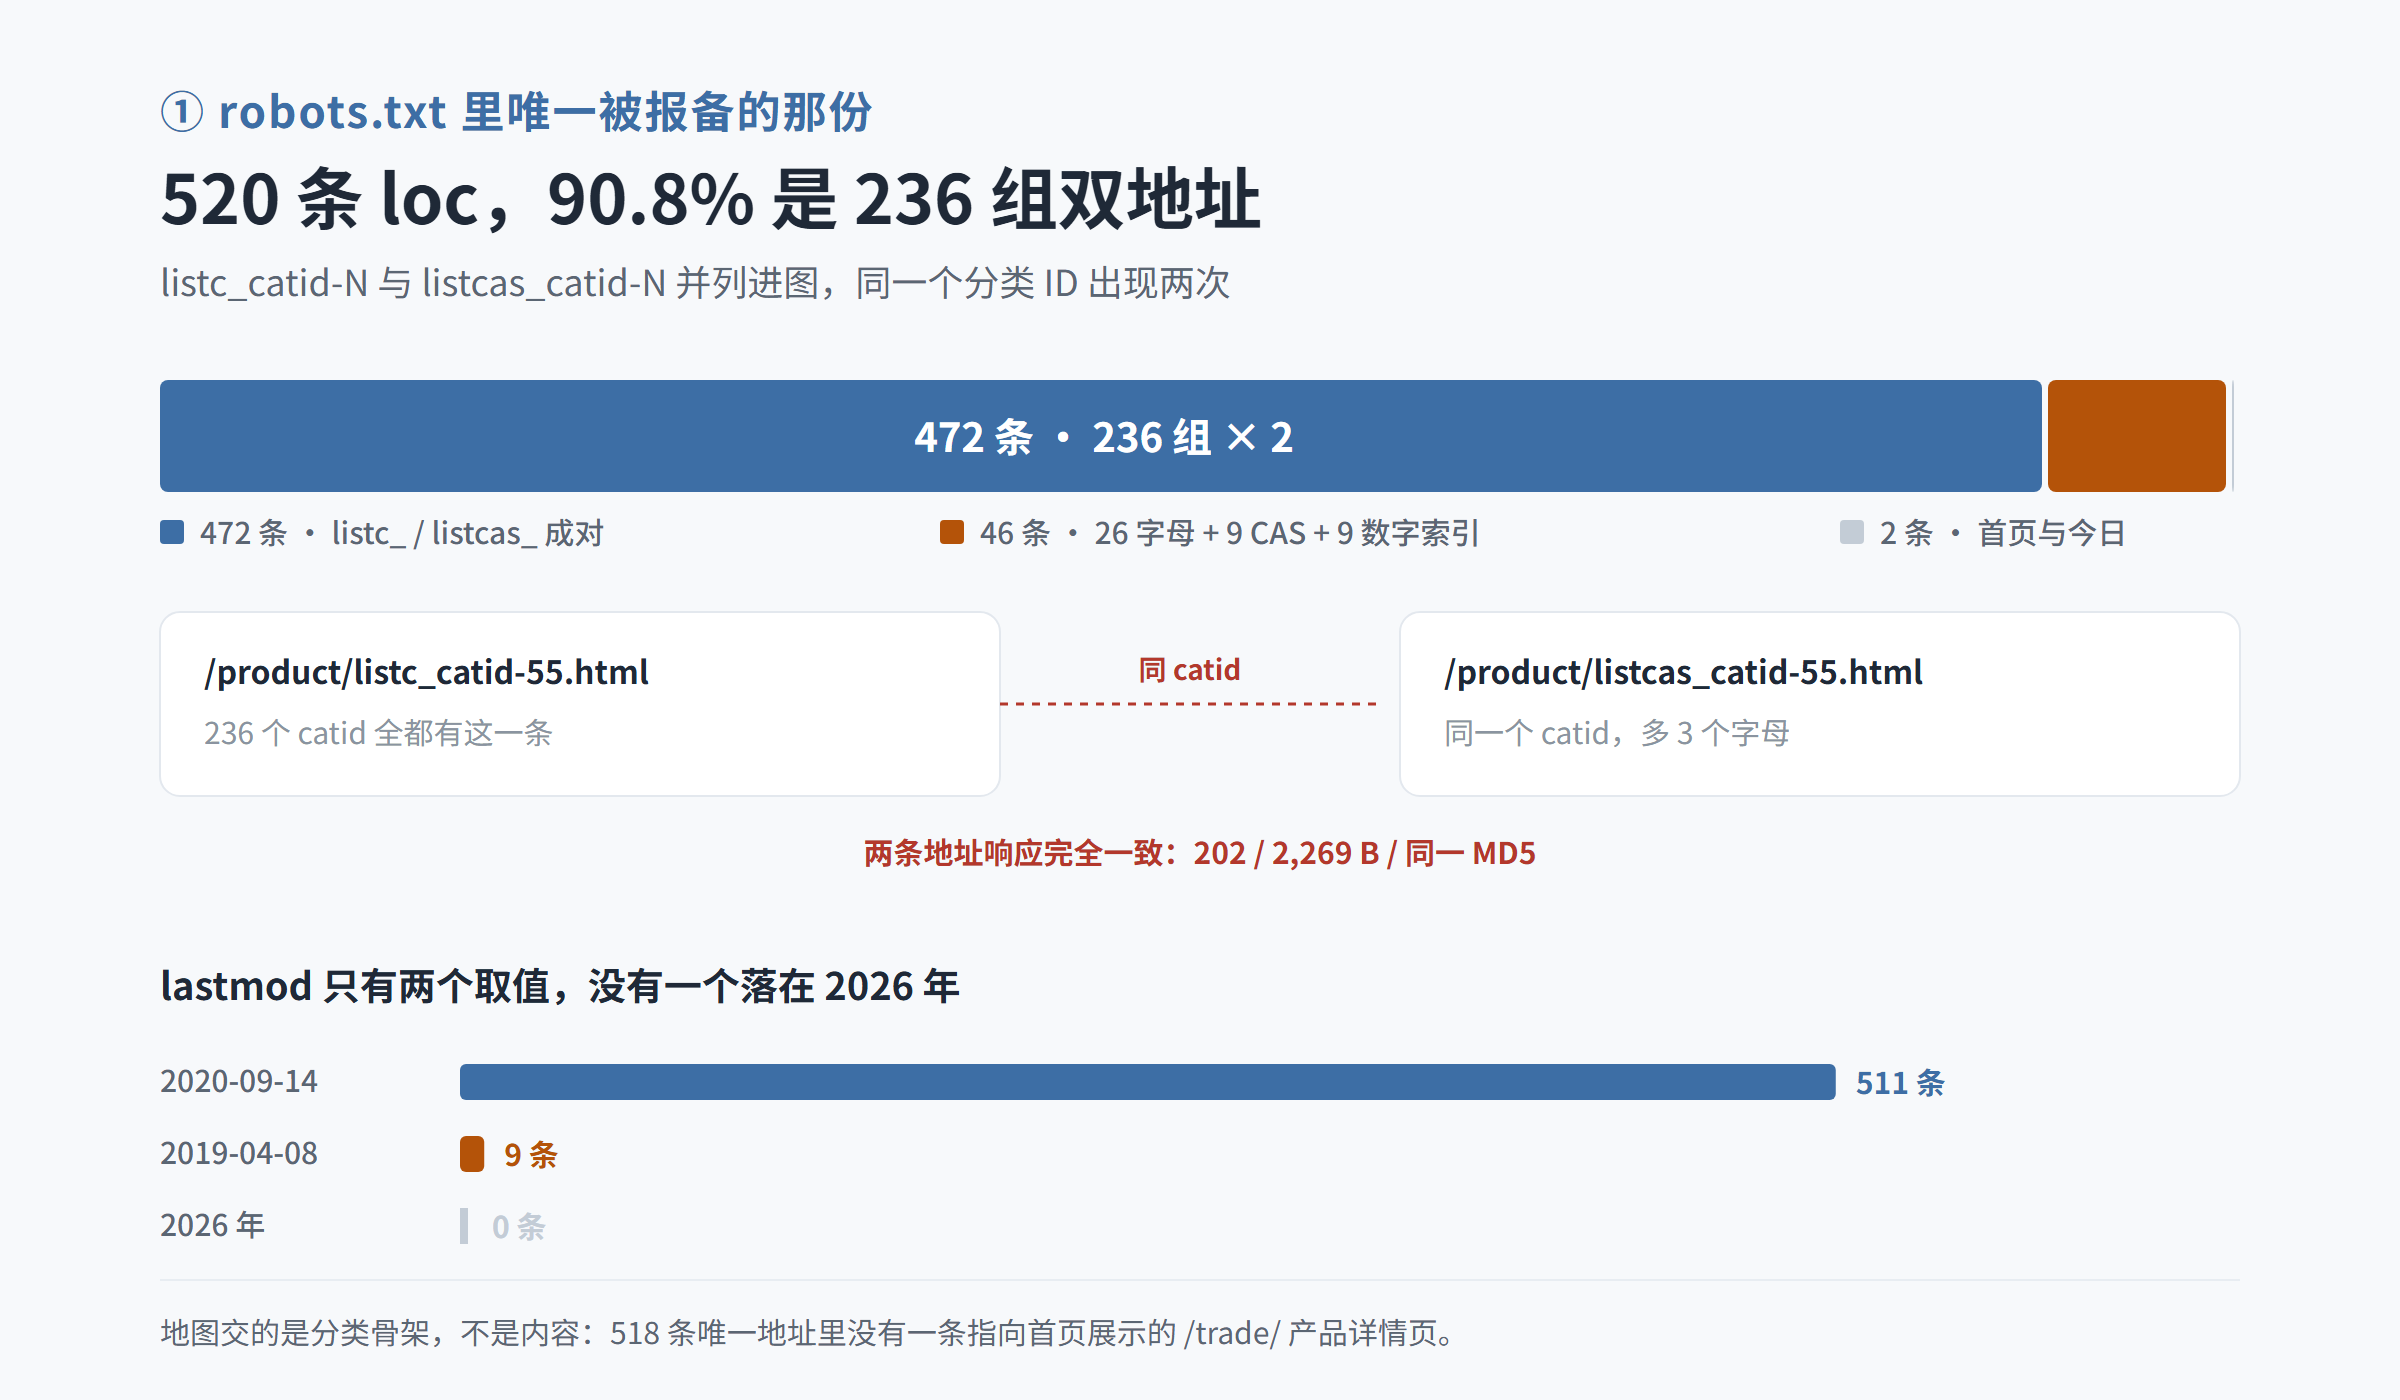
按路径首段与文件名分组,520 条 loc 的构成是:listcas_catid- 237 条、listc_catid- 237 条、26 个字母索引、9 个 CAS 索引、9 个数字索引,以及首页与 today-p1.html 各 1 条。
关键在于前两类:236 个分类 ID 全部成对出现。/product/listc_catid-55.html 与 /product/listcas_catid-55.html 并列在同一份地图里,只差三个字母,指向同一个分类 ID。
472 条除以 520 条,占 90.8%。
另有 2 条 loc 在文件内部重复(listc_catid-561123 与 listcas_catid-561123 各写了两遍),所以 520 条去重后是 518 条。
时间戳同样没在维护:511 条 lastmod 是 2020-09-14,剩下 9 条是 2019-04-08,2026 年一条都没有。changefreq 却写着 daily 475 条——一份五年没动过的文件,告诉爬虫它每天更新。
没报备的那套:16 份是 133 字节
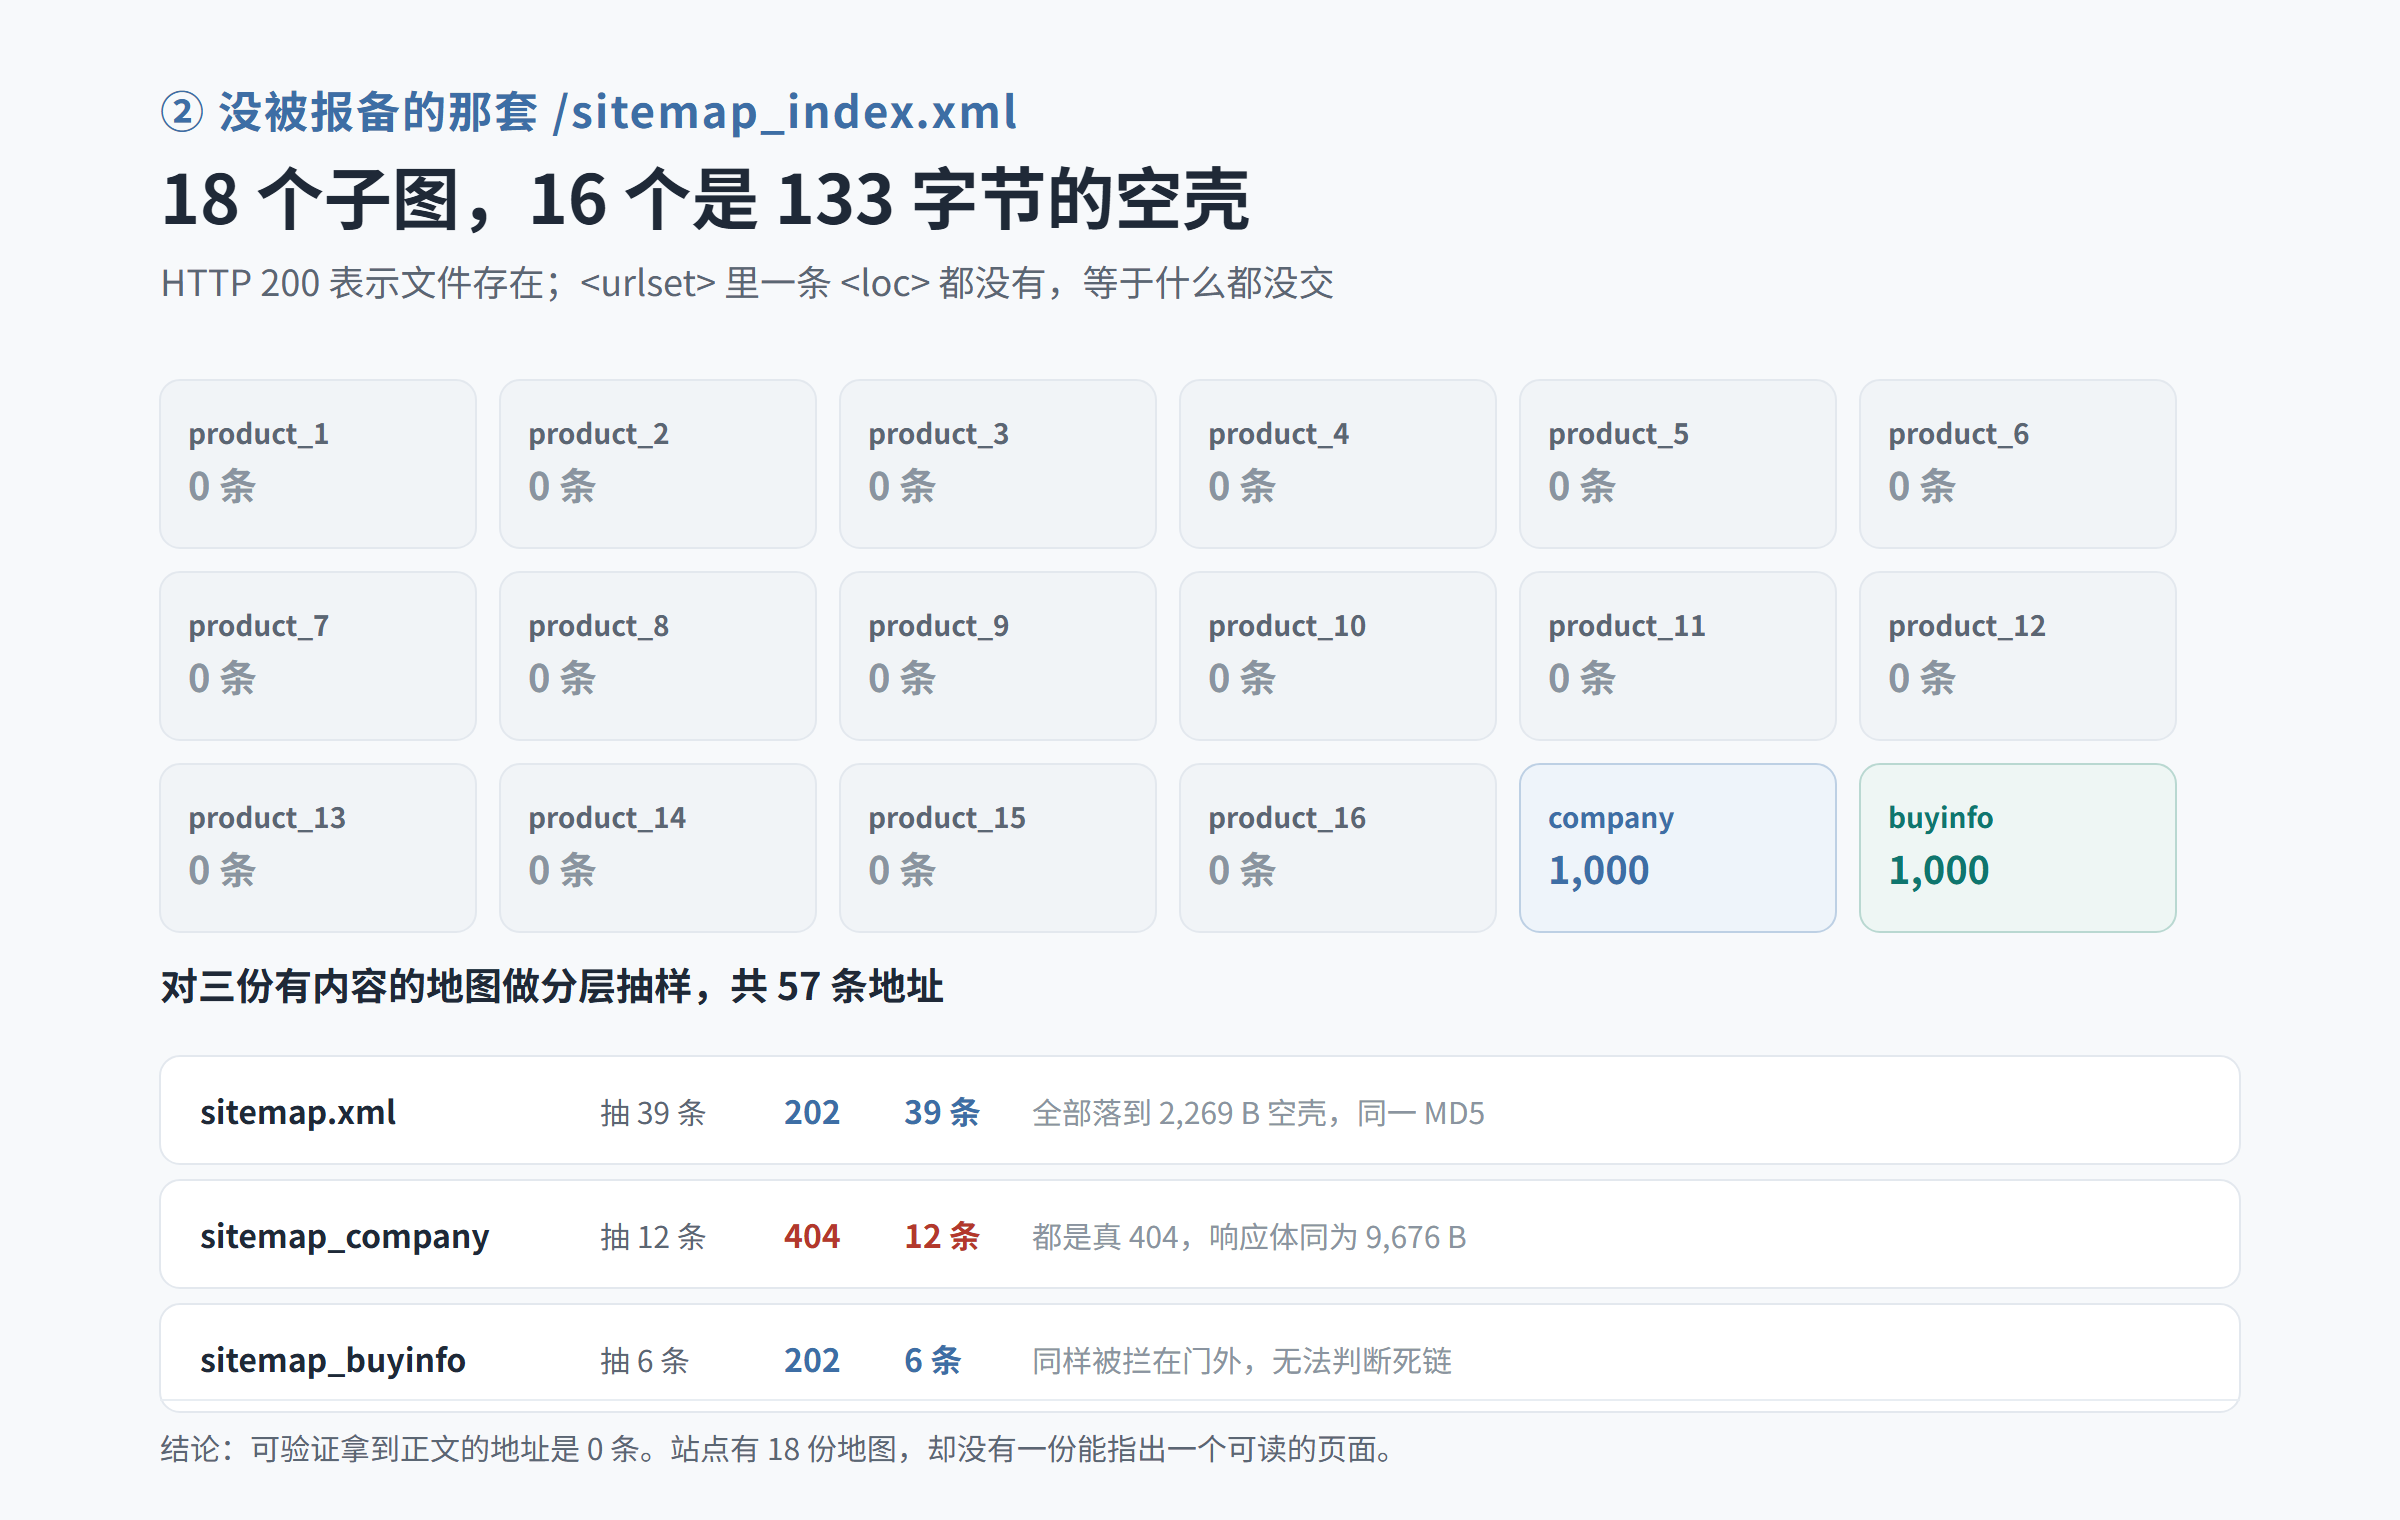
sitemap_product_1.xml 到 sitemap_product_16.xml 全部返回 200,每个文件 133 字节,内容是:
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
</urlset>
一个空的 urlset。HTTP 200 只说明文件在那儿,<loc> 一条都没有,等于什么都没交。16 份除以 18 份,88.9%。
有内容的只有两份:sitemap_company.xml 1,000 条 /com-guide<ID>/,sitemap_buyinfo.xml 1,000 条 /buyinfo/showbuyinfo-...html。
都是整整齐齐的 1,000,像分页脚本写死的上限,而不是库存总数。两份文件都没有 lastmod,也没有 changefreq。
二、抽样 57 条,没有一条拿到正文
对上表三份有内容的地图做分层抽样:sitemap.xml 抽 39 条(覆盖全部 6 个 URL 家族)、company 抽 12 条、buyinfo 抽 6 条,共 57 条。
结果高度一致:39 条全部返回 202,响应体长度一律 2,269 字节,MD5 完全相同;company 12 条全部返回真 404(9,676 字节);buyinfo 6 条又是 202。
那个 202 页面很好认:标题写着 Page loading...,正文只有一个 POST 表单和四个隐藏字段,末尾引入 https://js.guidechem.com:89/check.js。
脚本用 jsjiami.com.v7 混淆过,但最外层没混淆的部分直接暴露了模块名——IpfilterCore,以及它写入的 cookie 名 client。
为了确认判定依据不在 UA 上,同一 IP 下换了六种标识复测:Chrome、Baiduspider、百度移动 UA、Googlebot、bingbot、iPhone Safari。六种结果完全相同,202、2,269 字节、同一 MD5。
这里得把边界说清楚。202 的语义是「请求已受理」,不是「拒绝」;IpfilterCore 这个命名说明判定做在 IP 层,白名单内的真实爬虫应当能正常取到页面。
旁证是爱站:百度来路 62,905 至 85,451 IP、移动来路 33,350 至 50,230 IP、PC 词 34,436 个。一个被全站封锁的站不会有这个量级的词库。
所以问题不是「站点被惩罚」,而是更工程化的三条。
其一,地图指向的目录,恰好是被保护得最严的那一片。其二,非白名单来源(包括几乎所有第三方 SEO 工具)看到的是一片空壳,外链与收录的评估基线因此全部失真。其三,用 202 而不是 503 加 Retry-After,会让部分爬虫判定为「已受理、稍后再来」,反复抓同一批地址。
三、能打开的页面上,三个可量化的短板
首页、/price/、/guideview/ 这三个地址能正常取到内容,正好可以看清页面层的问题。
关键词布局:英文壳,中文入口被自己关掉
首页 80,211 字节,正文只有 47 个汉字,<html lang="en">,title 是 56 个字符的英文,description 也是英文。
hreflang 倒做得规整:en、es、de、fr、ja、ko、pt、ru、ar 加 x-default 共 10 条,路径落在 /es/、/jp/、/kr/ 这样的目录上。
与此同时,robots.txt 写着 Disallow: /dictionary/cn/——把中文化合物词典整段关掉,却保留了 /dictionary/en/。
备案主体是杭州的公司,中文词库并非没有排名,但最有商业价值的那一类入口被自己的规则挡在门外。
页面结构:首页一个 H1 都没有
首页 0 个 H1、0 个 H2、0 个 H3,417 个 href 去重后 286 条,95 张图里 8 张没有 alt(8.4%)。
对比之下 /price/ 是 1 个 H1 加 6 个 H2,/guideview/ 是 1 个 H1 加 9 个 H2,结构反而比首页完整。
图片 alt 的缺口随页面向下放大:/price/ 19 张图 5 张无 alt(26.3%),/guideview/ 32 张图 17 张无 alt(53.1%)。一个以化合物结构图、行情图为内容主体的站,一半以上的图对搜索不可读。
外链:数据拿不到,本身就是结论
爱站的反链一栏是「-」,没有任何数值。原因不难找:robots.txt 单独给 BLEXBot 和 SemrushBot 写了 Disallow: /,全站封禁。
封掉采集器的直接后果是自己也失去了外部视角。一个 16 年域名、上亿级收录的站,反链数据为空,意味着任何第三方都无法判断它的外链结构是健康还是被惩罚,只能靠站内数据自证。
四、修复清单:先修交付,再修页面
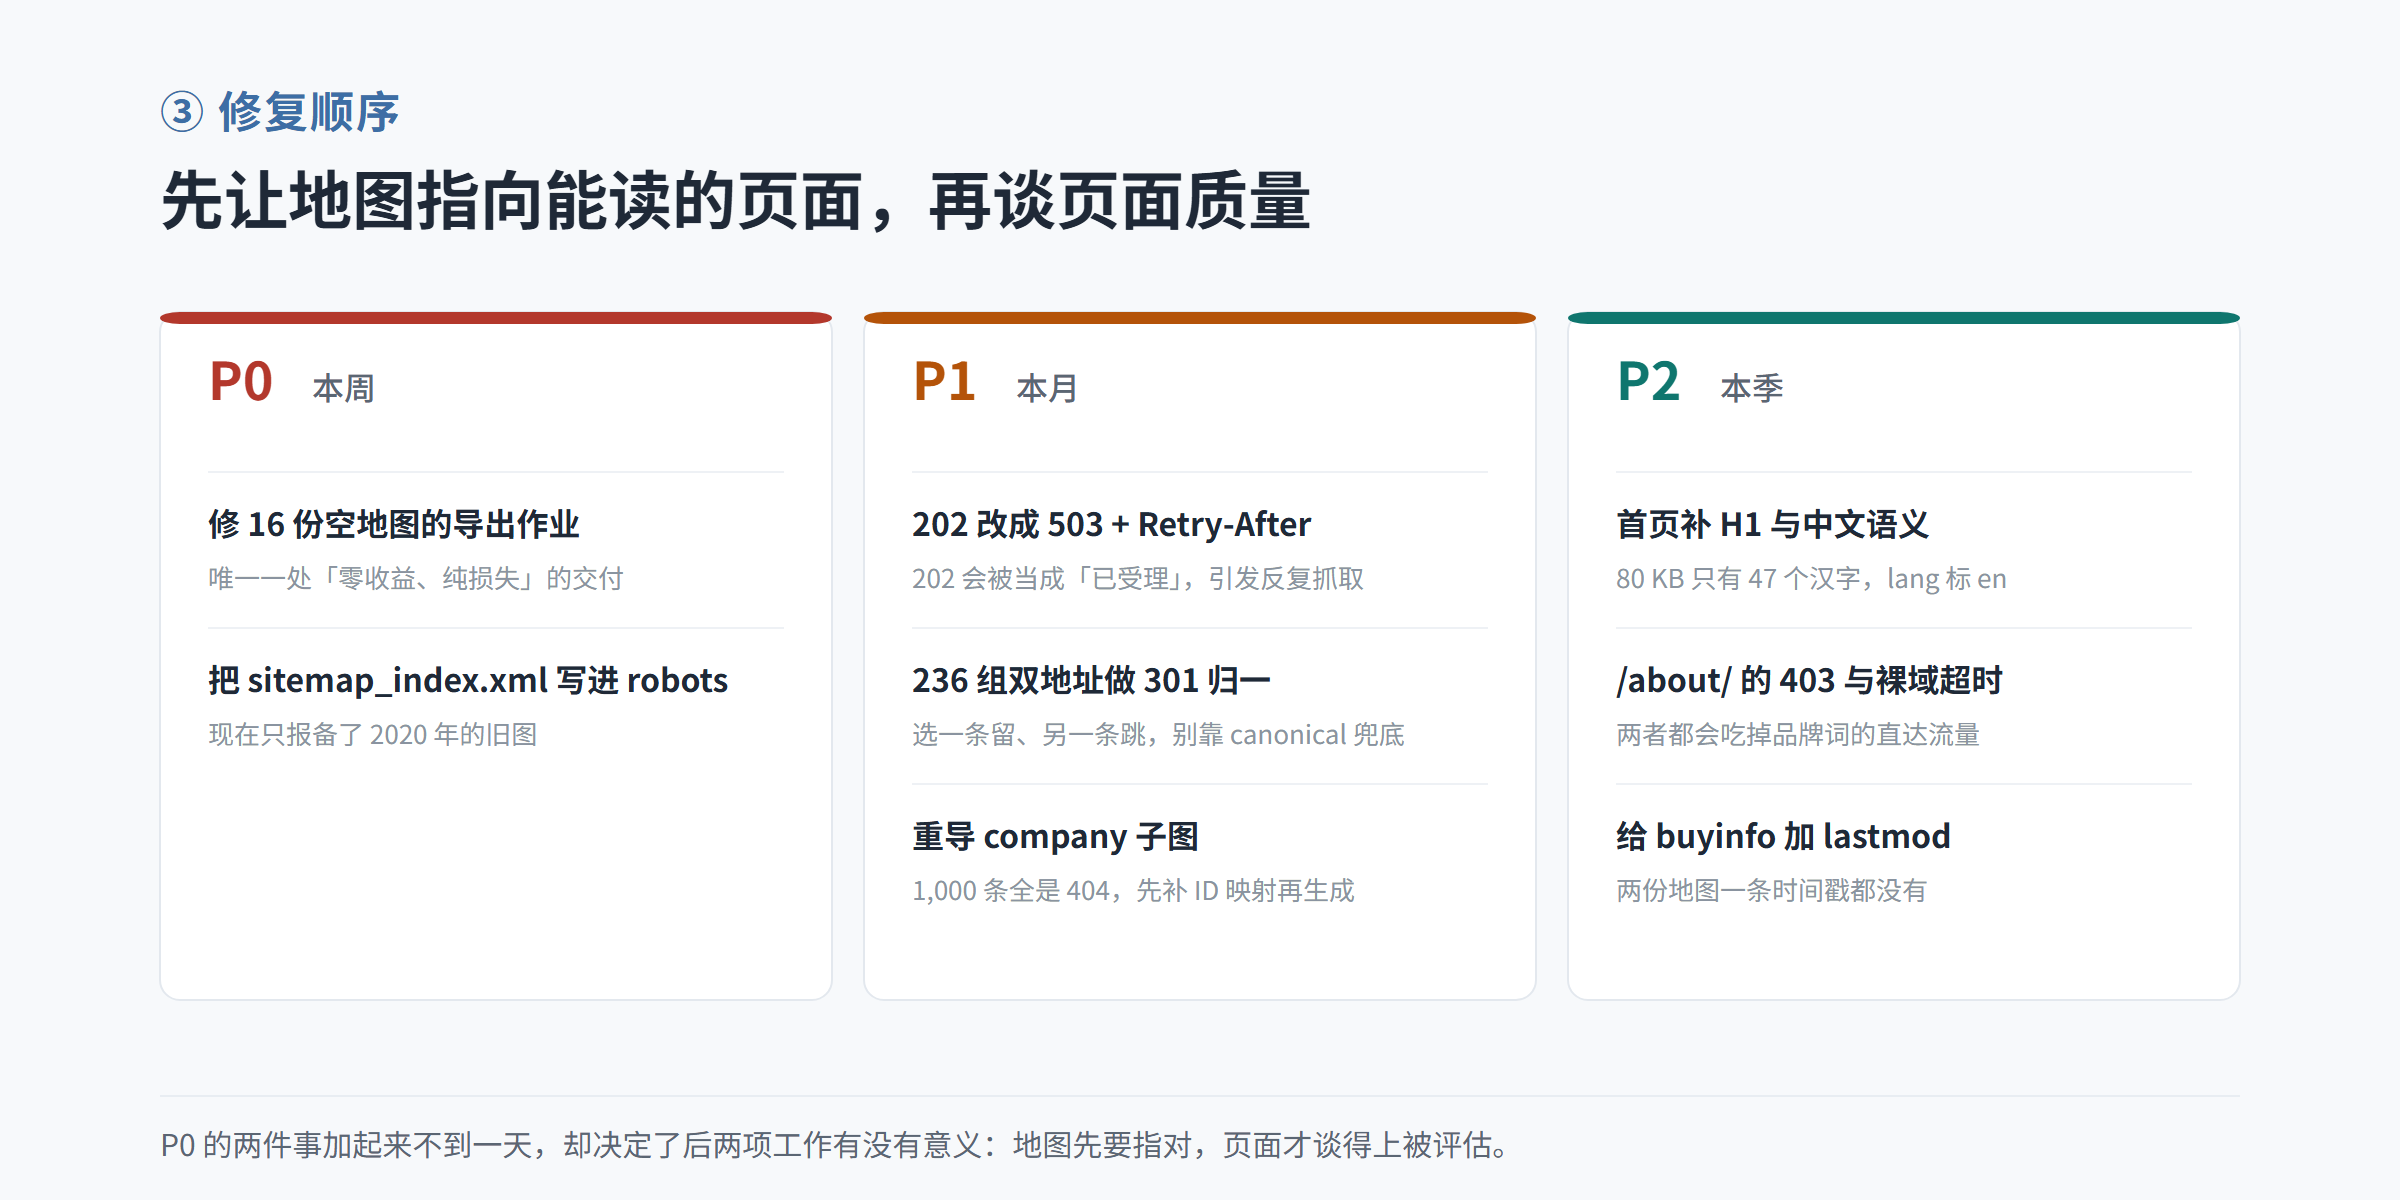
按「影响 ÷ 工作量」排序,七件事分三档。前两件不到一天,却决定后面五件有没有意义。
| 优先级 | 动作 | 为什么先做这件 | 工作量 |
|---|---|---|---|
| P0 | 修 sitemap_product_1..16 的导出作业 | 这是唯一一处纯损失:文件在、内容空、无告警 | 0.5 天 |
| P0 | 把 sitemap_index.xml 写进 robots | 现在爬虫只认 2020 年那份旧图 | 10 分钟 |
| P1 | 202 改为 503 加 Retry-After | 语义正确,避免被反复抓取;顺带给非白名单来源一个明确信号 | 0.5 天 |
| P1 | 236 组双地址做 301 归一 | 留一条、另一条 301,别指望 canonical 兜底 | 1 天 |
| P1 | 重导 sitemap_company 子图 | 1,000 条全是 404,先补 ID 映射再生成 | 1 天 |
| P2 | 首页补 H1 与中文语义 | 80 KB 只有 47 个汉字,lang 标 en | 1 天 |
| P2 | 修 /about/ 的 403 与裸域超时 | 抽样中 /about/ 返回 403(36 字节),裸域解析到 IP 但连接超时,两者都吃掉品牌词直达 | 0.5 天 |
关于双地址那一条,有个细节值得单独说:236 组地址的响应完全一致,外部无法用内容差异判断哪条是主地址。这意味着归一动作必须在服务端做显式 301,而不是在两条页面上各写一个 canonical——后者的前提是页面能被读到,而现在两条都是空壳。
同类失效在别的站上表现不同。中公教育是地图还在、页面已 404;快递100 是页面在、canonical 指向 404;什么值得买是地图有效、但 5 万条 lastmod 挤在 11 分钟里。
盖德化工这一例的特征是「地图系统本身有两套,且没有一套是准的」。这类问题不会在任何一个单一指标上报警。
小结:判断一个站的地图是否健康,先别看条数。看三件事——robots 报备的那份是不是最新的那份,子图里有没有 0 条 loc 的空文件,以及抽样 50 条能不能拿到正文。这三个问题的答案,比收录量更能说明抓取预算花在了哪里。
登录后可点赞、收藏与反馈。