孔夫子旧书网 SEO 实测:1410 万收录,共用一个标题
24 年老站、百度权重 6、1410 万条收录,但它的书籍详情页在桌面爬虫眼里全部叫「孔夫子旧书网」。实测六种爬虫 UA、robots、sitemap、跳转链与结构化数据,并给出按优先级排序的修复清单。
一个开了 24 年的二手书交易平台,百度收录 1410 万条,PC 与移动权重都是 6。但它的书籍详情页,在百度桌面爬虫、搜狗、360、必应的眼里,标题全都叫同一个名字:孔夫子旧书网。
本文用六种爬虫 UA 对照实测了 kongfz.com,把问题按「修复收益」排了序。所有结论都来自可复现的请求,不含推测。
一、结论与实测样本
三条结论,按严重程度排列。第一,服务端渲染的开关是「设备类型」,不是「是否为爬虫」,桌面爬虫拿到空壳,移动爬虫拿到完整页。第二,Googlebot 全站返回 503,首页、详情页、分类页无一例外。第三,详情页描述的字段映射整体错位一位。
第一条是结构性的。它让 9000 万种书籍详情页,在桌面索引里共用一个标题。
请求全部用 curl 直连,固定 UA 与路径,间隔 2 至 3 秒,避免被限流误判。样本包括首页、三个不同 ID 的书籍详情页、搜索分类页、搜索列表页。外部权重与词量取自爱站综合查询,时间窗为 2026-11-11 当日。
二、发现一:SSR 只看设备,不看爬虫
同一条详情页 item.kongfz.com/book/66386592.html,换六种 UA 请求,拿到六种结果。
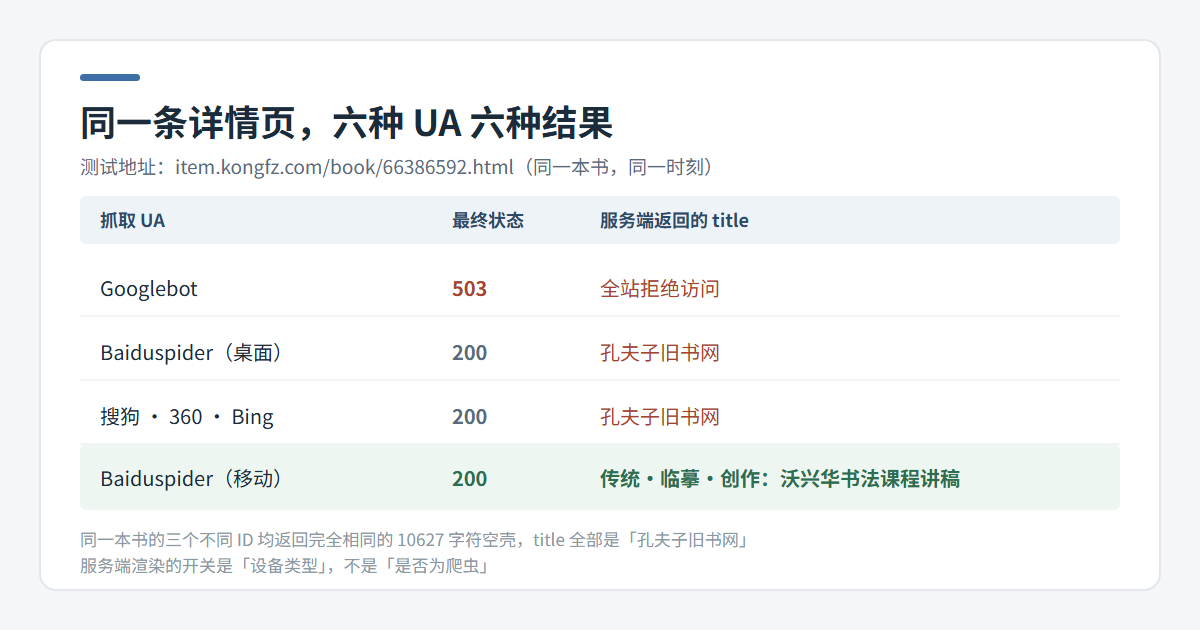
桌面 UA 与百度桌面爬虫拿到的是 10627 字符的外壳:Vue3 打包产物、modulepreload 预载脚本、title 硬编码为「孔夫子旧书网」,keywords 与 description 都是空字符串。
我抽了三个 ID(66325696、66386592、88001122),返回字节数一字不差,都是 11041 字节。服务端没有向 HTML 注入任何书籍数据,等于承认这三页在爬虫看来内容完全相同。
移动 UA 拿到的则是完整渲染页:真实书名进 title,真实简介进 description,有唯一 H1,有 canonical,还有一条 JSON-LD。
这形成了一组自相矛盾的信号。授权信号全在移动端,可 canonical 却指回桌面地址,而桌面地址恰恰是那具空壳。
为什么桌面爬虫是重灾区
百度移动爬虫带 iPhone UA,能触发 SSR,所以移动词有 24355 个。但百度桌面爬虫、搜狗、360、必应的 UA 都不含移动标识,一律落到空壳分支。
换句话说,同一本书,手机搜得到,电脑搜不到。这不是内容问题,是分支判断写错了维度。
三、发现二:Googlebot 全站 503
这一项最干脆。Googlebot UA 请求首页、详情页、分类页,三次全部返回 503 Service Temporarily Unavailable,响应体 206 字节。同一秒切回普通 UA 请求同一路径,立刻 200。
页面响应头里有 X-WAF-UUID,说明前置有 WAF。常见做法是按 UA 字符串拦截「自称 Googlebot 但没做反向 DNS 校验」的请求,用于防采集。问题是这规则把真爬虫一起拦了。
对中文站来说,Google 流量占比低,痛感不强。但 503 是临时状态码,Google 会持续重试并逐步降低抓取预算,等于主动放弃了全部海外长尾。
四、发现三:描述字段整体错位一位
移动端 SSR 的内容是对的,但描述模板在拼装时错了一位。两本书的实测输出:
《跨文化误解关键词 中欧思想家对话》作者:生活·读书·新知三联书店,出版社:2026年7月 第1版,ISBN:105.00。
《传统·临摹·创作:沃兴华书法课程讲稿》作者:上海古籍出版社,出版社:2026年5月 第1版,ISBN:78.00。
「生活·读书·新知三联书店」和「上海古籍出版社」都是出版社,却被写进了作者位。出版时间「2026年7月 第1版」被写进出版社位。价格 105.00 和 78.00 被写进 ISBN 位。三处映射全部前移一格。
这个错误在搜索结果摘要里直接可见。用户看到的是「作者:某出版社,ISBN:78.00」,专业感当场归零。
结构化数据只覆盖了一家
移动端页面的 JSON-LD 用的是百度 cambrian 格式,不是 schema.org。字段只有 title、images、pubDate 三项。缺的是电商详情页最该有的那些:isbn、author、publisher、price、seller、availability。
这让页面既进不了百度的商品卡,也进不了 Google 的富结果。还有三个细节。@id 指向 m.kongfz.com,canonical 却指向 item.kongfz.com,两个域各说各话。title 被截成「传统·临摹·创作:沃」,只有 12 个字。pubDate 填的是抓取时间,不是出版时间。
其余技术项一次看完
| 检查项 | 实测结果 | 判定 |
|---|---|---|
| robots.txt | HTTP 404,返回 54985 字节报错页 | 缺失 |
| sitemap.xml | HTTP 200 但 0 字节,Content-Type 为 text/html | 软 404 |
| 首页 canonical | 无 | 缺失 |
| 首页 H1 与 H2 | 0 个 H1、0 个 H2,唯一 H3 内容是「我的订阅」 | 无结构 |
| 首页外链分布 | 938 条链接中 727 条指向 search.kongfz.com | 权重过度集中 |
| 首页 http 链接 | 14 条 http 绝对地址 | 混合协议 |
| 首页图片 alt | 86 张图中 27 张有 alt | 覆盖率 31% |
| viewport | width=1020,移动 UA 请求结果相同 | 非响应式 |
| 裸域跳转 | https 裸域 301 到 http,再 301 回 https | 两跳且降级 |
| 详情页跳转 | .html 地址 302 临时跳到 /item/book/ | 应用 301 |
| 404 页面 | 真 404,但 title 为空 | 状态码合格 |
| m 子域 | 响应式,标题与主站不同,无 canonical | 双版本未标注 |
两个细节值得单独说。robots.txt 的 404 页面返回的是未编译的前端模板,HTML 里能直接读到以百分号加左尖括号开头的 webpack 占位符,构建配置泄露到了线上。sitemap.xml 更有意思,状态码 200、内容长度 0,属于典型软 404,比干脆 404 更消耗抓取预算。
同类问题在垂直站里并不罕见。波奇网 SEO 实测那篇里,98 个 sitemap 子文件的 lastmod 全部停在 2016 年 6 月;菜鸟教程 SEO 实测则是 127 万收录、一周新增仅 7 页。这套「收录看着漂亮、增量近乎停滞」的组合,往往都能在 sitemap 和抓取预算上找到同一个根因。
五、反链 87 条,为什么还有 26322 个词
这是整篇里最反直觉的一组数据。艾站统计的百度反链只有 87 条,域名却做到 PC 词 26322 个(前 10 名 3882 个)、移动词 24355 个(前 10 名 2215 个),日均 IP 约 11.4 万。
原因有三个。
第一,域名 2002 年 4 月注册,24 年历史,品牌词「孔夫子旧书网」在二手书这个细分里近乎绝对垄断。品牌词不需要外链。
第二,移动端拿到的是完整 SSR 页,词量主要由移动侧贡献。移动词前 10 名 2215 个,占移动总词量的 9%,这个头部集中度对电商站来说是健康的。
第三,首页把 938 条链接里的 727 条压给 search.kongfz.com,站内权重高度集中于搜索子域,用内链代替了外链做权重调度。
所以它不是靠桌面端结构质量取胜的。这也解释了为什么桌面端问题能拖这么久没被发现:天花板还没到,痛感就不强。
六、优化建议与自查方法
P0:两周内可完成,收益最大
一、把 SSR 的分支判断从设备改为爬虫身份。 维护一份爬虫 UA 白名单,命中即走完整渲染。改动量小,一次性解决桌面端全部详情页的标题、描述、H1 缺失。这是本文所有问题里唯一一个「改一处、修 9000 万页」的动作。
二、解除 Googlebot 的 503。 对 WAF 规则做反向 DNS 校验后再放行,或直接放行 Googlebot 官方 IP 段。放行后 4 周内观察 Search Console 的抓取统计是否恢复。
三、修正描述字段映射。 按 schema.org Book 的语义重排模板:author 取作者字段、publisher 取出版社字段、isbn 取 ISBN 字段、price 单独输出。发布前用两本书做回归比对,确认四个值各自落在正确位置。
P1:一个月内
四、补 robots.txt 与 sitemap。 robots 声明 Sitemap 行;sitemap 按书籍 ID 分片,单文件不超过 5 万条,lastmod 用真实更新时间。顺手修掉 404 页面里未编译的模板占位符。
五、.html 地址改 301。 现在是 302 临时跳转,每天数百万次抓取都多走一跳,且不传递权重合并信号。
六、裸域直接 301 到 https 主域。 现在路径是 https 裸域跳 http、再跳 https,中途还降级了一回协议,等于把安全信号自己拆了。
P2:结构性改造
七、首页补 H1。 现在 0 个 H1、0 个 H2,唯一 H3 的内容是「我的订阅」,语义上等于没有。建议 H1 承载品牌名加核心品类词。
八、统一移动端与桌面端。 两条路:把 www 改成响应式,viewport 从 width=1020 改为 width=device-width;或保留 m 子域但补齐双向标注,桌面页加 alternate、移动页加 canonical。现状是两边互不认领。
九、结构化数据换成 schema.org。 以 Book 为主类型,补 isbn、author、publisher、bookFormat;价格、库存、卖家信息用 Offer 嵌套。百度的 cambrian 可以保留,两者不冲突。
十、补齐 alt 与协议。 86 张图还有 59 张缺 alt;14 条 http 链接统一改 https,避免混合内容告警。
四步自查同样的毛病
不需要工具,四步就够。
第一步,用 curl 分别带桌面 UA 和 Baiduspider UA 请求同一个详情页,比较两次响应的字节数和 title。字节数相同、title 相同,就说明 SSR 没生效。
第二步,带 Googlebot UA 请求首页,看状态码。不是 200 就说明有 WAF 规则误伤。
第三步,看详情页 description 里的作者、出版社、ISBN、价格四项,逐项对照页面可见内容,确认没有错位。
第四步,请求 sitemap.xml,同时看状态码和 Content-Length。200 配 0 字节是最容易被忽略的软 404。
这四步十分钟能跑完,能覆盖本文列出的八成问题。像古文岛 SEO 实测那样体量的内容站,也曾出现 robots 与 sitemap 三件套全 404 的情况。垂直站做久了,前端重构和 SEO 配置很容易两条线各走各的,定期巡检一次,比等到流量下滑再排查便宜得多。
本文为本站原创实测分析,测试时间 2026-11-11,样本与请求方式已在正文说明。外部权重数据引自爱站综合查询,词量为第三方估算口径,仅作横向参考。
登录后可点赞、收藏与反馈。