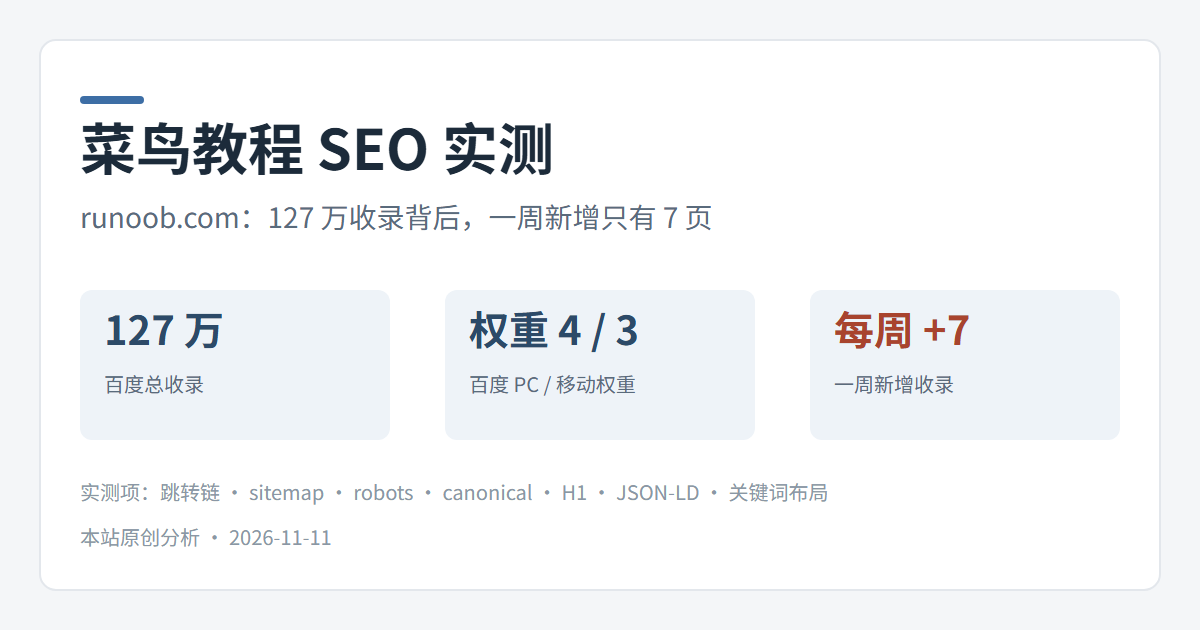
华律网 SEO 实测:6310 万收录,站点地图只报 1 万条
22 年老站、百度权重 7/7、收录 6310 万条。直接抓取后发现,robots 里声明的站点地图只有 1 万条 URL,分片索引停在 2023 年,移动端 302 跳转且两端都不声明 canonical。本文给出实测证据与按投入产出排序的修复清单。
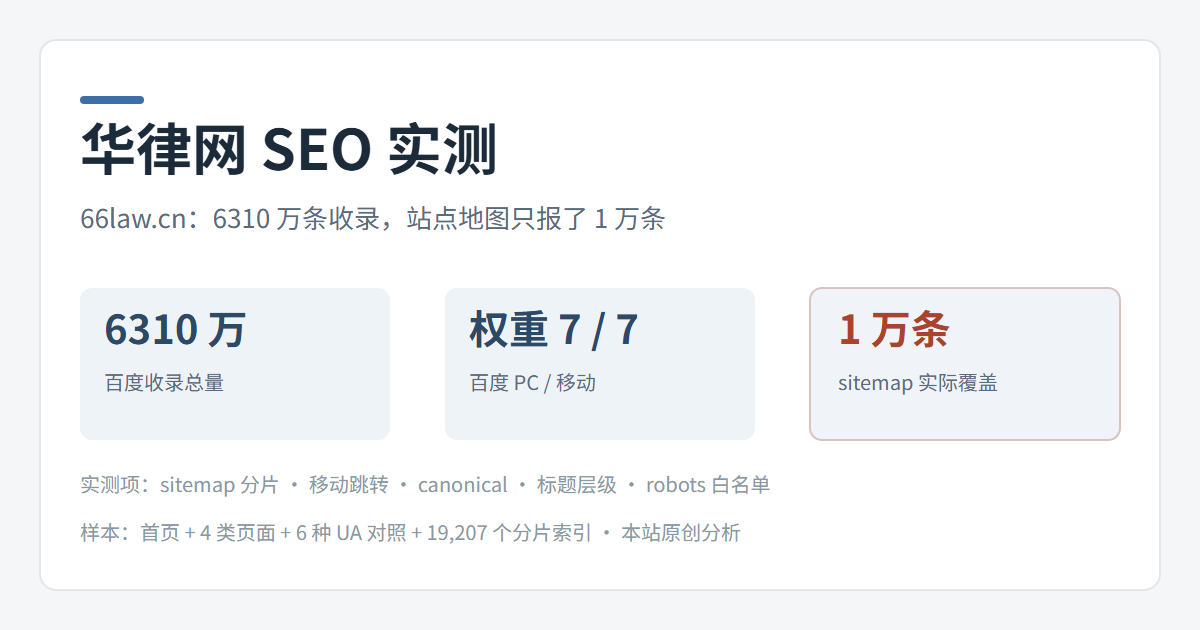
华律网(66law.cn)是法律咨询领域体量最大的站点之一。它的内容不缺,缺的是让搜索引擎高效发现内容的机制。本文基于 2026 年 11 月 11 日的直接抓取,给出可复现的证据。
一、基本盘:内容规模从来不是短板
先用第三方工具和页面实测确认它的体量。
| 指标 | 实测值 | 判断 |
|---|---|---|
| 百度收录 | 63,101,975 条 | 超大规模 |
| 百度权重 | PC 7 · 移动 7 | 行业头部 |
| PC 关键词 | 145,373(前 10 名 12,256) | 强 |
| 移动关键词 | 100,164(前 10 名 5,925) | 强 |
| 百度反链 | 82 条 | 极低 |
| 域名年龄 | 22 年 10 个月(2004-01-06) | 老站 |
| 首页 a 标签 | 1,876 个 · 唯一 1,343 个 | 偏多 |
| 首页 H1 | 0 个 | 缺失 |
| canonical | 首页、详情页均为 0 | 全站缺失 |
| 结构化数据 | 仅百度 cambrian | 不完整 |
六千三百万条收录配 82 条反链,这个组合本身已经说明问题:它是纯站内长尾驱动型站点,几乎不吃外部链接。
顺带说明一处数据:爱站收录趋势显示近一周百度收录减少约 3,690 万条。与 6,310 万总量叠加后不合常理,判断为统计口径切换,本文不据此下结论。
二、站点地图:10,000 条上限与冻结三年的分片
robots.txt 只声明了两个 sitemap 地址,这是全部。
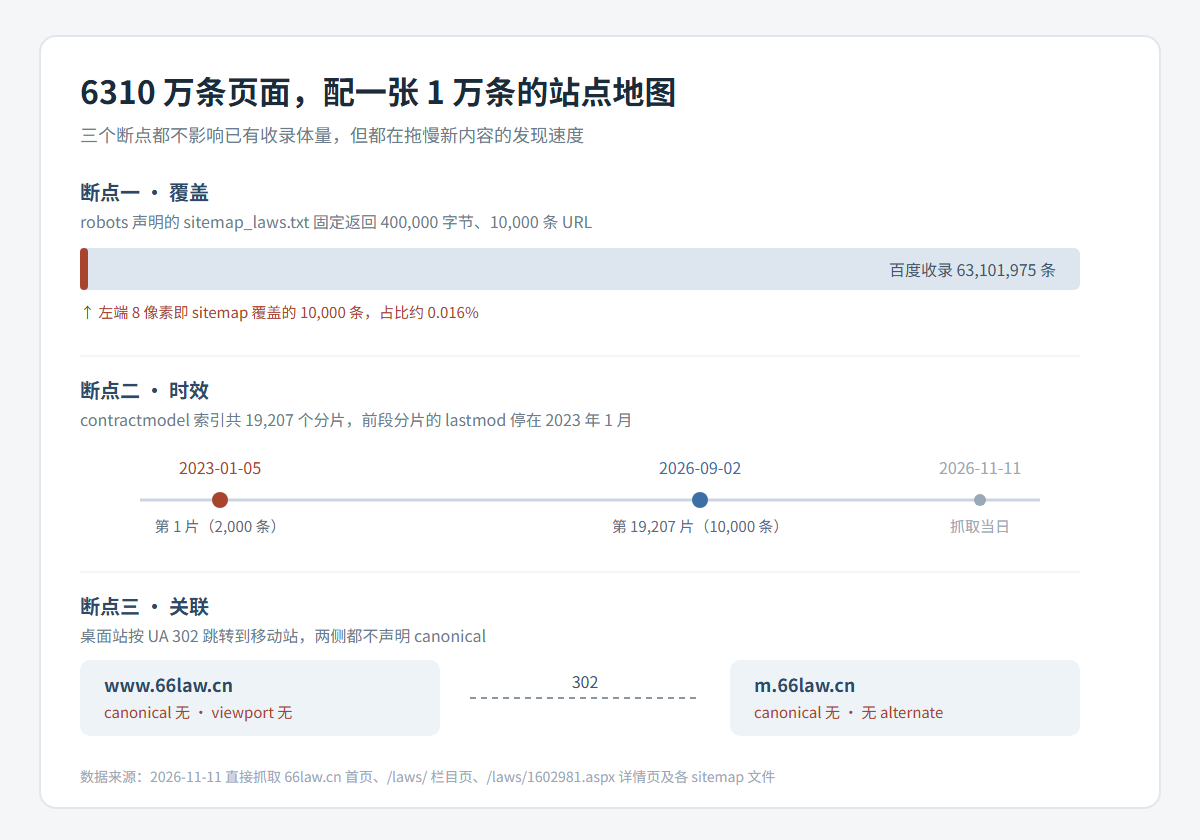
第一个是 sitemap_laws.txt,纯文本列表。实测返回字节数恰好 400,000,正好 10,000 行,URL 从 laws/1602981.aspx 递减到 laws/1592982.aspx。
400,000 字节是一个干净到可疑的整数,说明这个文件是按固定体积截断生成的,而不是按内容范围生成。
它和收录量的比值是 0.016%。换言之,这张站点地图对爬虫的理解几乎没有帮助。
第二个是 sitemapxml/baidu/sitemap/contractmodel/index.xml。这个索引返回 3 MB,含 19,207 个子分片。
抽查两端:第 1 片 2,000 条,lastmod 全部是 2023-01-05;第 19,207 片 10,000 条,lastmod 是 2026-09-02。
前段分片停更接近三年十个月,却仍然留在索引里被反复提交。爬虫按索引顺序抓取时,会先撞上一大批已知陈旧的地址。
标准位置 sitemap.xml 返回 404。站点从未提供这个约定俗成的入口。
第三个信号来自发布频率:爱站口径下一周收录 15.94 万、一月收录 48.6 万。按此推算,站点每月新增或改写约 48.6 万条 URL,而站点地图固定只报 1 万条。
发现能力的缺口,就是这么拉开的。
三、移动适配:302 跳转,两端都不声明主版本
用桌面 UA 请求首页,得到 200,无 viewport。用 iPhone UA 请求同一地址,得到 302,跳转到 m.66law.cn。
第一个问题是跳转码。设备分流是长期策略,不是临时调整,302 属于错误语义。它会让搜索端保留两个 URL 的并行状态,而不是完成合并。
第二个问题更关键:两端都没有 canonical。www 页面没有,m. 页面也没有,同时也没有用 rel=alternate 做配对声明。
结果是两个版本各自积累信号,谁都不承认对方是主版本。对一个收录六千万条的站点,这类稀释是按比例放大的。
四、页面结构:没有 H1 的首页,没有出口的栏目页
首页 H1 数量为 0,只有 5 个 H2 和 8 个 H3。/laws/ 栏目页同样 0 个 H1。
首页有 1,876 个 a 标签、1,343 个唯一 URL;/laws/ 一页 1,189 个链接。这个量级会显著消耗抓取预算,而其中多数是指向同一批热门页面的重复入口。
更值得注意的是分页。/laws/ 页面上没有任何「下一页」链接,只有一个需要 JavaScript 触发的「更多」按钮。实测 /laws/list_2.aspx 返回 404。
也就是说,栏目页不向爬虫暴露任何翻页路径。深层内容只能靠站点地图和爬虫的历史路径发现——而站点地图只报 1 万条。
404 处理也有改进空间。请求一个不存在的无斜杠路径,服务端会先 301 补上斜杠,然后才返回 404。每次误访问多消耗一次请求。而 404 页面上只有 3 个链接,几乎是个死胡同。这一点比菜鸟教程的站点地图断链问题更容易修。
五、详情页模板的四处硬伤
以 laws/1602981.aspx 为样本,页面本身是合格的:标题用「问题词 + 法律知识 + 品牌」模板,H1 唯一,正文约 1,650 字,gzip 后 14.8 KB。
问题集中在模板层。
标题层级断档。 全文标签顺序是 H1 之后连出 10 个 H3,中间没有 H2。对小节结构来说,这意味着大纲信息丢失。
描述自动截断。 description 是正文首段的硬切,以「...」收尾,句子不完整。这类描述在结果页上的点击率通常低于人工撰写版本。
关键词字段形同虚设。 keywords 里只有标题本身,末尾还带一个多余空格。这个字段早已不影响主流排序,但它暴露了模板对 SEO 字段的处理方式——填满即可。
结构化数据只有百度。 页面只有一段 cambrian 标注,提供 pubDate 与 upDate。没有 Article、BreadcrumbList,也没有针对法律服务场景的 LocalBusiness 或 ProfessionalService 标注。
另外两处值得记录:正文里有 12 条关键词锚文本,「华律网」和「法律咨询」都指向首页;作者署名是「华律网整理」,法律属于典型的 YMYL 领域,无署名、无资质说明是明确的 E-E-A-T 短板。
这一点和古文岛的自动抓取内容面临同样的信任成本,只是法律领域的容错率更低。
六、robots:把 AI 搜索一起关在门外
robots.txt 采用了白名单写法:逐条为 Baiduspider、Sogou、360Spider、bingbot、Googlebot、Bytespider 等单独写 Allow,然后在 User-agent: * 下写 Disallow: /。
名单里没有 GPTBot、ClaudeBot、PerplexityBot、OAI-SearchBot,也没有 Applebot-Extended。它们全部落入通配组,被整站禁止。
实测验证了一件事:用 GPTBot UA 请求详情页,服务器照样返回 200 和完整内容。robots.txt 是声明而非执法,它拦不住不守规矩的抓取方。
但守规矩的那部分会照做。代价是在 AI 搜索的引用池里彻底消失,而这个入口的权重还在上升。
还有一个格式细节:所有记录写成 Allow:/,冒号后没有空格。多数解析器能容错,但这不符合标准写法,在解析器差异较大的环境下是可控风险。
七、按投入产出排序的修复清单
- 补 canonical(半天工作量)。 详情页与栏目页自指 canonical;移动页指向对应桌面 URL,桌面页加 rel=alternate 指回移动页。这是当前最高优先级的单项修复。
- 把 302 改成 301。 设备分流跳转应当是永久语义。一处配置改动,消除长期存在的信号分裂。
- 重建站点地图策略。 按内容类型拆分索引,去掉 10,000 条的体积截断,把 laws 目录按月增量分片;同时提供
/sitemap.xml指向总索引。停止提交 lastmod 停在 2023 年的空转分片。 - 给栏目页补分页出口。 用真实 a 标签输出「下一页」与页码,让爬虫有路径可走。这一步能让新内容的发现周期从「等推送」变成「可遍历」。
- 修标题层级与描述。 小节用 H2,子项用 H3;description 改为人工模板或首段语义完整的前 80 字,去掉省略号。
- 补结构化数据。 在保留 cambrian 的同时输出 schema.org 的 Article 与 BreadcrumbList,咨询与律师页再叠加 ProfessionalService。
- 重新评估 AI 爬虫策略。 如果目标是获得 AI 搜索引用,就把 GPTBot、ClaudeBot、PerplexityBot 从通配封禁中放出来;如果目标是防止内容被训练,就保持现状,但要清楚这是主动取舍而非默认结果。
结论
华律网的问题不是内容不行,而是把「内容生产」和「内容分发」当成了同一件事。
六千万条收录证明了历史积累,但 1 万条的站点地图、冻结的分片索引、断掉的分页出口和缺失的 canonical,说明新增内容的发现链路已经和内容规模脱节。
这类问题的共同特征是:不修也能活,修了才跟得上。对比孔夫子旧书网那种爬虫直接看不到内容的硬故障,华律网属于慢性损耗——更难察觉,但同样在扣分。
登录后可点赞、收藏与反馈。