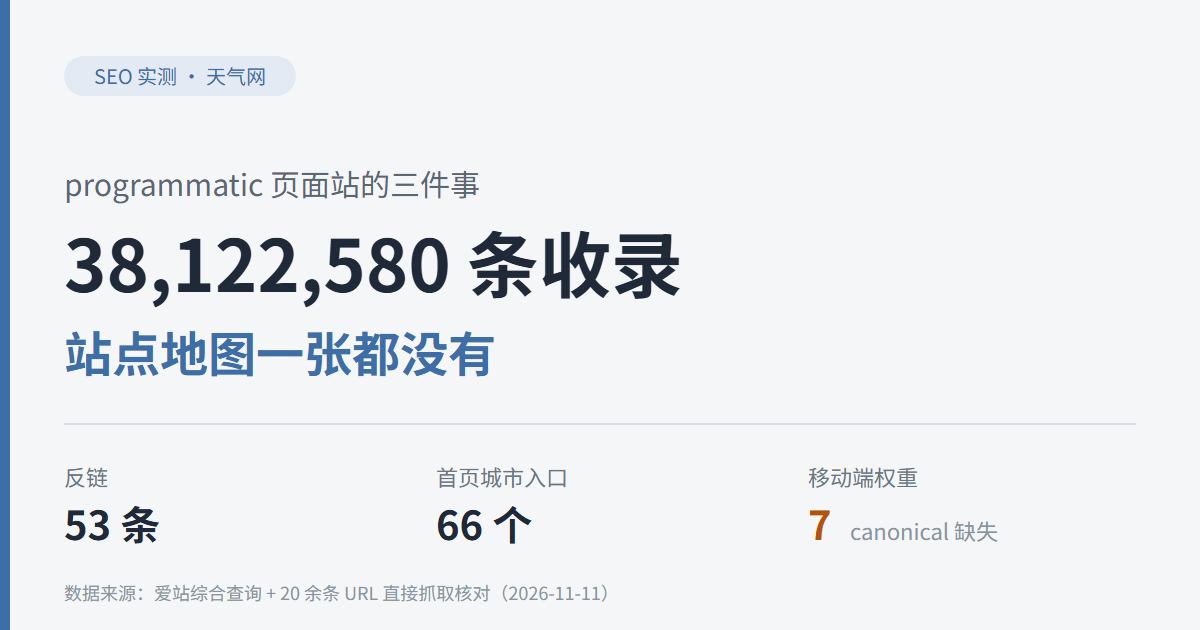
链家 SEO 实测:主域收录 9 条,地图挂在城市站
链家把 120 个城市站做成矩阵,主域只负责 302 跳转。多 UA 实测发现通配规则写坏、地图只挂子域、列表页 100 页封顶三个缺口,附八条带优先级的修改建议。
链家把二手房生意拆成 120 个城市站,主域只做一件事:把访客送去其中一个。我们按多 UA 对照抓了一遍,发现三处结构性缺口。
首页不是入口,是一张按 IP 分发的跳转单
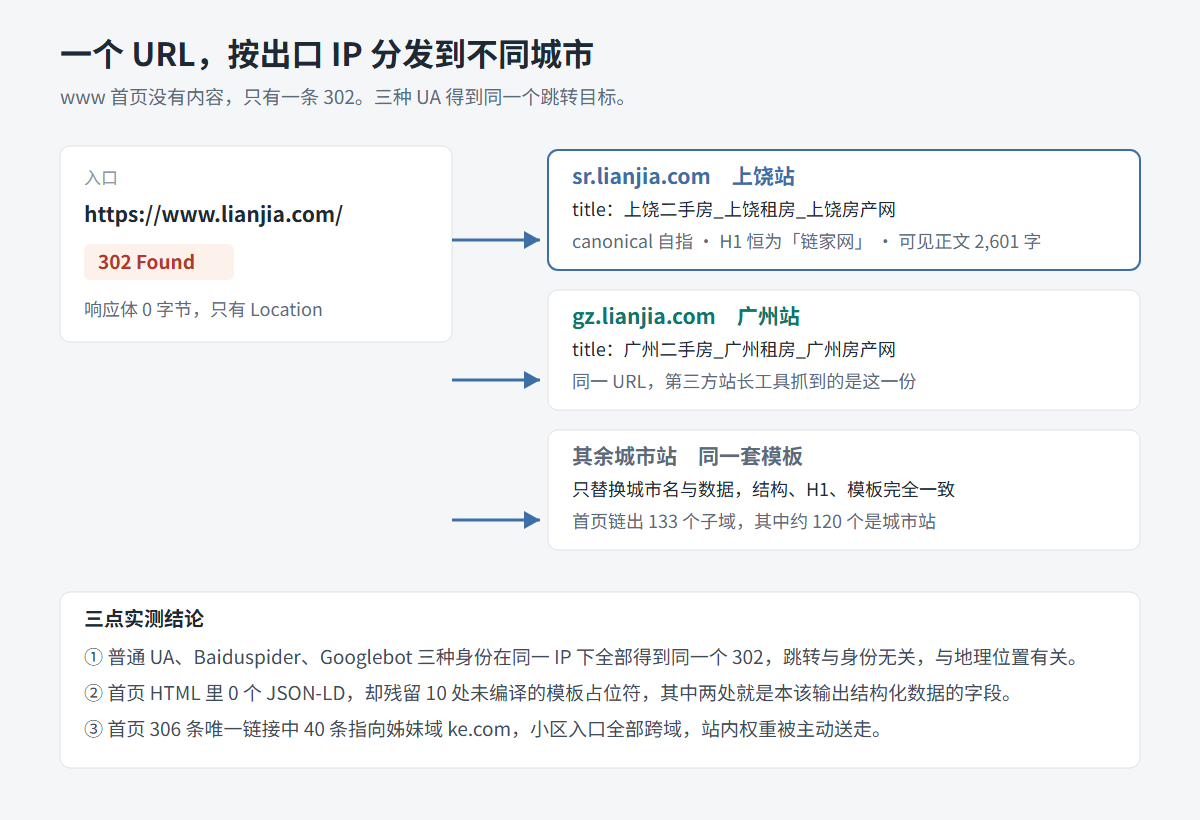
请求 https://www.lianjia.com/,返回 302,Location 指向 sr.lianjia.com。响应体 0 字节,页面上什么内容也没有。
换成 Baiduspider 与 Googlebot 的 UA 各请求一次,结果仍是同一个 302、同一个目标。跳转与身份无关。
我们的出口 IP 被判为上饶,落地页 title 是「上饶二手房_上饶租房_上饶房产网」,canonical 自指这个城市站。
同一个 URL,两个城市两个标题
第三方站长工具抓同一个 URL,页面标题显示的是广州版。同一地址、不同出口,交付不同城市的首页。
按城市切流在国内平台很常见,本身不是问题。问题在于 www 因此没有任何稳定版本可供索引。
首页的 title、description、canonical 全部随 IP 变化,且 canonical 一律自指当前城市站,站内没有一条指向主域的收敛信号。
H1 与结构化数据的缺口
城市首页的 H1 恒为「链家网」,不随城市变化。120 个站共用一个 H1,城市词只落在 title 与 description 里。
首页可见正文 2,601 字,0 个 JSON-LD。但 HTML 里残留 10 处未编译的模板占位符。
其中两处名为 schema 的字段(<%= data.more_schema %> 与 <%= data.list[i].schema %>)本该输出结构化数据,现在被当作纯文本漏在页面里。
也就是说,结构化数据不是没做,是渲染管线在某一层断了。列表页更明显:整页 161 处模板占位符,唯一的 JSON-LD 是组织与站点类型,不是房源列表。
另外,首页 306 条唯一链接里有 40 条指向姊妹域 sr.ke.com,小区入口全部跨域,站内权重被主动送了出去。
两份 robots.txt,两种错法
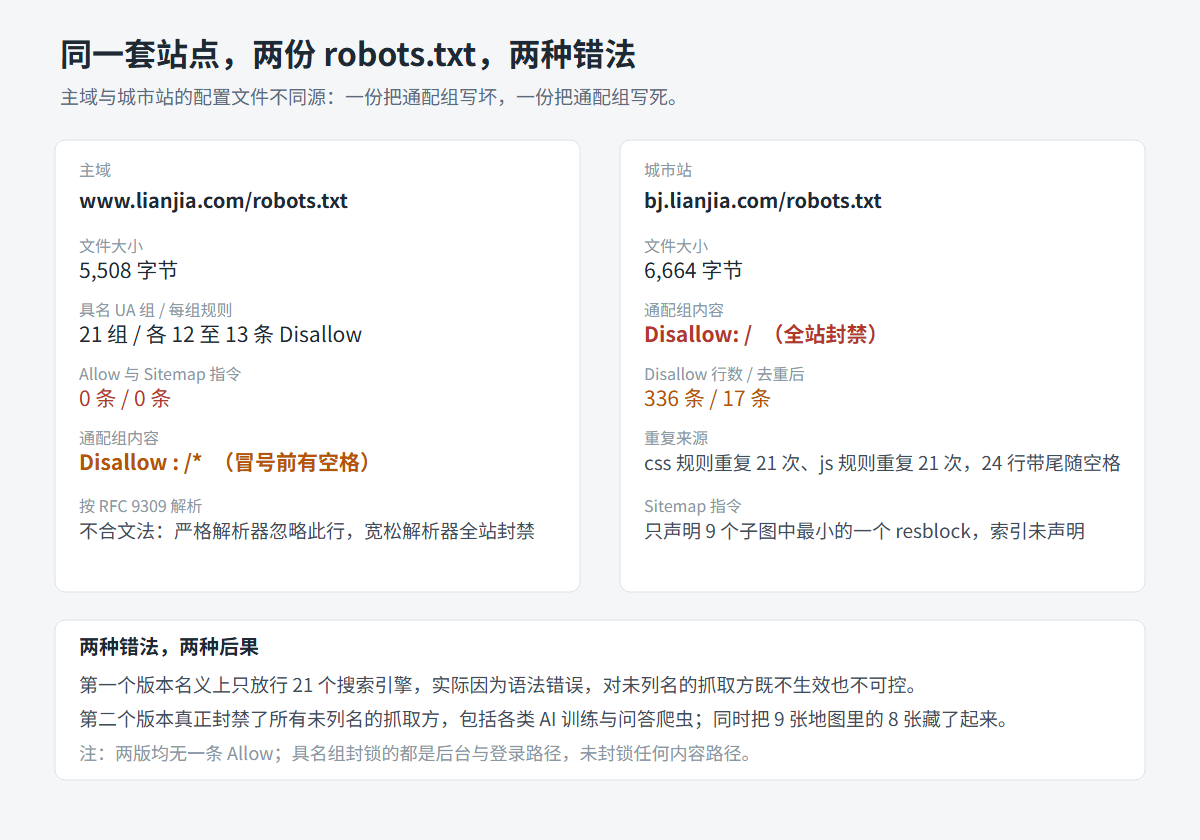
主域 robots 5,508 字节,城市站 6,664 字节。两份文件不是互为镜像,通配组的写法完全不同。
| 项目 | 主域 www | 城市站 bj |
|---|---|---|
| 文件大小 | 5,508 字节 | 6,664 字节 |
| 具名 UA 组 | 21 组,各组 12 至 13 条 | 22 组 |
| 通配组内容 | Disallow : /*(冒号前有空格) | Disallow: / |
| Disallow 行数 | 每家 13 条以内 | 336 条,去重后 17 条 |
| Sitemap 指令 | 0 条 | 1 条,只指向最小的子图 |
21 个具名组只锁后台
具名组覆盖百度、搜狗四个变体、360、必应、谷歌、Yisou、Yahoo 等,每组 12 至 13 条 Disallow。
封锁的全部是 /admin、/agent、/center、/cmsmanage 这类后台与登录路径,内容路径一条没锁,也没有任何一条 Allow。
白名单式配置本身没问题,问题出在名单之外的抓取方怎么处理。
一条写坏,一条写死
主域通配组只有一行「Disallow : /*」,冒号前多了一个空格。RFC 9309 要求字段名后紧跟冒号,不允许中间插入空白。
严格解析器会把这一行当作未知指令丢弃,通配组实际为空;宽松解析器则会理解为全站封禁。两种结果都不是配置者的原意。
城市站那份写的是「Disallow: /」,真的封住了。而 336 条 Disallow 去重后只剩 17 条,css 与 js 规则各重复 21 次,另有 24 行带尾随空格。
后果是不对称的:主域放进了不该放的抓取,城市站挡住了本可以放的抓取。同一套站点,两份文件语义相反。
抓取通路:100 页上限与三次请求的验证码
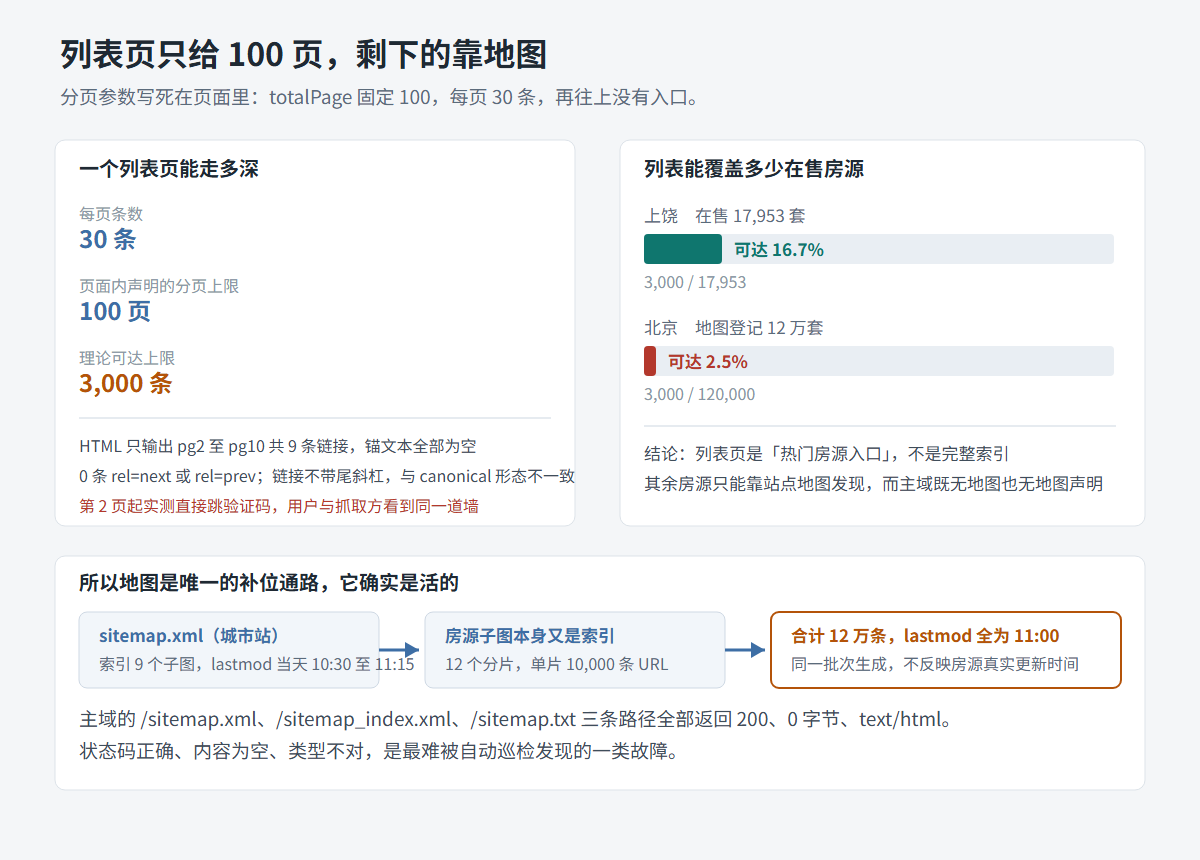
列表页每页 30 条,页面内写死 totalPage 为 100。HTML 只输出 pg2 到 pg10 共 9 条链接,锚文本全部是空字符串。
没有 rel=next,也没有 rel=prev。链接写成 /ershoufang/pg2,不带尾斜杠,而 canonical 用带斜杠形态,每翻一页多一次跳转。
上饶在售 17,953 套,3,000 条上限只覆盖 16.7%。北京地图登记约 12 万条,覆盖率约 2.5%。
列表页于是变成热门房源入口,而不是完整索引。其余房源只能靠站点地图发现。
地图是活的,入口是空的
bj.lianjia.com/sitemap.xml 是 9 个子图的索引,lastmod 停在当天上午 10:30 至 11:15,文件是活的。
房源子图本身又是一个索引,12 个分片、每片 10,000 条 URL,lastmod 全部为同一天 11:00:07。
同一批次生成的时间戳不反映房源真实改动。搜索引擎只能把它读成「全量已变」,每次重抓全部条目。
而主域 /sitemap.xml、/sitemap_index.xml、/sitemap.txt 三条路径全部返回 200、0 字节、text/html。状态码对、内容空、类型错。
主域 robots 一条 Sitemap 指令都没有;城市站只声明了 9 张图里最小的那张 resblock,索引本身没有声明。等于把 12 万分片藏在第三层目录里等人猜。
风控按 IP,不按身份
连续请求第 2 到 3 次起,分页、详情页、甚至不存在的房源 ID,全部 302 到 hip.lianjia.com/captcha。
换成 Baiduspider UA 后升级为 forbidden。三种 UA 表现一致,说明判定依据是出口 IP,不是身份。
所以不能说百度蜘蛛被封。能说的是:同一 IP 连续三四次请求就会撞墙,留给抓取的预算很窄。
合格项也有:iPhone UA 得到 301 永久跳转到 m.lianjia.com,跳转语义正确,是本次测到的少数规范实现。
优化建议:按 P0 到 P2 排
下面八条按「改动成本」与「影响面」排序。P0 是配置层改动,P1 涉及模板,P2 需要跨团队配合。
| 级别 | 建议 | 具体动作 | 为什么先做 |
|---|---|---|---|
| P0 | 修通配组 | 主域把 Disallow : /* 改成合法写法或整组删除,城市站按需保留 | 一行配置决定 120 个站对通用爬虫的开放范围 |
| P0 | 补 Sitemap 声明 | 主域 robots 声明一个总索引,列出各城市站 sitemap.xml | 主域现在是死胡同,地图全挂子域且无声明 |
| P0 | 给主域一个稳定版本 | 停止首页 302,改为 200 的城市选择页,或至少让爬虫 UA 拿到 200 | www 是唯一有品牌外链与品牌词的入口 |
| P1 | 分页可读化 | pg 链接补锚文本与 rel=next 与 rel=prev,URL 统一带尾斜杠 | 空锚文本等于没有链接,深度翻页拿不到权重 |
| P1 | H1 与 canonical | 城市首页 H1 改为城市名加二手房,列表页保留类目词 | 120 个站共用一个 H1,城市意图全部丢失 |
| P1 | 修 JSON-LD | 修复模板渲染,列表页输出集合类型,详情页输出房源与面包屑 | 字段已经写好,只差渲染这一层 |
| P2 | lastmod 真实化 | 用上架、改价、下架时间替代批次生成时间 | 让增量抓取重新有效,减少全量重抓 |
| P2 | 风控分层 | 对已验证的搜索引擎 IP 段放宽阈值,或提供批量取数接口 | 详情页是房源主体,撞墙即等于丢索引 |
外部数据给了另一个侧面。第三方站长工具显示主域百度收录 9 条、PC 词 222 个,北京子域收录 139 万条、PC 词 1,938 个。
北京子域的收录在 11 月 9 日从 1,019 万降到 139 万,一周减少 880 万。收录量属抽样口径,跳变也可能来自分片抽样而非真实掉收,但方向与「地图入口缺失」一致。
这套结构并不罕见:把城市拆成子域,主域退化成跳转层,地图挂在最末端。前期跑得很快,缺的是一层收敛。
同类的矩阵型结构,我们此前在 土巴兔的 272 个城市分站 与 汽车之家的双协议五套模板 上都测过。纯程序化页面的翻页与地图问题,智联招聘那篇 有更细的对照。
登录后可点赞、收藏与反馈。