LocalAI 是什么:OpenAI 接口兼容,先把这个补丁打上
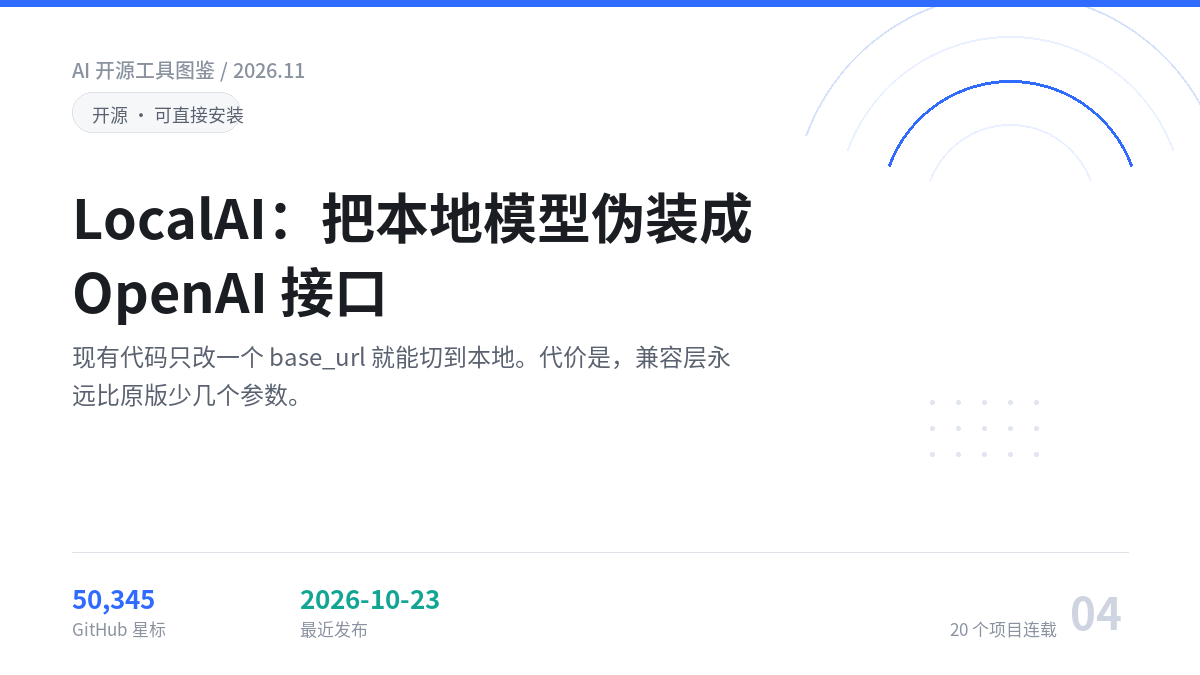
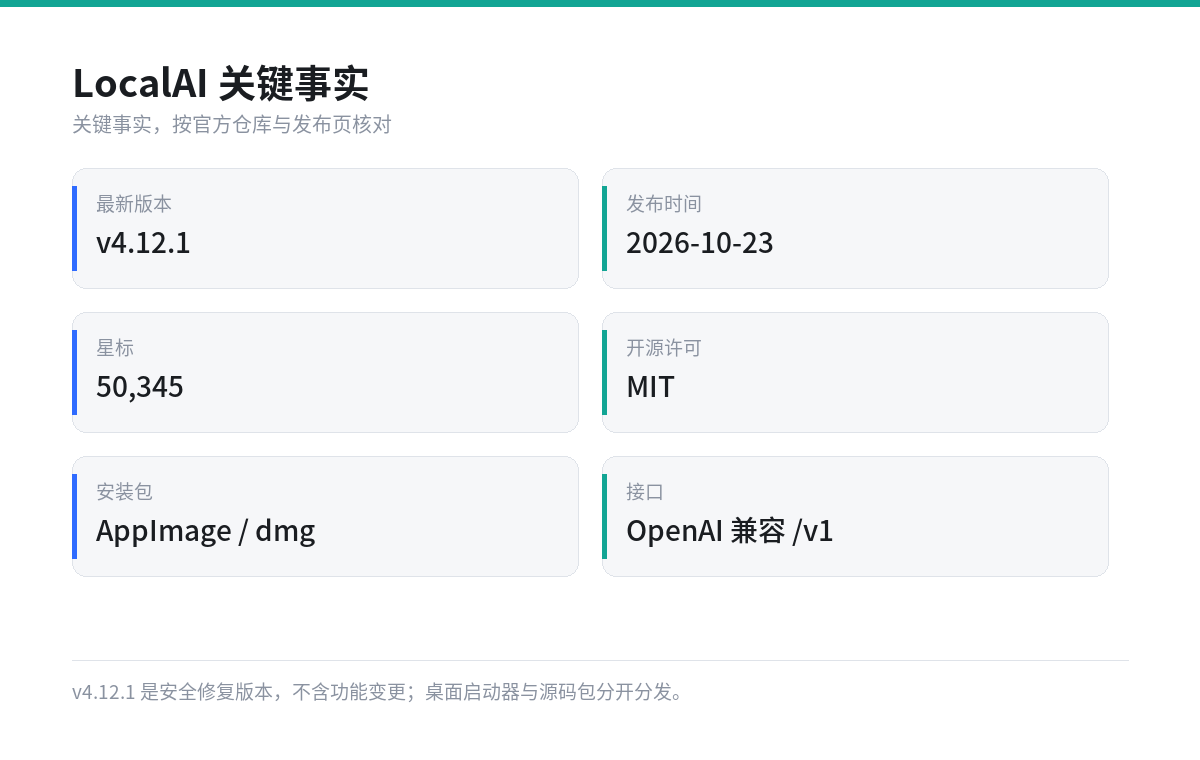
LocalAI 的价值不在界面上,而在接口:它把本地模型包装成 OpenAI 兼容的 /v1 端点,现有代码改个 base_url 就能切过来。10 月 23 日的 v4.12.1 只做了一件事——修一个用户可控 URL 的安全问题。
LocalAI 解决的是一个很具体的问题:手上有一套按 OpenAI 接口写的代码,现在要让它跑在自己的机器上,不想改业务逻辑。
它解决什么问题
它在本机起一个 HTTP 服务,把各类本地模型包装成 OpenAI 风格的 /v1/chat/completions、/v1/embeddings、/v1/images/generations 等端点。客户端只需要把 base_url 从 api.openai.com 改成自己的地址,模型名换成配置里声明的名字,代码基本不用动。
支持的后端不止文本:图像、语音、 Embedding 都能挂。这是它和 Ollama 最大的区别——后者主打文本模型的分发。
适合谁
适合已经在用 OpenAI SDK 的团队:想验证「换成开源模型效果差多少」,用它可以一天内跑完对照实验。
也适合做私有化交付的团队:客户内网不能出公网,但应用是按 OpenAI 接口写的,中间加一层 LocalAI 最省改造量。
不适合追求最新模型的人。新模型的支持通常滞后于 llama.cpp 上游,想第一时间跑新架构,直接用引擎层更快。
最近更新了什么
2026 年 10 月 23 日的 v4.12.1 是一次纯安全修复,改动只有一个方向:收紧用户可控 URL 的校验。
具体做了三件事:重定向目标改成逐跳校验,不再只查第一次请求;100.64.0.0/10 和 0.0.0.0/8 被当作非公网地址处理;实际连接打到已经校验过的那个地址,避免校验与连接之间的时间差被利用。
这类问题的场景是:接口允许传入图片或音频的 URL,攻击者用内网地址探测服务端可达性。跑在内网、且这个端点对外开放的实例,应该尽快升级。
部署方式
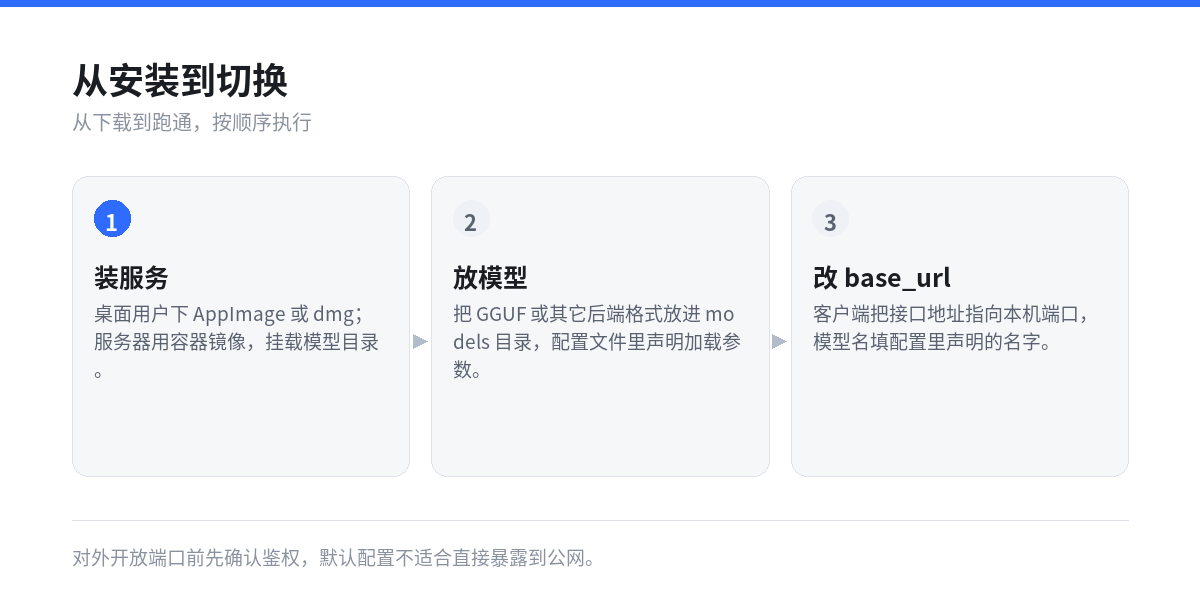
桌面用户下载 LocalAI-Launcher-x86_64.AppImage 或 LocalAI.dmg,启动器会引导下载后端和模型。服务器场景更常见的是容器部署,把模型目录挂进去,配置文件里逐个声明模型。
三个真实边界
参数不是全实现。 logprobs、部分工具调用字段、结构化输出的细节,兼容层未必和官方一致。迁移前先跑一遍自己的调用用例。
模型加载吃内存。 每个模型实例都占独立内存,同时挂三个 14B 模型,32GB 内存的机器会紧张。
默认配置不适合公网。 没有强鉴权时不要把端口暴露出去,这类服务一旦被扫到,会被当作免费推理接口。
常见问题
和 Ollama 的区别? Ollama 偏「模型分发加运行」,LocalAI 偏「接口兼容层」,前者更好装,后者更好接。
能完全替代 OpenAI 吗? 接口层面接近,效果层面取决于你挂的模型,不能默认等价。
支持哪些模型格式? GGUF 是主力,也支持其它后端格式,具体看配置文件里的后端声明。
商用可以吗? 软件是 MIT,模型许可要单独确认。
一句话判断
LocalAI 不是给个人用户玩的,它是给「已经有一套 OpenAI 代码、现在要落地到自有硬件」的团队准备的过渡层。
登录后可点赞、收藏与反馈。