Ollama 是什么:本地部署大模型,先分清服务和客户端
Ollama 装完不会给你聊天窗口,它只在本机起一个模型服务,把 11434 端口开给别的软件用。这篇说清它到底做了什么、适合谁、11 月这版改了什么,以及第一次安装最容易卡住的三个地方。
Ollama 装完不会给你一个聊天窗口。它只做一件事:在本机起一个模型服务,把 11434 端口开出来,让别的软件来调。理解这一点,后面选模型、接前端、排查报错都会顺很多。
Ollama 到底做了什么
它把三样东西打包在一起:模型权重的下载与版本管理、推理运行时、一套 HTTP 接口。执行 ollama run 的时候,它在背后完成下载、加载、起服务三件事,再把一个命令行对话界面接到这个服务上。
所以它更像「本机的模型网关」,不是「AI 软件」。真正的界面要另配:Open WebUI、Cherry Studio、LobeChat 都能直接填 http://127.0.0.1:11434。
适合谁,不适合谁
适合三类人:想把模型跑在断网机器上的、要给内部工具接一个统一模型入口的、以及不想每天折腾编译参数的开发者。
不适合两类人:只想开箱即用聊天的人,去装 Cherry Studio 或 Chatbox 更省事;需要精细控制采样、显存分配、批处理参数的人,应该去看 llama.cpp 或 vLLM。
最近更新了什么
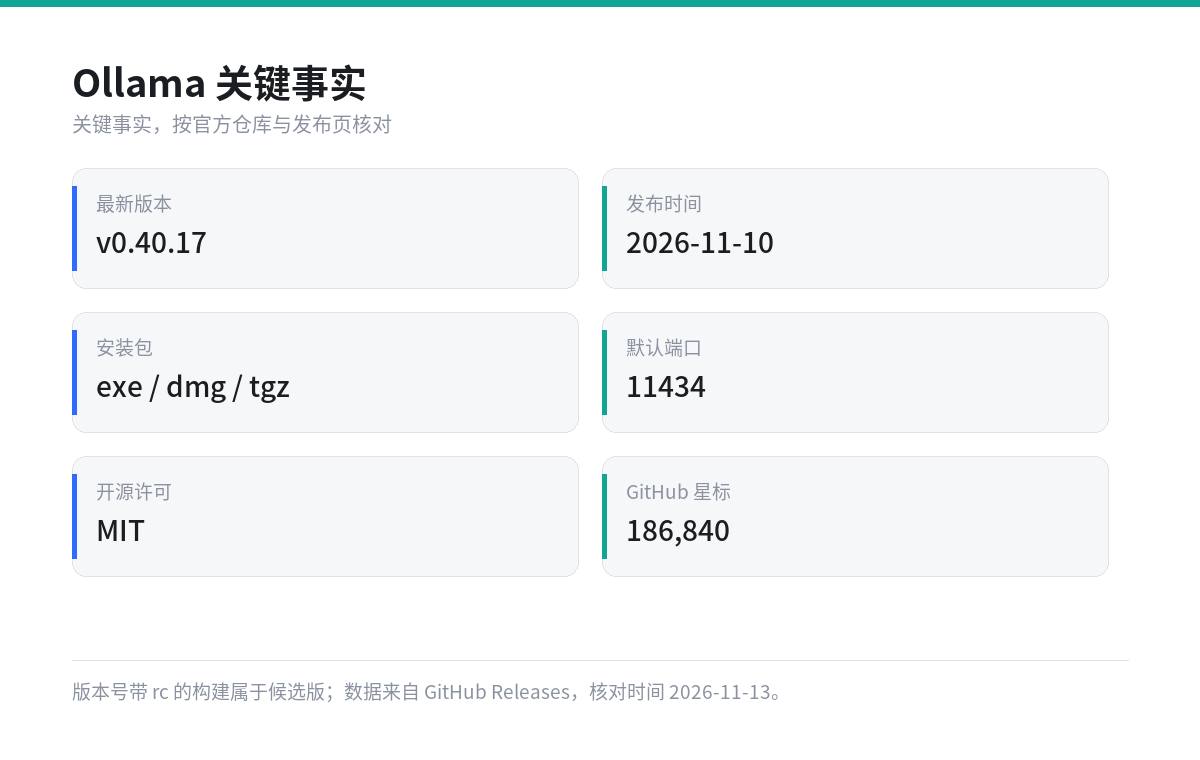
2026 年 11 月 10 日的 v0.40.17 是候选版,改动集中在三处:
- MLX 后端支持并发生成,Apple Silicon 上多个请求不再互相排队;
- Vulkan 后端对核显改用 mmap,集成显卡的显存占用更可控;
- 内置 llama.cpp 升到 b12257,同步了上游的模型支持。
候选版适合尝鲜,生产环境建议等正式版落地。
三步跑通
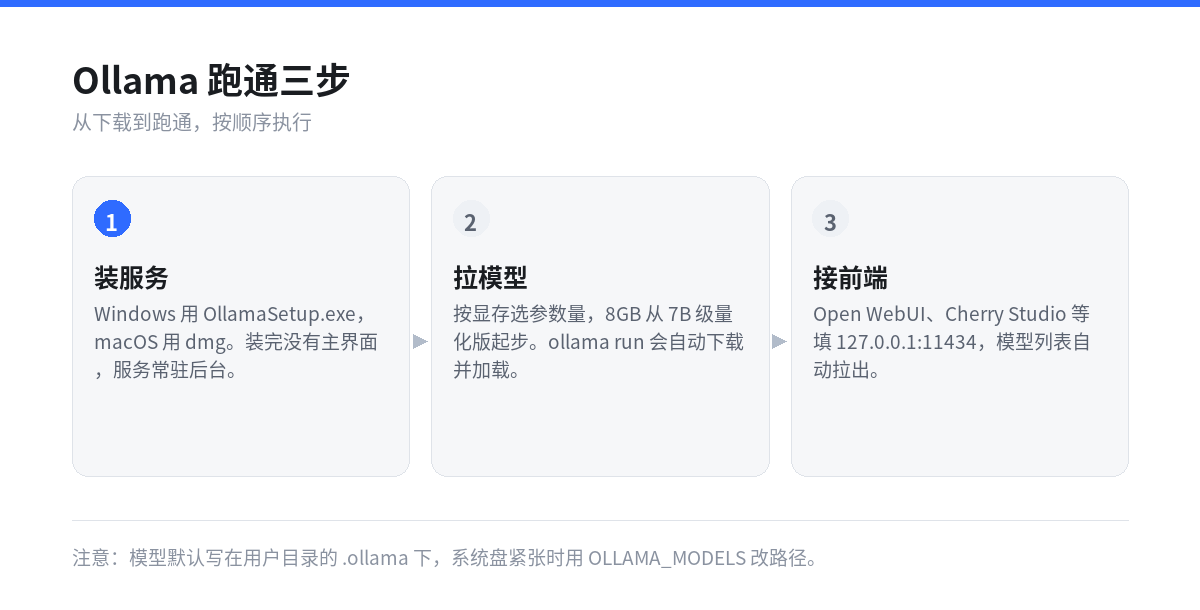
第一步,Windows 下载 OllamaSetup.exe,macOS 下载 Ollama.dmg,Linux 用安装脚本。装完托盘或服务列表里能看到它在跑。
第二步,按显存选模型。8GB 显存从 7B 到 9B 的量化版起步,16GB 可以上 14B 级,24GB 再考虑 32B。参数量不是越大越好,长上下文会额外吃显存。关于显存和模型体积的关系,可以对照《DeepSeek 本地部署要多少显存》里的测算方法。
第三步,接前端。以 Open WebUI 为例,把 API 地址填成 http://127.0.0.1:11434,模型列表会自动拉出来。
三个容易卡住的地方
模型存在哪。 默认在用户目录下的 .ollama/models,Windows 是 C:\Users\你的用户名\.ollama。系统盘紧张就用环境变量 OLLAMA_MODELS 指到别的盘,改完要重启服务。
下载慢。 官方源在海外,国内拉取经常中断。可以配镜像,但镜像的模型清单往往滞后,版本对不上就会报错。
端口被占。 11434 被别的程序占用时服务起不来。改 OLLAMA_HOST 换端口,同时记得改前端的地址。
常见问题
Ollama 怎么读? 读作「奥拉马」,重音在第二音节。它不是缩写,官方也没有给中文名。
有安卓版吗? 没有官方安卓客户端。手机上要用,只能在电脑上跑服务,手机通过局域网 IP 访问前端页面。
Ollama 和 LM Studio 有什么区别? 前者是服务加分发,偏工程;后者是桌面应用,偏体验。两者都能跑 GGUF 格式。
能商用吗? 软件本身是 MIT 许可,可以商用。但模型权重是另一套许可,商用前要单独看模型条款,区别见《DeepSeek 开源许可能商用吗》。
一句话判断
如果目标是「让本机其它软件都能用上大模型」,Ollama 是最短路径;如果目标是「打开就能聊」,它不是终点,只是底座。
登录后可点赞、收藏与反馈。