10GB 显存跑不动 27B?Loop-9B 部署避坑实录:vLLM 直装必报错,这条路线最稳
全网教程默认你有一张 24GB 卡,可商汤 Loop-9B 正式版 4bit 权重只要 4.9GB,10GB 显存就有机会跑出「27B 级」能力。但 vLLM、SGLang 的支持都还是未合并 PR,照抄必报错。三条路线怎么选、加载 OOM 怎么救,一篇讲清。
全网讲本地部署的教程,几乎都在默认你有一张 24GB 显存的卡:拉个 Qwen3.8-27B 的 Q4 量化版,16GB 起步,vLLM 一条命令 serve 完事。可你要是只有一张 10GB 级的老卡,或者 12GB 显存还想给系统留点余量,照抄这类教程,第一步就在显存检查上被劝退。
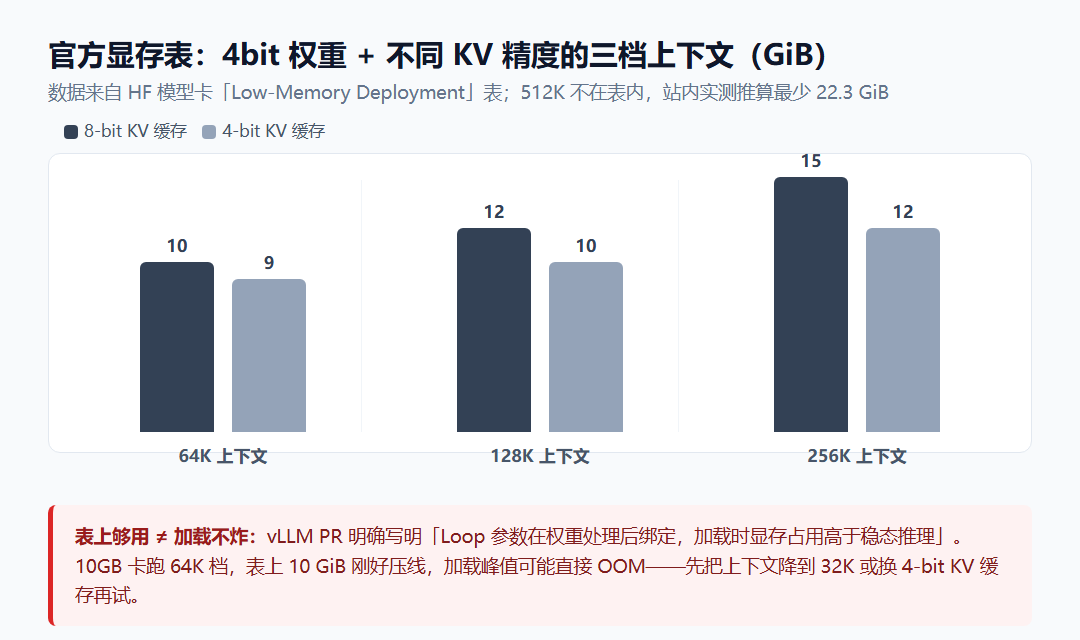
商汤 11 月 17 日开放的 SenseNova Loop-9B 正式版,就是给这类用户准备的:约 9B 参数、官方 AWQ 4bit 权重只有约 4.9GB,模型卡上的显存表写着 64K 上下文最低 9 GiB(4-bit KV 缓存)——10GB 显存确实有得谈。官方评测还称它在部分智能体和数据任务上比肩 Qwen3.8-27B(AIDABench 65.31 对 65.01)。
但坑也在这里:官方给的 vLLM 和 SGLang 支持,截至 11 月 19 日都还是没合并的 PR。你按主流教程 pip install vllm 再 serve,直接报「不认识这个模型」;SGLang 那边 CI 还是红的。这篇文章把三条路线的现状、限制和翻车点一次说清,全部信息在 11 月 19 日逐条核实过。
为什么 10GB 显存敢叫板 27B?先把 Loop-9B 的三个数拆明白
Loop-9B 的核心思路是「参数省着存,计算往深跑」:32 个物理解码层里,第 4–27 层共享同一份权重、一次前向跑两遍,于是 32 层完成 56 次层计算,官方称推理等效约 14.6B 参数。注意力也是混着来的:每 4 层一组,3 层线性注意力加 1 层全注意力,线性注意力的状态不随上下文增长,长文本的 KV 开销因此被压下来。
但选型时必须把三个数分开看:权重按 9B 存、算力按 56 层付、KV 按 14 份算。「层数 × 每层开销」这类通用显存公式在这个模型上必然算错——512K 上下文最少要 22.3 GiB,官方那张表最小一档只到 256K。显存数学的完整推导,站内这篇《32 层权重跑 56 次计算:512K 上下文要多少显存》已经拆过,这里不重复。
| 对比项 | 主流路线(Qwen3.8-27B Q4) | Loop-9B 正式版 |
|---|---|---|
| 权重体积 | 约 16–17 GB | AWQ 4bit 约 4.9 GB |
| 起步显存 | 24GB 卡(短上下文) | 官方表 64K 档 9–10 GiB |
| 预填计算量 | 1 倍 | 1.75 倍(56/32 层),出字速度别按 9B 期待 |
| 推理引擎 | vLLM/SGLang 正式版直接支持 | 两家的支持都还是未合并 PR |
| 许可 | Apache-2.0 | Apache-2.0(HF 需先接受条款再下载) |
三条部署路线怎么选:官方给三套说明,能用的只有一套半
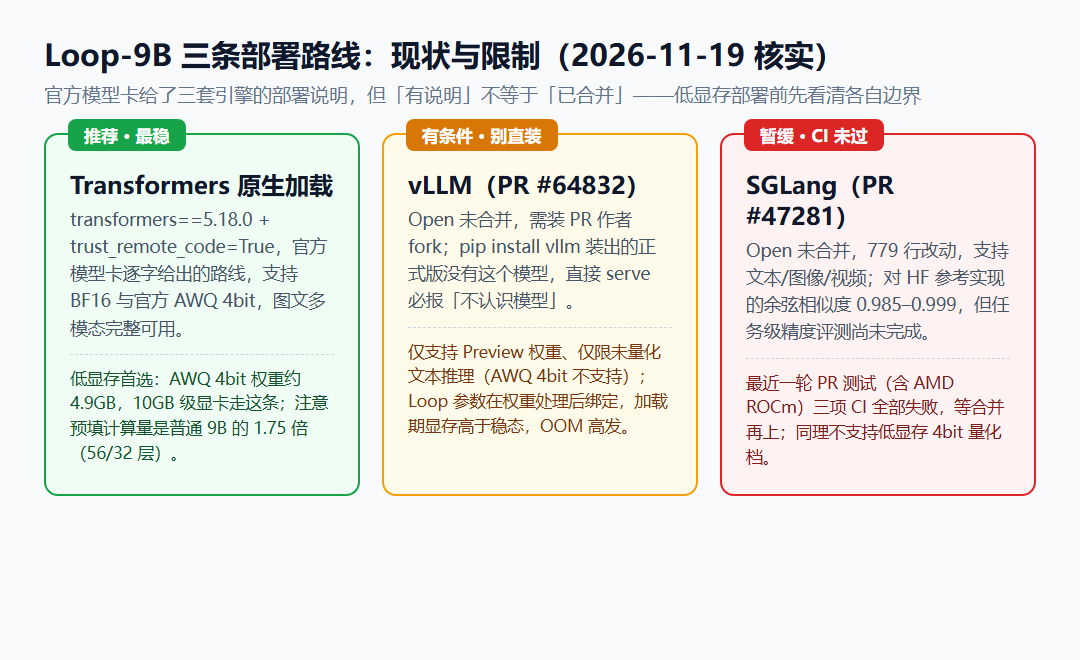
模型卡同时给了 Transformers、vLLM、SGLang 的部署说明,但「有说明」不等于「已进主线」。逐条拆现状:
- Transformers 原生加载(推荐):官方逐字给出的路线,核对环境是 transformers 5.18.0 + PyTorch 2.11.0 + CUDA 13.0。支持 BF16 和官方 AWQ 4bit,图文多模态完整可用,低显存就走这条。
- vLLM(PR #64832,未合并):我直接翻了 PR 页面——目前是 Open 状态,支持范围写得非常死:仅 Preview 权重、仅限未量化文本推理(AWQ 4bit 不支持),sharded_state 导出还会被直接拒绝。正式版权重 + 低显存量化这条最想要的路,vLLM 上暂时走不通。
- SGLang(PR #47281,未合并):779 行改动,支持文本/图像/视频,与 HF 参考实现的余弦相似度 0.985–0.999,但任务级精度评测未完成,最近一轮 PR 测试三项 CI 全部失败(含 AMD ROCm)。等合并再上。
一句话结论:低显存 + 量化这条路线,眼下只有 Transformers 原生加载一条是完整的。vLLM/SGLang 适合等合并后跑大显存、高并发的场景。
最稳路线实操:Transformers + AWQ 4bit,从下载到出字
第一步:HF 下载先「解锁」,不然 401
这个仓库是 gated 的:先登录 Hugging Face、进模型页接受使用条款,再下载。跳过这一步直接 clone,报的就是 401/403,很多人卡在这里以为是自己网络问题。国内网络不稳可以把 HF_ENDPOINT 指到镜像站:
# bash / PowerShell 通用
pip install "transformers==5.18.0" accelerate safetensors
export HF_ENDPOINT=https://hf-mirror.com   # Windows 用 $env:HF_ENDPOINT="https://hf-mirror.com"
# 登录(先在网页上接受仓库条款)
huggingface-cli login
第二步:加载与对话,注意三个必填项
模型卡示例的核心是 trust_remote_code=True——这是自定义架构模型,不传这个参数直接 KeyError。另外示例默认开着思考模式(enable_thinking=True)、贪婪解码、最多生成 512 个新 token,想要直接答案就显式关掉:
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "sensenova/SenseNova-Loop-9B"  # AWQ 4bit 版在官方 collection 里另选
model = AutoModelForCausalLM.from_pretrained(
    model_id, torch_dtype="bfloat16",
    device_map="auto", trust_remote_code=True,
)
tok = AutoTokenizer.from_pretrained(model_id, trust_remote_code=True)

messages = [{"role": "user", "content": "用三句话解释什么是 KV 缓存"}]
text = tok.apply_chat_template(messages, tokenize=False, add_generation_prompt=True,
                              enable_thinking=False)  # 关掉思考,回答更快
inputs = tok(text, return_tensors="pt").to(model.device)
out = model.generate(**inputs, max_new_tokens=512)
print(tok.decode(out[0][inputs.input_ids.shape[1]:], skip_special_tokens=True))两个使用体感提前打好预防针:一是它不快——中间 24 层要跑两遍,prefill 计算量是普通 9B 的 1.75 倍,换来的是「小盘子里的深度」;二是思考模式默认开着,长串思考后才出答案,简单任务记得关。
为什么显存表写着够用、加载却 OOM?vLLM PR 里的隐藏警告
这是 Loop-9B 最阴人的一个坑。vLLM 那个 PR 的描述里藏着一行关键信息:「Loop 参数在权重处理后绑定,加载时的显存占用高于稳态推理」。也就是说,官方显存表给的是推理稳态,权重刚加载、还没做参数绑定的那一刻,占用更高。
10GB 卡跑 64K 档,表上 10 GiB 正好压线——加载峰值一来就炸。解法按优先级排:把上下文从 64K 降到 32K、KV 缓存从 8-bit 换 4-bit(64K 档从 10 降到 9 GiB)、或者干脆关掉后台占显存的浏览器。如果走 vLLM fork 路线,加载用的显存还要再留出权重绑定那份余量。
常见翻车报错与急救清单
| 报错/现象 | 根因 | 解法 |
|---|---|---|
| vllm serve 报「model not found / 不支持」 | vLLM 正式版没有 Loop-9B,支持在未合并的 PR #64832 里 | 换 Transformers 原生路线;确要 vLLM 就装 PR 作者 fork,并接受「仅 Preview、仅未量化文本」的限制 |
| 下载报 401/403 | HF gated 仓库,未接受使用条款 | 网页登录 → 模型页点同意 → 重新 login |
| 加载报 KeyError / 未知架构 | 漏了 trust_remote_code=True | model 和 tokenizer 两处都要传 |
| 表上显存够、加载时 OOM | Loop 参数绑定前加载峰值高于稳态 | 上下文降到 32K、KV 换 4-bit、关掉占显存的后台程序 |
| vLLM 保存/重载报 Missing keys | sharded_state 导出对共享权重去重,重载时别名丢失(PR 已知问题) | 别用 sharded_state/runai_streamer_sharded 导出,走原生 checkpoint |
| 「比肩 27B」但自己跑着不行 | 官方评测是厂商口径,且能力边界明写在智能体/代码/数据分析 | 用自己的任务复测再决定替换;仓库级长程编程官方自己都说比 27B 差一截(NL2Repo 41.36 对 44.60) |
什么人该上,什么人该劝退
适合:10–12GB 显存想跑「有深度的小模型」的个人用户;数据不出本机的私有化实验;Agent、代码补全、数据分析这类官方明示的强项场景。顺带一提,寒武纪、沐曦都在发布首日完成 Day 0 适配,非 NVIDIA 卡也走得通。
劝退:想要 9B 级出字速度的(它要多付 1.75 倍预填算力);指望 vLLM/SGLang 正式版一键部署的(等 PR 合并);主要做仓库级长程编程的(这项官方分数明确落后 27B);还有——它支持复杂网页生成但官方承认 3D/动画内容要多轮打磨,别拿它当前端生成主力。
另外必须交代一句:本文所有性能数字都来自商汤官方评测,第三方复现尚未出现,具体到你机器上的表现,以自己的任务实测为准。
总结:Loop-9B 正式版给低显存用户开了一条「4bit 权重 4.9GB、64K 上下文 9–10 GiB」的路线,但它踩不进 vLLM/SGLang 的成熟生态,眼下唯一完整能走的是 Transformers 原生加载——记住 gated 下载先解锁、trust_remote_code 必传、加载显存峰值高于稳态这三条,基本就能一次跑通。
你手上是什么卡?打算跑哪条路线、卡在哪一步报错?评论区报一下配置和报错信息,我按 PR 里的已知问题逐条帮你对。
登录后可点赞、收藏与反馈。


