32 层权重跑 56 次计算:512K 上下文要多少显存
商汤 Loop-9B 的 32 个解码层跑成 56 次层计算,KV 却只存 14 份。三个数互不相等,通用显存公式在这类混合注意力模型上会失准。按官方六格反推,512K 上下文最少 22.3 GiB,8G 卡连 64K 都进不去。
SenseNova-Loop-9B 的 32 个解码层,跑起来是 56 次层计算,KV 却只按 14 份存。三个数字互不相等,「层数 × 每层开销」这种算法在这类模型上必然失准。512K 上下文最少要 22.3 GiB,而官方那张显存表,最小一档写的是 64K 的 10 GiB。
这篇只拆一个模型:为什么它的长上下文比同尺寸模型便宜,以及那个 22.3 GiB 是怎么一步步算出来的。
三个层数,不是同一个数
普通模型里,「多少层」是一个数。到了 Loop-9B 这里变成了三个。
权重按 32 层存。 独立解码层 32 个,参数量约 9B,推理等效 14.6B。省下的 38% 来自参数复用,不是来自模型变小。
算力按 56 层付。 第 0–3 层正常跑,第 4–27 层这一整块跑两遍(输出接回输入,即 B(B(h))),第 28–31 层正常跑,合计 56 次层计算。prefill 的计算量是 56/32 = 1.75 倍。所以别指望它有 9B 的速度。
KV 按 14 份算。 这个数字既不是 32 也不是 56,下面单独拆。
模型选型时把这三个数混成一个,是这类模型最容易算错的地方。站内那篇 7B 到 1T 的显存对照表给的是通用公式,成立的前提是「每层都做全注意力、层数等于份数」。混合注意力和循环层恰好把这个前提打破了。
先看官方给的东西。README 的「Low-Memory Deployment」只有三行:64K、128K、256K,8-bit KV 那列是 10 / 12 / 15 GiB,4-bit KV 那列是 9 / 10 / 12 GiB,权重按 AWQ 4-bit 约 4.9 GB 计。
512K 是训练时把上下文扩到的长度,不是这张表的覆盖范围。表里没有 512K 那一行,也没有 8 GB 那一列。这不叫虚标,宣传语确实没写「512K 只要 10 GB」;但按 512K 做预算的人,会在这张表上找不到自己要的数字。
14 份是怎么数出来的
KV 缓存随 token 数线性增长,但增长系数取决于「有几层在做全注意力」。
这个模型的注意力是混着的:每 4 层一组,前 3 层线性注意力,第 4 层全注意力。线性注意力的状态大小固定,不随上下文增长;只有全注意力层的 K/V 会一个 token 一个 token 地堆。32 层、8 组,真正产生 K/V 的只有 8 层。
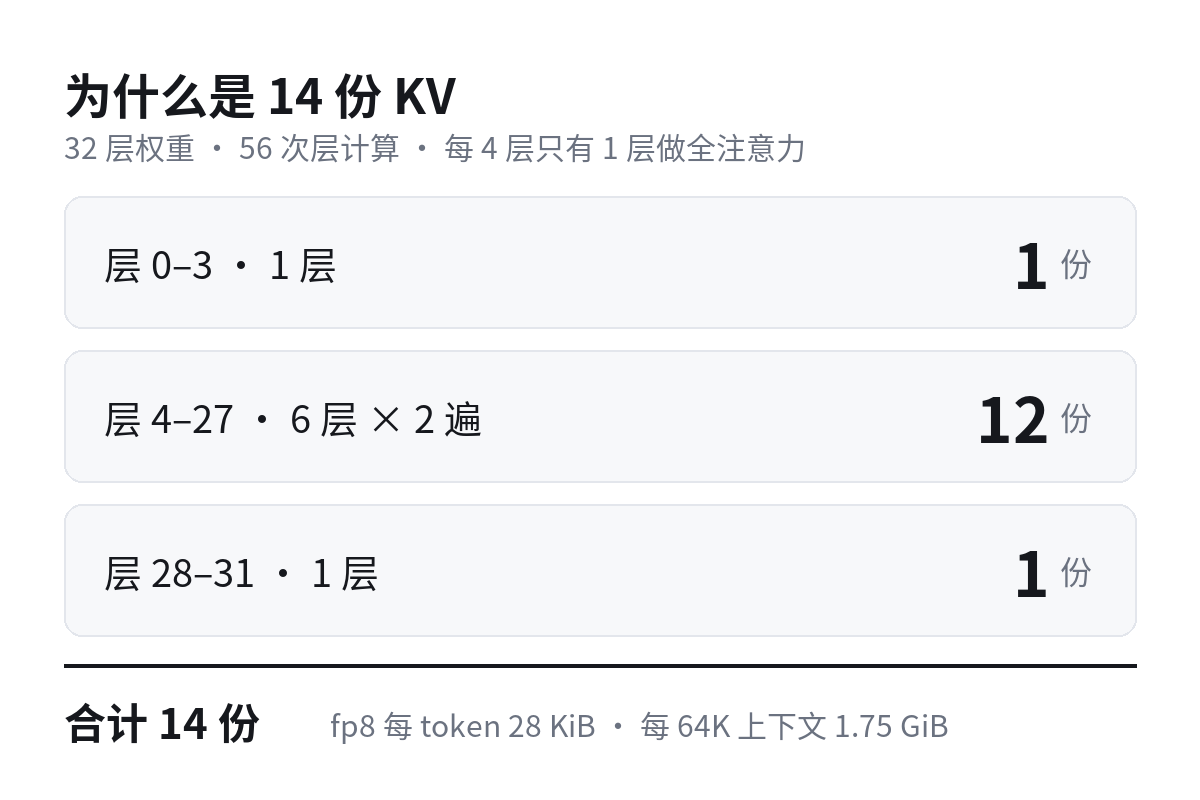
循环块又把这 8 层里的一部分翻了一倍。第 4–27 层是 24 层、6 组,块内 6 个全注意力层要跑两遍,两遍的输入不同,算出的 K/V 也不同,必须各存一份:
- 第 0–3 层:1 个全注意力层,1 份
- 第 4–27 层:6 个全注意力层,跑两遍,12 份
- 第 28–31 层:1 个全注意力层,1 份
合计 14 份。这不是推测,vLLM 那个支持 PR 的说明里写得很直白——「separate attention/recurrent state for each loop visit」,每次循环访问单独存状态。
每份的大小由 4 个 KV 头、每头 256 维决定,K 和 V 各一份:
14 × 2 × 4 × 256 = 28,672 个元素
fp8 一字节,就是每 token 28 KiB;fp16 翻倍到 56 KiB。乘上去,每 64K 上下文占 1.75 GiB。
拿这个数去套官方那六格:64K 8-bit 算得 10.00(官方 10)、128K 算得 11.75(官方 12)、256K 算得 15.25(官方 15),4-bit 那一列同样吻合,最大偏差 0.25 GiB。说明 14 份这个数是对的,官方表里的 KV 就是按它算的。
由此能得出两个判断。
混合注意力省了 4 倍。 如果 56 次层计算全部做全注意力,就是 56 份而不是 14 份,512K 的 KV 账单会从 14 GiB 变成 56 GiB。这不是优化项,是这个模型能谈长上下文的前提。
循环省权重,但不省 KV。 32 套权重跑 56 次计算,权重省了 38%;可 KV 份数和真正的 56 层模型一样是 14 份。换句话说,这个架构用「重复计算」换「参数量」,但换掉的那部分算力,在长上下文场景下会以 KV 缓存的形式还回来一部分。
512K 要多少显存
把权重、固定开销、KV 三笔加起来。固定开销按 3.7 GiB 估(从官方 64K 那一格反解出来的,含框架、激活和显存碎片),换引擎会变,量级差不多。
| 权重与 KV 精度 | 512K 总显存 |
|---|---|
| 4-bit 权重 + int4 KV | 15.2 GiB |
| 4-bit 权重 + fp8 KV | 22.3 GiB |
| 4-bit 权重 + fp16 KV | 36.2 GiB |
| bf16 权重 + fp8 KV | 34.4 GiB |
| bf16 权重 + fp16 KV | 48.5 GiB |
22.3 GiB 是最省的那一档,前提是 4-bit 权重和 fp8 KV 两件都成立。这也解释了官方表为什么停在 256K:15 GiB 是「单卡能装」的心理线,再往上就进入 24 GB 卡的区间了。
换算成卡:12 GB 大约能开 107K,16 GB 约 243K,24 GB 刚好够到 512K,但要 bf16 加 512K 就得上 48 GB。24 GB 换 bf16 只剩 69K——同一张卡,权重精度换一档,上下文掉七倍。
8 GB 卡做本地部署可以直接排除。4-bit 权重 4.6 GiB 加固定开销 3.7 GiB 是 8.3 GiB,而 8 GB 卡实际可用约 7.5 GiB,连一个 token 都放不下。把开销压到极限(batch 设 1、关掉 CUDA graph,按 1.5 GiB 算),大概能挤到 50K,仍然够不到官方表的起点。
记一个常数就够用:每 64K 上下文约 1.75 GiB。想开 128K 就加 3.5,想开 512K 就加 14,再叠权重和开销。
想自己换参数验一遍,这段可以直接跑:
LAYERS, GROUP = 32, 4              # 32 层,每 4 层一组
LOOP = range(4, 28)                # 循环块 4–27
KV_HEADS, HEAD_DIM = 4, 256
BYTES = {"fp16": 2, "fp8": 1, "int4": 0.5}

# 只有每组第 4 层做全注意力;循环块里的层跑两遍,各存一份
sets = sum(2 if i in LOOP else 1
           for i in range(LAYERS) if i % GROUP == 3)
per_token = sets * 2 * KV_HEADS * HEAD_DIM

def vram(ctx_k, kv="fp8", weights=4.9, overhead=3.69):
    kv_gib = ctx_k * 1024 * per_token * BYTES[kv] / 1024**3
    return weights * 1e9 / 1024**3 + overhead + kv_gib

print(sets, per_token)             # 14 28672
print(round(vram(512), 1))         # 22.3
GROUP 换成注意力分组大小(4 表示每 4 层里有 1 层全注意力),LOOP 留空就是普通模型。换模型时只要这两个参数对了,份数就不会数错。
算准了也装不上
显存算对只是第一关。按官方文档原样操作,还会撞上三件事,外加一个名字上的坑。
引擎还没进主干。 vLLM 的支持在 PR #64832(3 个提交,目标是 main),SGLang 在 PR #47281,都还没合并。pip install vllm 装的最新版不认这个架构,得自己 fetch 分支编译。
官方 README 的部署示例全是 4 卡 bf16——LightLLM 用 --tp 4,vLLM 用 --tensor-parallel-size 4。「10 GB 单卡」只出现在显存估算表里,没有对应命令。
量化那条路暂时走不通。 那个 PR 自己写着「Support is limited to unquantized text inference」:首发的 AWQ 4-bit 权重用不了,图片输入也用不了。
PR 的验证只做到 Preview 权重、H100、bf16(GSM8K 238/256)。README 对正式版的措辞是「engine versions and configurations will be updated with the model」,等于引擎侧还在跟进。开源模型从放出权重到能稳定服务,中间就隔着引擎和量化这两步。
这一条直接决定你按 22.3 GiB 还是 34.4 GiB 准备机器,也是成本控制里最容易被跳过的一步。
仓库要申请。 匿名拉 sensenova/SenseNova-Loop-9B 的 config 会直接返回「Access to model is restricted and you are not in the authorized list」,要登录并走一遍授权。
from_pretrained 不带 token 就是 401,不是 404,这个错容易被当成路径写错。许可证本身是 Apache-2.0,不限制商用。许可证给的是权利,仓库给的是文件,这两件事得分开确认。
还有一个小坑:这个名字有三种写法。README 标题是 SenseNova-Loop-9B,HF 仓库带 -Preview 后缀,vLLM 示例里 --served-model-name sensenova_loop。
客户端 model 字段填错返回的是 400 而不是 404,排查时容易误判成服务没起来。这类「同一个模型三种写法」的问题在模型下线迁移那篇里也踩过。
准备机器前先定三件事。
- 上下文到底要多少。512K 是「最长支持」,不是「日常使用」。文档问答、代码库阅读这类活,32K 到 128K 基本够,落在 12–16 GB 卡的区间。上下文长到多少开始失忆是另一个问题,这里有一组实测。
- 权重用不用 4-bit。省 12 GiB,代价是要等引擎支持量化。
- 引擎支持到哪一步。主干没合之前,「能跑」的真实含义是「能编译自己的分支」。
至于权重本身值不值这个价,这篇算过权重账,思路可以直接搬。512K 是训练出来的能力,22.3 GiB 才是它的标价。
登录后可点赞、收藏与反馈。