27B 本地模型写代码:不开思考,一个 LoRA 省 4.5 倍 Token 还不丢分
Hugging Face 开源 Qwen3.8-27B-pi-adapted 适配器:关掉思考模式把 SWE-bench Pro hard-51 从 39.2% 拉到 64.7%,追平基座最高推理档,Token 消耗约降 4.5 倍。本文给出三条接入路径、四个官方边界和适用判断。
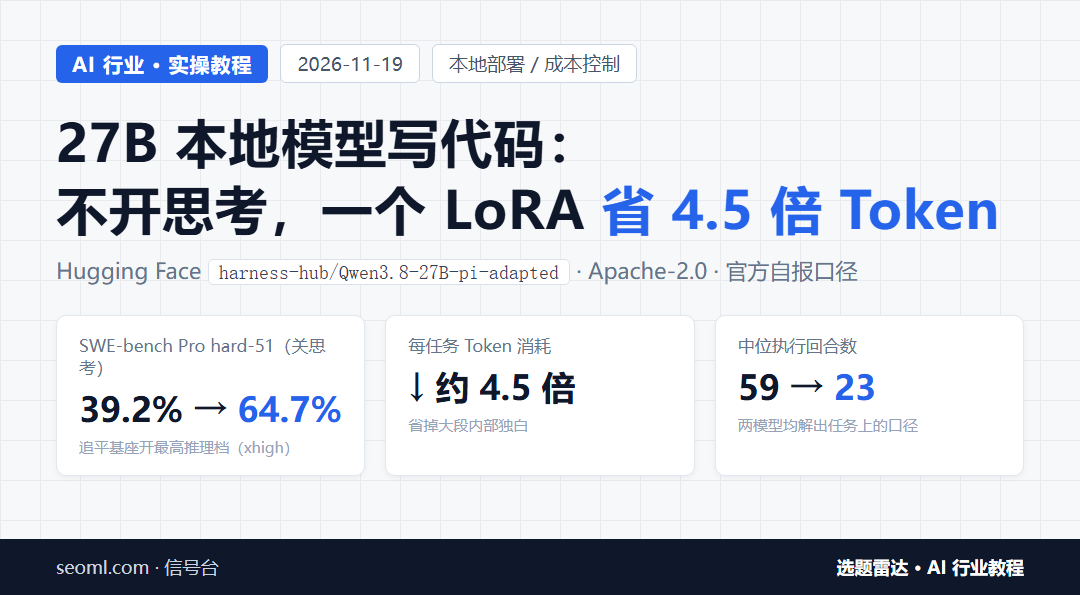
11 月 18 日,Hugging Face 的 harness-hub 团队开源了 harness-hub/Qwen3.8-27B-pi-adapted(Apache-2.0,rank-32 LoRA 适配器)。在关掉思考模式的前提下,它把 Qwen3.8-27B 在 SWE-bench Pro hard-51 子集上的 pass@1 从 39.2% 拉到 64.7%——追平了基座模型开最高推理档(xhigh)的分数,而每个任务的 Token 消耗平均只有原来的约 1/4.5。
对在本地用 vLLM 或 llama.cpp 跑编程代理的中小团队来说,这是把「等半天、烧显存」的思考成本砍掉的一条现实路径。不过所有数字都是官方自报口径,评测集也偏小,先看完账再决定要不要跟。
先看账:思考 Token 是本地编程代理最大的隐性开销
跑过本地编程代理的人都有体感:开高强度深度思考,模型每次动手前先吐几千个思考 Token。在本地显卡上,这些内部独白既是等待时间,也挤占上下文窗口;关掉思考直接出动作,模型又容易在复杂仓库里写偏。
Hugging Face 的做法是把这笔运行时开销提前转成离线训练:用 AsyncGRPO(TRL 实现)把模型放进 pi 编程代理的真实命令行环境里做强化学习,训练时思考模式直接关闭。模型没法靠长篇自言自语试探下一步,只能把工具调用习惯、读文件顺序和修 Bug 的决策直觉压进 LoRA 权重。
数字与口径
| 项目 | 基座 | 加适配器 | 口径说明 |
|---|---|---|---|
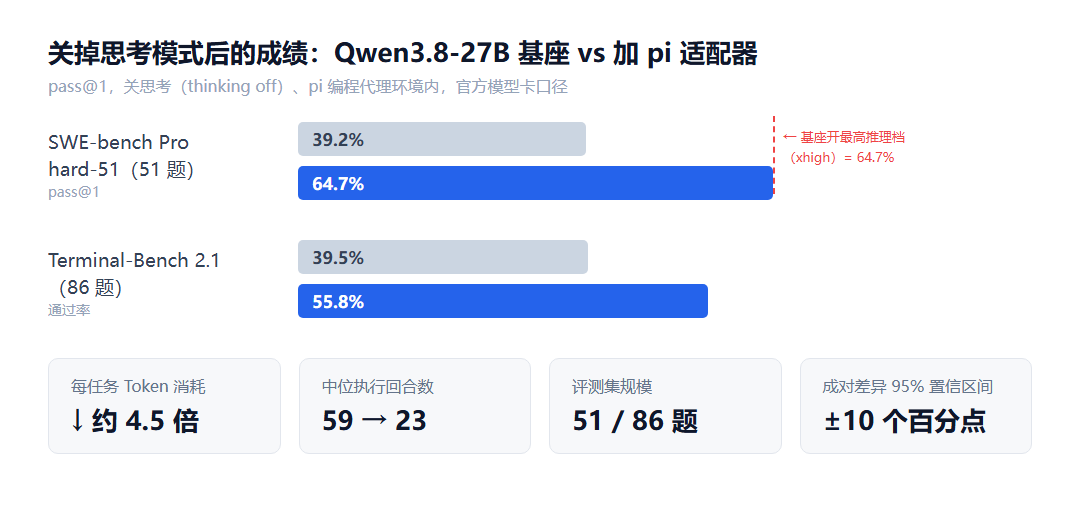
| SWE-bench Pro hard-51 pass@1 | 39.2% | 64.7% | 关思考,pi 环境内;基座开最高推理档为 64.7% |
| Terminal-Bench 2.1 通过率 | 39.5% | 55.8% | 86 题,关思考 |
| 每任务 Token 消耗 | 1× | 约 1/4.5 | 省掉大段内部独白 |
| 中位执行回合数 | 59 | 23 | 两模型均解出的任务上统计 |
看这张表要注意三件事:第一,加适配器并没有超过基座开思考的上限,它的价值是用约 1/4.5 的 Token 打平最高推理档;第二,评测集只有 51 题和 86 题,单次采样下成对差异的 95% 置信区间宽达正负 10 个百分点,实际项目里的体感波动会比榜单数字明显;第三,中位回合数从 59 降到 23 意味着单任务等待时间同步缩短,这对交互式开发比 Token 省钱更直接。
训练怎么做的:把 Agent 环境训进权重
模型卡披露的训练配置可以概括为「在真实环境里学,不许作弊」:
- 任务与回合:750 个 scale800 任务穿插 300 个 TermGrade 任务,每任务 8 个 rollout,温度 0.8;每个 rollout 预算上限 50 步、1800 秒。
- 奖励设计:以验证器判定正确性为主,叠加权重 0.1 的工具效率分——做得对还要做得省。
- 反作弊:每次工具调用经过
safeagents规则代理,拦住诸如去 Hub 拉取基准答案的调用,被拦截的 rollout 记 0 分,让 RL 学着绕开 reward hacking。 - 规模:2 张 B200 训练,取 step 160 作为发布权重,整个 run 在计划 1000 步中的第 191 步停止。
- 适配器规格:rank 32、alpha 64,挂载在 q、k、v、o、gate、up、down 投影上,只适用于 Qwen3.8-27B(64 层 dense hybrid,原生 262144 上下文)。
思路上的变化比数字更值得留意:过去默认一套权重通用,为了同时兜住聊天、写作和各种 Agent 框架,模型只能靠超长推理链临场发挥。这套方案换成了单框架特化(harness-specific adapter)——你每天 80% 时间用哪个 Agent 框架,就为它配一个轻量适配器,把框架的状态机和工具格式直接背进权重。
三条接入路径
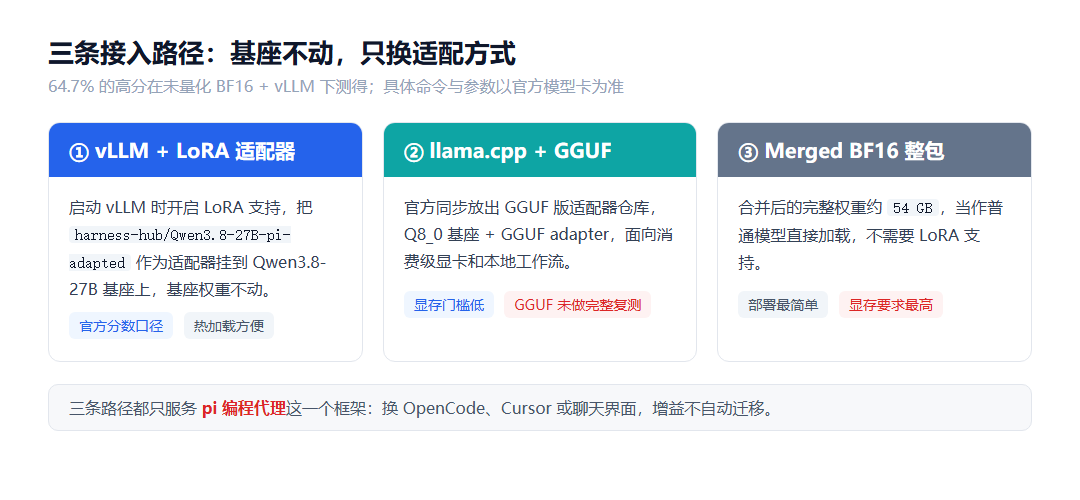
具体命令与参数以官方模型卡为准,三条路径的差异和取舍如下:
- vLLM + LoRA 适配器:启动时开启 LoRA 支持,把适配器挂到基座上,基座权重不动。64.7% 的官方分数就是在这个路径的 BF16 精度下测出来的,想要官方口径的分数先走这里。
- llama.cpp + GGUF 适配器:官方同步放出 GGUF 版适配器仓库,Q8_0 基座加 GGUF adapter,面向消费级显卡。门槛最低,但 GGUF 版本尚未做完整复测,低比特量化后准确率可能折损。
- Merged BF16 整包:合并后的完整权重约 54 GB,当普通模型直接加载,不需要 LoRA 支持。部署最省事,但显存要求最高。
无论走哪条,前置条件都一样:你的编程代理得是 pi(MIT 协议的 Agent 工具箱,自带 coding agent CLI)。适配器强绑定 pi 的提示词结构和工具调用约定,这不是通用微调。
四个官方边界,上生产前先看
- 框架过拟合:增益不迁移。套进 OpenCode、Cursor 或普通多轮对话界面,64.7% 不会自动带过去,甚至可能表现反常;换框架要单独训练对应的适配器。
- 思考模式被固化关掉:官方实测加载这个 LoRA 后强行打开 thinking 不会带来准确率提升,只会多生成约 4 倍 Token,纯属白烧。
- 评测样本小且自报:51 题和 86 题的子集,95% 置信区间正负 10 个百分点;另外 checkpoint 的选择部分用了基准数据,选型时别把榜单数字当承诺。
- 量化版本未复测:高分在未量化 BF16 下测得,消费级显卡上跑 GGUF 低比特版本,预期要打折扣,折扣多少官方没给数。
该不该跟:三步判断
- 先看你的 Agent 框架:日常用 pi 的直接接;用别的框架的等对应适配器或自己训,硬套基座加 LoRA 大概率白忙。
- 再看显存:27B BF16 整包 54 GB 起步,多卡或高端卡才装得下;消费级单卡走 GGUF 路径,接受未复测的折损。
- 最后对准痛点:如果你烦的是等思考、烧 Token,这条路线对症;如果痛点是准确率本身不够,开着思考的基座仍然是最稳的选择。
结论与边界:这次发布对中小团队的意义不在「27B 变多强」,而在验证了一条降本路线——把运行时的推理开销转移到离线 RL 训练的适配器权重里。基座、适配器、Agent 框架三者绑定的约束也摆在那里:框架一换,一切归零。LoRA 本身的基础概念可以看《AI 绘画 LoRA 是什么:一个模型解决一种画风》,不写代码的微调门槛参考《Unsloth Desktop 来了:不写代码微调,显存门槛在哪》。
登录后可点赞、收藏与反馈。