Spring Boot 给 AI 功能限流:整点边界会多放一倍
小团队在 Spring Boot 单体里给 AI 解读加限流:固定窗口为什么在整点放过两倍、20 行时间戳队列怎么写、只数请求为什么会漏掉 TPM 与 10 分钟花费窗口,附 10 条报错急救。
11 月 18 日,监测工具 Spring Insight 的 insight-server 2.1.0 加了两个 AI 功能:两条链路的对比解读、上线前后的变更归因。11 月 21 日,作者把这套 AI 解读的限流实现摊开写了——告警附带的解读默认每小时最多 10 次,控制台的时段小结每小时 20 次。
这个细节比功能本身更值得抄。全网讲 AI 限流的教程,默认你有网关、有 Redis、有 K8s,最好再配个 SRE;现实是大多数小团队的 AI 功能长在一台 4C8G 的 Spring Boot 单体上,上个月刚加,三个人拼的代码。告警风暴一来,AI 解读跟着告警一起放大:一分钟几十条,一小时把一个月的额度打光。
下面拆三件事:为什么 AtomicInteger 的固定窗口在整点会多放一倍;20 行时间戳队列怎么写;以及为什么只数请求数一定会漏——OpenAI 按 TPM 卡、Gemini 按 10 分钟花费卡。代码只依赖 JDK 自带集合,JDK 8 也能跑。
先算清事故模型:AI 功能不是被用户打爆的
把 AI 解读挂在告警上是危险设计:告警的原因通常是服务出错,而服务出错时告警最密。一条告警一次模型调用,等于「故障越严重,花钱越快」。
先估个量级:假设告警每分钟 3 条、每条解读 2,000 输入 token 加 300 输出 token,一小时就是 180 次调用、36 万输入 token。单看金额不一定吓人,但它是从故障里额外长出来的;如果每条告警还带上链路正文,输入会再翻几倍。真正致命的是它出现在你正在排障、最不想看到第二张账单的时候。
所以限流的目标不是省钱,是三件事:给 AI 功能一个硬上限、超限时不影响主链路、上限可解释、可配置。
为什么 AtomicInteger 的固定窗口在整点会多放一倍
最常见的写法是「整点清零」:
// 反例:按整点清零的固定窗口
private static final long HOUR = 3_600_000L;
private final AtomicInteger hourCount = new AtomicInteger();
private volatile long windowStart = -1;

boolean allow(int maxPerHour) {
    long now = System.currentTimeMillis();
    long hourStart = now - (now % HOUR);      // 当前整点
    if (hourStart != windowStart) {            // 跨整点就清零
        windowStart = hourStart;
        hourCount.set(0);
    }
    return hourCount.incrementAndGet() <= maxPerHour;
}
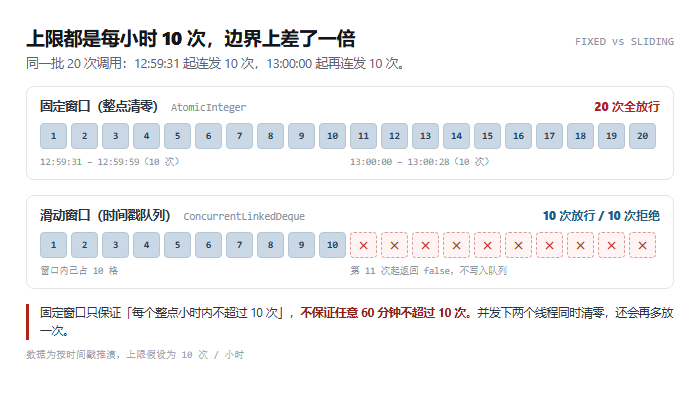
问题出在「窗口跟着整点走」:12:00–13:00 和 13:00–14:00 是两个独立窗口,边界上没有记忆。12:59:31 起连发 10 次,13:00:00 再连发 10 次,一分钟内实际放行了 20 次。
| 时刻 | 第几次调用 | 固定窗口(上限 10 次/小时) | 滑动窗口 |
|---|---|---|---|
| 12:59:31–12:59:59 | 第 1–10 次 | 放行,计数 10/10 | 放行,窗口内 10/10 |
| 13:00:00 | 第 11 次 | 放行,新窗口 1/10 | 拒绝,窗口内 11/10 |
| 13:00:28 | 第 20 次 | 放行,计数 10/10 | 拒绝,窗口内 20/10 |
| 结果 | 一分钟内 | 20 次 | 10 次 |
更麻烦的是并发:两个线程同时判断「已跨小时」,会各自清零一次,计数直接回到 0,第三次调用又能进。这个 bug 在低峰期几乎不会复现,一到告警风暴就出现。
固定窗口不是不能用:它便宜、好解释,适合「每天 1,000 次」这种粗粒度日限额,超一点无所谓。但只要额度关系到钱或下游配额,边界上的两倍就必须处理。
换成时间戳队列:四步实现滑动窗口
滑动窗口不用计数器,用一条队列记住「每次调用发生在哪一毫秒」。任意时刻往回看 60 分钟,队列里剩下的条数就是当前占用。
private final ConcurrentLinkedDeque<Long> alertAiCallTimes = new ConcurrentLinkedDeque<>();

private static boolean tryAcquireQuota(ConcurrentLinkedDeque<Long> times, int maxPerHour) {
    if (maxPerHour <= 0) return false;              // 0 或负数 = 直接关掉
    long now = System.currentTimeMillis();
    long cutoff = now - 3_600_000L;                 // 窗口左边界:一小时前
    while (true) {
        Long oldest = times.peekFirst();            // 只看队头,不遍历
        if (oldest == null || oldest >= cutoff) break;
        times.pollFirst();                          // 过期的扔掉
    }
    if (times.size() >= maxPerHour) return false;    // 满了就不写
    times.addLast(now);
    return true;
}
四步读法:
- 非法上限直接拒绝:配 0 就当关闭功能,别引入「0 表示不限」这种反直觉约定。
- 先挤掉过期的:队头比
cutoff早,就pollFirst,直到队头落在窗口内或队列空了。 - 再判满:剩下的条数到了上限就返回
false,不要先写再判。 - 最后入队:
addLast(now),这一次才算占用。
两个容易忽略的点。第一,别用 LinkedList:告警线程和用户点「解读」可能同时进来,普通链表没有并发约定;ConcurrentLinkedDeque 从 Java 7 就有,无锁 CAS,peekFirst、pollFirst、addLast 都是线程安全的单次操作。第二,size() 不是 O(1):官方文档写得很直白,它要遍历整条链、并发下还可能不准。每小时十几次的量级可以忽略,真要做到每秒几千次,这个结构就不合适了。
还有个细节值得改:System.currentTimeMillis() 是墙钟,NTP 校时或手动改时间会让窗口错乱。只需要算「过去一小时」,用 System.nanoTime() 更稳——它是单调时钟,JVM 重启后队列本来也是空的,两者正好配套。
两条队列不能共用:告警和手动点击要分开限额
项目里用了两条队列:告警解读一条,时段小结一条。原因很实际——告警每分钟都在扫,人点「生成小结」一天没几次。共用一个计数器,告警会把配额吃干,控制台按钮跟着变灰。
if (!tryAcquireQuota(alertAiCallTimes, maxPerHour)) {
    out.put("skipped", true);
    out.put("skipReason", "rate_limited");
    log.info("[AI] 告警解读达每小时上限({}),本次只推指标", maxPerHour);
    return out;   // 告警照发,接口不抛 500
}
注意 skipped 这个语义:超限不是错误,是「这次不花钱」。告警主体、指标、Webhook 该发还发,只是不带 AI 那段话。如果把限流做成抛异常,监控中心会被自己的限流打成 5xx,等于用保护罩把报警通道堵死。
同理,用户手动点的「解释这条链路」不该和后台扫描共用额度。手动操作频率低、预期明确,被后台任务挤掉是最容易被投诉的那种失败。
五种限流方案怎么选:别为了 10 次/小时上 Redis
把常见方案摆在一起,差别不在「谁更先进」,在依赖和精度:
| 方案 | 依赖 | 窗口语义 | 多实例 | 适合 |
|---|---|---|---|---|
| 手写时间戳 deque | 无,JDK 7+ | 任意滚动窗口 | 否 | 单机、低频、只要硬上限 |
Guava RateLimiter | Guava 33.x | 每秒许可,平滑发放 | 否 | 限速,不是配额 |
| Bucket4j 8.22.0 | bucket4j_jdk17-core | 令牌桶,可贪心或整点补充 | 需 Redis 等后端 | 要允许突发容量 |
| Spring Cloud Gateway | Redis + Lua | 令牌桶 | 是 | 已经有网关 |
| Redis ZSET + Lua | Redis | 滑动窗口 | 是 | 多实例、要精确 |
一句话选型:单机、低频、只要硬上限,手写 deque 最省事;要平滑放行、能接受线程阻塞,Guava RateLimiter 够用;多实例,Bucket4j 8.22.0(2026-11-01 发布)或 Redis Lua;已经有网关,别在业务代码里再来一套。
两个坑要提前知道:Guava 的 RateLimiter 至今仍标着 @Beta,按「每秒许可数」平滑发放,不是「每小时 N 次」的硬上限,而且只在单 JVM 内生效;Bucket4j 8.x 的主线构件是 bucket4j_jdk17-core,JDK 8 项目要先确认构件与支持范围,别直接抄 JDK 17 的坐标——老项目更稳的做法就是本文这套零依赖队列。
只数请求数一定会漏:OpenAI 卡 TPM,Gemini 卡 10 分钟花费
上面那套只解决了「次数」。2026 年的模型 API 早就不止一个维度。
OpenAI 的限流按 RPM(每分钟请求)、RPD(每天请求)、TPM(每分钟 token)、TPD(每天 token)以及图像、音频的专项额度计算,哪个先到算哪个;限额挂在组织和项目上,不是按用户;响应头会带 x-ratelimit-remaining-tokens 与 Retry-After,可以直接当客户端信号用。
Gemini 是 RPM、TPM(输入)、RPD 三维,按项目而不是按 key 计;RPD 在太平洋时间午夜重置。更狠的是它还有按花费的限流:滚动 10 分钟窗口,Tier 1 上限 10 美元、Tier 2 是 50、Tier 3 是 200,超了同样返回 429 RESOURCE_EXHAUSTED——请求数和 token 都没超,钱花快了也会被拒。
| 维度 | OpenAI | Gemini |
|---|---|---|
| 请求 | RPM / RPD | RPM / RPD |
| Token | TPM / TPD | TPM(输入) |
| 花费 | 月度用量上限与硬性花费上限,触顶返回 429 | 滚动 10 分钟:$10 / $50 / $200(Tier 1/2/3) |
| 计数范围 | 组织 + 项目 | 项目,不是 API key |
| 重置 | 以控制台限额页为准 | RPD 太平洋时间午夜 |
| 典型错误 | 429 + error.code | 429 RESOURCE_EXHAUSTED |
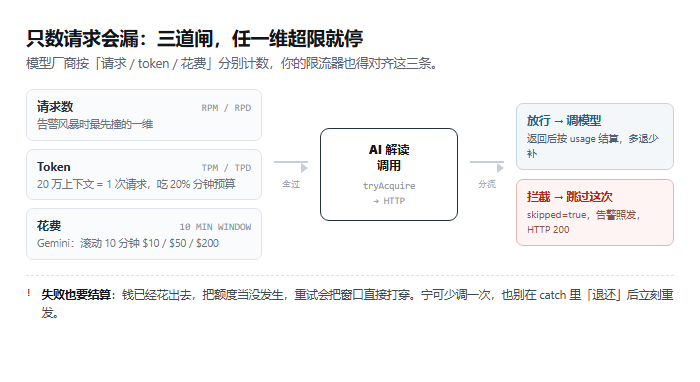
算个账就明白为什么只数请求会漏:假设某模型 TPM 是 100 万,一次带 20 万 token 上下文的分析请求只算 1 次 RPM,却吃掉 20% 的分钟 token 预算;连发 5 次就撞 TPM,而你的请求计数器才走到 5。(TPM 数值是举例,实际以你控制台的限额页为准。)
所以限流要两道:先按 token 预算,再按次数。
int estimated = tokenizer.count(prompt) + maxOutputTokens;   // 输入 + 预留输出

if (!tokenWindow.tryAcquire(estimated)) {
    return AiResult.degraded("token_budget");                 // 降级,不发请求
}
try {
    ChatResponse resp = client.chat(prompt);
    tokenWindow.settle(estimated, resp.usage().totalTokens()); // 多退少补
    return AiResult.ok(resp);
} catch (Exception e) {
    tokenWindow.settle(estimated, estimated);                  // 失败也结算
    throw e;
}
「失败也结算」是刻意的:钱已经花了,至少请求已经发出去了,把额度当没发生只会让重试把窗口打穿。宁可少调一次,也不要在 catch 里「退还」后立刻重发。
token 数别用字符数拍脑袋。中文在不同 tokenizer 下的比例差很多,用官方的 countTokens 或 tiktoken 量一次你真实的提示词,再乘一个安全系数。
多实例部署后,这套单机 deque 就失效了
deque 在堆里。两台机器就是两份配额,四台就是四倍;滚动发布时新旧实例各算各的,限额会短暂翻倍。这不是 bug,是选型的边界。
要跨实例,把「队列」换成 Redis 的有序集合,逻辑一样:
-- KEYS[1]=限流键  ARGV[1]=now(ms)  ARGV[2]=窗口(ms)  ARGV[3]=上限  ARGV[4]=唯一请求ID
redis.call('ZREMRANGEBYSCORE', KEYS[1], 0, ARGV[1] - ARGV[2])
if redis.call('ZCARD', KEYS[1]) >= tonumber(ARGV[3]) then return 0 end
redis.call('ZADD', KEYS[1], ARGV[1], ARGV[4])
redis.call('PEXPIRE', KEYS[1], ARGV[2])
return 1两个细节:ARGV[4] 必须是 UUID 之类的唯一值,不能拿时间戳当 member——同一毫秒的两个请求会在 ZSET 里合并成一条,限流直接少算一次;PEXPIRE 不能省,否则冷键永远不回收。
不想自己写 Lua,可以用 Bucket4j 的 Redis 后端,或者现成的网关限流。但要记住:引入 Redis 之后,限流器本身也成了一个故障点。Redis 挂了是放行还是拒绝,要提前定:内部工具建议放行并告警,对外付费功能建议拒绝。
常见翻车报错与急救清单
下面这些是接 AI 功能时最常撞的十种情况,按「看到什么 → 大概率原因 → 怎么处理」排:
| 现象 / 报错 | 大概率原因 | 处理 |
|---|---|---|
429 + rate_limit_exceeded | 撞了 RPM 或 TPM | 看 x-ratelimit-remaining-requests 与 -tokens 哪个为 0,按 Retry-After 退避 |
429 + insufficient_quota | 余额或预付额度用完 | 重试无用,去账单页充值;别写进重试循环 |
credit_balance_exhausted | 预付额度耗尽 | 购买额度后再恢复,代码侧只做告警 |
organization_spend_limit_exceeded / project_spend_limit_exceeded | 触到硬性花费上限 | 提高上限或等下月重置,重试不会恢复 |
429 RESOURCE_EXHAUSTED(Gemini) | 可能是 RPD,也可能是 10 分钟花费窗口 | 先看 AI Studio 限额页;RPD 要等太平洋午夜 |
429 + slow_down | 请求速率爬升太快 | 按 Retry-After 降速,再逐步加,不要立刻重发 |
| 重启后额度又满了 | deque 在堆里,重启即清空 | 正常;要跨重启就换 Redis |
| 多实例后总量翻倍 | 每台 JVM 各限各的 | 换 Redis ZSET 或 Bucket4j 共享后端 |
| 没到上限却被拒 | size() 并发不准,或两次 addLast 竞态 | 低频可接受;高频加锁或换原子计数 |
| 超限后接口 500 | 限流分支没有 return,异常冒泡 | 改成 skipped 降级,告警主体照发 |
什么场景别用这套
推荐用:单实例或少量实例、每小时几十到几百次调用、AI 只是辅助功能(解读、摘要、归因)、团队没有专职运维。这套代码的价值是「二十分钟能上线,出问题能讲清楚」。
劝退:多实例且要求总额严格、每秒几百次以上的调用、需要按租户精确计费、跨语言服务共用一套配额。这些场景该上 Redis 令牌桶、网关或商业配额系统,手写 deque 只会给你虚假的安全感。
还有一个更省事的兜底:先去模型厂商控制台设一个硬性月度花费上限。OpenAI 和 Gemini 都会在触顶后直接返回 429,这是最后一道闸,不依赖你的代码写得对不对。代码里的限流是「别撞墙」,厂商的花费上限是「撞了别把房子撞塌」。
站内接着看:JDK 8 接大模型的 BOM 冲突、AI 编码预算为什么花在失败上、MCP 工具定义的上下文成本。
你给 AI 功能设的是「每分钟多少次」还是「每小时多少钱」?评论区报一下你的模型、TPM 上限和实际峰值,我帮你看是不是已经贴着天花板在跑。
登录后可点赞、收藏与反馈。


