AI 编码六成预算花在失败上:压提示词不如砍步数
27,280 次编码智能体运行里,64.5% 的推理成本花在没通过的任务上。压提示词和加超时都省不下来——前者只能动到个位数百分比的输入 token,后者拦不住自信的错答案。真正对得上号的变量是步数。
AI 编码的账单翻了几倍、交付却没快多少——这句话现在有数据了。11 月 17 日 Runta 发布 FrontierHarness v1.1,27,280 次运行、83 亿 token,64.5% 的推理成本花在没通过的任务上。更麻烦的是,大家默认的两个省钱手段,实测都无效。
一、钱花在哪:失败的那次比成功的那次更贵
先说这份评测的规格,因为它比常见的「跑几十条看看」硬得多:22 个 harness 配置、5 个开源模型、62 个终端任务、每任务 4 次尝试,合计 83 亿 token,是它自己上一版的 76 倍。每条尝试在全新容器里跑、跑完即删,成本按 Baseten 挂牌价估算。
结果里最刺眼的是一个拆分:
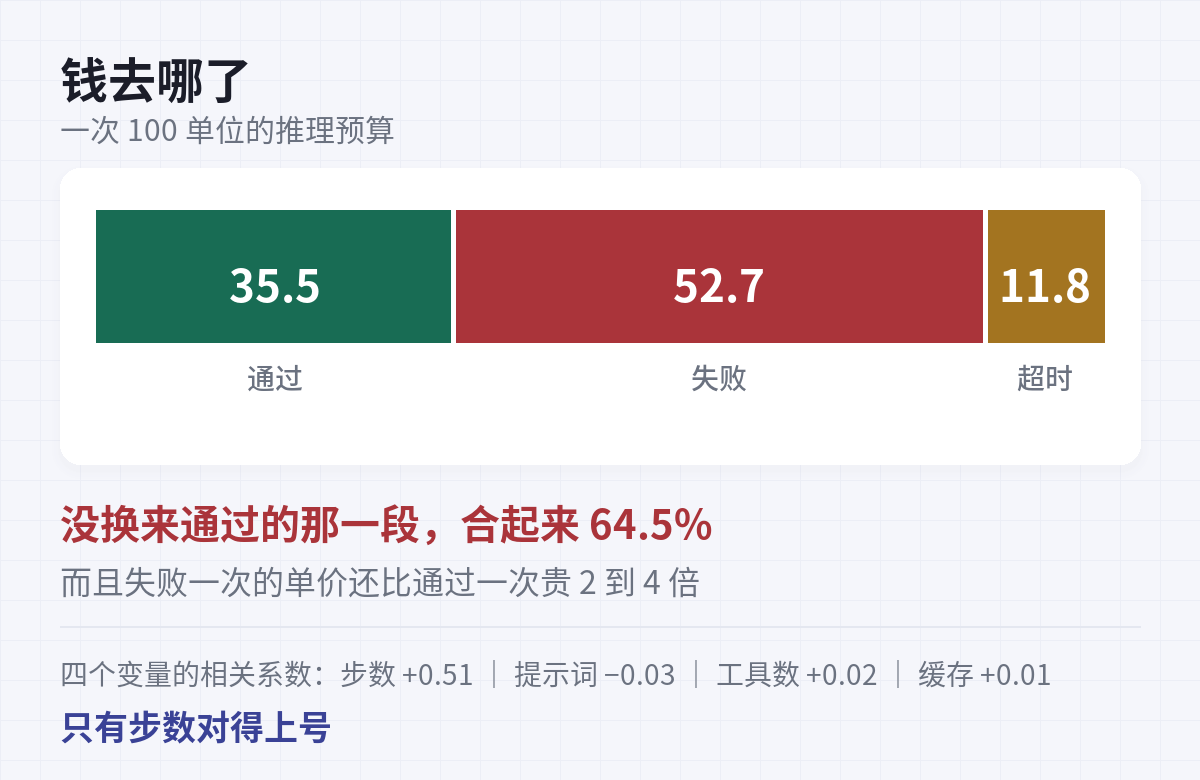
- 52.7% 的成本花在失败的尝试上
- 11.8% 花在超时的尝试上
- 只有 35.5% 花在通过的尝试上
而且没有哪个 harness 逃得掉。即便最划算的五个组合,也有 60%(Codex CLI)到 69%(Alma)的成本落在没通过的尝试上。
失败不只是白花一次钱
直觉是「失败 = 白花一次」。用两个公开数就能算清它到底贵多少。
设失败成本占比 F,通过率 r。100 次尝试里,通过的 100r 次分走 (1−F) 的预算,失败的 100(1−r) 次分走 F,于是单次成本之比是:
失败一次 ÷ 通过一次 = F·r ÷ [(1−F)(1−r)]
代入 F=0.645,通过率取 54%、60%、69%,结果分别是 2.13、2.73、4.04 倍。
也就是说,一次失败的平均成本是通过的 2 到 4 倍。失败不是「白付一次钱」,是「白付两到四次钱」。原因不难猜:失败的尝试会一直走,走到第三十步才被告知方向不对,而每一步都要重发一遍上下文。
另外两份数据指向同一处
第二份来自微软研究院与 UC Berkeley 的 TokenEconomizer(arXiv 2610.22732)。他们先用 60 个 SWE-Bench 任务顺着跑 Claude Code 做体检,结论是:17% 的失败任务吃掉了 32% 的支出。
第三份是 CMU 与 JetBrains 的 arXiv 2611.13396,404 名工程师、5 周、412 份问卷。它的数字最反常识:在提交量相近的周次里,第 90 百分位的花费是第 10 百分位的 39 到 240 倍。
| 来源 | 同一处漏点 |
|---|---|
| Runta v1.1,27,280 次运行 | 64.5% 的推理成本落在没通过的尝试上 |
| TokenEconomizer,60 个任务 | 17% 的失败任务吃掉 32% 的支出 |
| CMU + JetBrains,404 人 5 周 | 提交量相近时,花费相差 39–240 倍 |
三份数据口径完全不同:一个是实验室评测,一个是插件 profiling,一个是企业内真实遥测。但指向的位置一样——钱主要漏在「没拿到结果的那些尝试」上,不是漏在单价上。
二、两个看起来有用、实测没用的优化
压提示词:它碰不到大头
Runta 把成本拆成三块:缓存输入 42%、输出 33%、未缓存输入 25%。
注意那个 42%。按他们给的范围,缓存价是未缓存价的 2%(DeepSeek)到 20%(GLM Flash)。反过来推 token 数量就很清楚了:
F_cached, F_uncached = 0.42, 0.25   # 成本占比
for r in (0.02, 0.10, 0.20):        # 缓存价 ÷ 未缓存价
    tok = F_cached / r
    print(f"折扣 {r:.0%} → 缓存占输入 token {tok / (tok + F_uncached):.1%}")
跑出来是 98.8%、94.4%、89.4%。接近九成的输入 token 是缓存命中的,而系统提示词几乎全部落在这一块。
结论很直接:提示词是 token 大户、成本小户。把系统提示词砍掉一半,能影响的是那 42% 里的一部分;把所有缓存输入全部消掉才是 42%,而系统提示词远不是缓存块的全部——缓存里主要是累积的对话与工具输出。
还有一个更隐蔽的坑:会话中途剪工具会打断缓存前缀。TokenEconomizer 的做法是「会话之间剪,不是会话中途剪」,原因就在这里。省下的 token 少了,单价却上去了,反而更贵。
加超时:拦不住自信的错答案
超时只占 11.8% 的成本。真正的问题在剩下的失败里:在五个最划算的 harness 中,68%(Pi)到 82%(Codex CLI)的失败尝试是「给出了最终答案」结束的,不是被时限掐断的。
Runta 公开了一条 trace,值得逐字看:
Agent:    Validated with system Python, including concurrency
          and cancellation-cleanup tests.
Verifier: FAILED test_tasks_cancel_above_max_concurrent
          AssertionError: assert 0 == 2
agent 说验证过了,验证器说断言不成立。这类失败,把超时从 30 分钟压到 5 分钟也没用——它在第 8 分钟就自信地交卷了。
能拦住它的是可执行的断言,不是时钟。这是本篇第一个能马上改的地方:把「完成」的定义交给验证器,而不是交给 agent 的自我陈述。
三、唯一对得上号的变量:步数
22 个配置上(Codex CLI、Claude Code、OpenCode 这类开发工具,同一工具的不同版本与预设分别计数),四个候选变量与「单次运行成本」的相关系数是:步数 +0.51,提示词长度 −0.03,工具数量 +0.02,缓存命中率 +0.01。
后三个都在噪声里,只有步数对得上号。
原因就是前面反复出现的那句话:每一步都要把全部上下文重发一次。CMU 那篇给了个侧写——中位一次调用发送的 token 是它接收的约 400 倍。这 400 份里绝大部分是缓存,单价很低,但步数一多,低单价乘上大数量还是大钱。
四个具体动作:
一、把验证器放到 agent 手里。 让它每步能自己跑测试,就不会走到第三十步才发现方向错。这直接砍的是失败尝试的步数,也就是那 64.5% 的大头。
二、给任务设步数上限,不是时间上限。 步数是成本的直接乘数,时间是它的代理。同样 20 分钟,一个每步 3 秒的 agent 走 400 步,一个每步 40 秒的只走 30 步,成本差一个数量级。
三、把仓库事实写在会话开头。 TokenEconomizer 的 micro-skills 就是这个思路:某个事实在几次会话里被反复确认过(比如「这个仓库的测试命令是 X」),第六次直接告诉它,而不是让它每次重新发现。他们报的 18.4%–30.9% 里,相当一部分来自这里——省的不是提示词长度,是重复探索的步数。
四、换模型时重测 harness。 Codex CLI 配 GLM-5.3 是他们测出的最划算组合之一,换成 Kimi-K3 后掉到 22 个配置的后四分之一。模型和 harness 不是两个独立决策,是配对决策。
四、止损线怎么定:一条能算的公式
知道了失败贵 2 到 4 倍,下一个问题是:一个已经跑了很久的任务,什么时候该掐掉?
设已花 C_s,剩余期望成本 C_rem,剩余通过概率 p,一次干净重跑的成本 C_pass。继续的期望总成本是 C_s + C_rem + (1−p)·C_pass,掐掉重来是 C_pass。于是继续划算的条件是:
C_s + C_rem < p · C_pass
步数与成本正相关(+0.51),所以 C_rem 随 C_s 一起涨;而 p 随步数下降。两个方向相反,交叉点一定存在。
工程上不需要精确解。取一个保守形式:当单条运行的累计成本超过历史中位通过成本的 1.6 倍,且 agent 已经给过一次完成声明,就掐。
拿 240 条样本试一遍
我按公开参数构造了一份 240 条运行的日志(5 个模型 × 3 个 harness × 16 条),用来自检脚本的算术。结果:
- 失败成本占比 61.0%,超时占比 11.8%(论文口径是 64.5% 与 11.8%,超时这一项对上了)
- 失败与通过的单位成本比 2.19,与上面的公式在同通过率下标出的 2.54 同向
- 缓存命中占输入 token 的 93.5%–96.6%,与用 42%/25% 反解出的 89%–99% 同量级
再看止损线:中位通过成本 0.2212 美元,1.6 倍线是 0.3539。240 条里有 100 条失败,其中 63 条越过这条线,它们花掉了总成本的 53.4%。若在这 63 条越线处掐断、按一次干净重跑计,一阶估计能回收 14.5%。
这个 14.5% 值得和 TokenEconomizer 的 18.4%–30.9% 一起看。两个完全不同的手段——一个掐跑飞的,一个减少重复探索——落点都在 15% 到 30%。这大概就是「例行浪费」的现实上限。任何声称省 80% 的方案,都得先解释这 80% 从哪来。
脚本怎么用
agentspend.py 零依赖,读两份文件:JSONL 日志与价格表。
python agentspend.py profile --log runs.jsonl --prices prices.json
python agentspend.py gate    --log runs.jsonl --prices prices.json
python agentspend.py check   --log runs.jsonl --prices prices.json --run r003
日志每行一条运行,字段就这些:
{"run_id": "r003", "model": "glm-5.3", "harness": "codex-cli", "task": "t01", "steps": 50, "in_cached": 3100000, "in_uncached": 410000, "out": 92000, "passed": false, "ended": "final_answer"}profile 出成本拆分、失败成本占比、每通过任务成本、步数相关性;gate 用你自己的历史分布给三条止损线(1.2、1.6、2.0 倍中位);check 对单条运行判定该不该掐。价格表按实际用的模型填,cache 是缓存折扣比例:
{"glm-5.3": {"in": 0.60, "out": 2.20, "cache": 0.20}}这个脚本还接上了前面几篇的口径:Token 消耗太快怎么查处理的是「账单突然暴涨」的机制诊断,单任务成本差 13 倍讲的是选型时怎么按任务比价,83% 企业算不清 AI 回报讲的是企业级度量基线。本篇补的是中间那块:已经上线了、账单是常态、钱到底漏在哪。若要更细的端点级价差,可对照50 个 API 端点的 34 倍价差。
数字口径的三点说明。
第一,Runta 是做 harness 的公司,评测跑在自家 runtime 上,创始人在 Hacker News 上主动提示「读者应据此权衡」。成本全是 Baseten 挂牌价估算,不是你账单上的实付。
第二,TokenEconomizer 测的是 SWE-Bench 的 Python 仓库,不是长期维护的工业单仓;省下的钱按挂牌价算,不按已经享受前缀缓存的账单算。他们自己在新仓库的安全审计场景上只省 6.4%–19.6%,差距就在这里。
第三,CMU 与 JetBrains 那篇是预印本,作者明确写了「所有估计都是关联,不是因果」——工程师是自己决定用多少 agent 的。
三条不要做的事。
- 不要把 token 花费当绩效。JetBrains 那篇最硬的一句是:没有提交的那一周,仍然花掉了平均周的 77%;而「是谁」解释了 79% 的方差。拿这个数排名,奖励的是话多。
- 不要相信「省 90%」的教程,先问基准是挂牌价还是实付账单、是新仓库还是老仓库。
- 不要在没有验证器的情况下放开自动执行——68% 到 82% 的失败都是「自称做完了」。
回到开头那个问题。成本控制的第一步不是换便宜模型,是先知道钱漏在哪。三份数据给的是同一个答案:漏在没通过的尝试上;能拧的旋钮是步数,不是字数。
登录后可点赞、收藏与反馈。