AI 写的 Three.js 大屏越跑越卡:55 秒漏 75.6MB,5 分钟体检脚本
AI 生成的大屏,第七天开始卡。Node 22 + three 0.187 复现三种写法:每帧 new Mesh 55 秒漏 75.6MB、16000 节点遍历 3.084ms、dispose 空转不释放。附 5 分钟控制台体检脚本。
全网教程都在教你「十分钟用 AI 生成一个 3D 数据大屏」,没人教你第七天它为什么会卡。照抄的结果往往一样:Demo 丝滑,上线一周,某个早高峰页面白屏,控制台躺着 WebGL context lost,风扇狂转。
先把话说清楚:我不是反对 AI 写大屏,我反对的是拿 demo 的验收标准去跑一块 7×24 不关的屏。AI 生成代码时不知道这块屏要开一整天,「能跑起来」就是它的全部标准。
所以我把 AI 生成大屏里最高频的几种写法收集起来,在 Node 22 + three 0.187.0 里逐个复现。Node 里没有 WebGLRenderer,GPU 侧测不了,但病灶大多长在 JS 侧——场景图怎么堆、对象怎么泄漏,这些测得一清二楚;而且没有显卡差异,同一台机器跑出来的曲线横向对比是干净的。结论先给:55 秒泄漏 75.6MB、16000 个节点单次遍历 3.084ms、dispose 在 JS 堆层面等于没调。
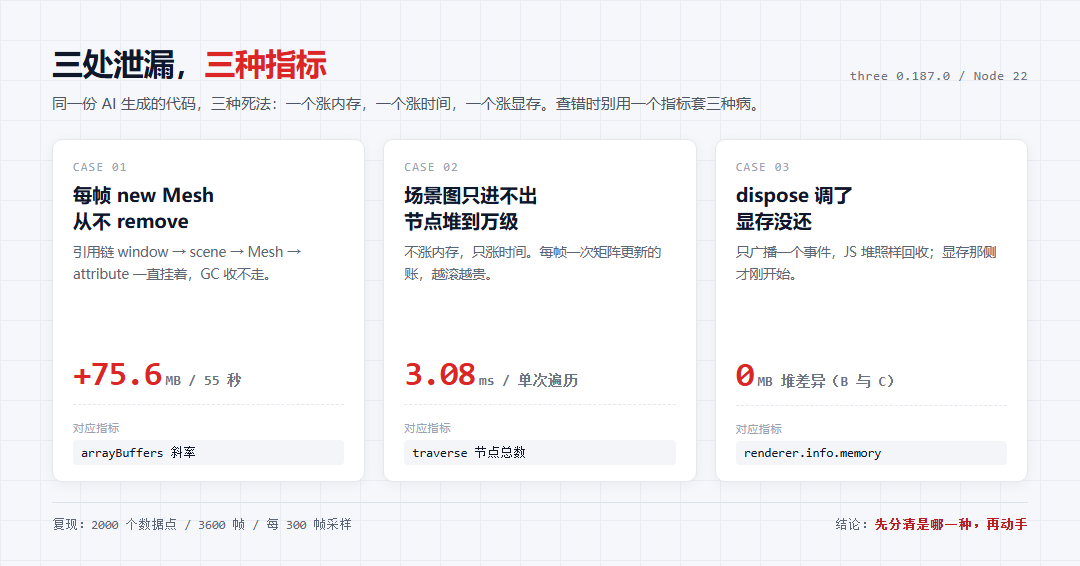
Three.js 大屏越跑越卡,先分清是哪一种病
「卡」是三种完全不同的病,用同一个指标去查,只会得出「玄学」的结论。
| 症状 | 涨的是 | 先看哪个指标 | 处理方向 |
|---|---|---|---|
| 内存阶梯上升,强制 GC 后不回落 | JS 堆 | arrayBuffers 斜率 | 别再每帧 new |
| 帧率缓慢下滑,内存曲线却很平 | 每帧耗时 | traverse 节点总数 | 清场景图 + 合批 |
| 跑几小时后白屏、报 context lost | 显存 | info.memory / GPU memory | 真释放 + 卸载上下文 |
三者会叠加,但定位顺序不能乱:先看内存涨不涨,再看节点涨不涨,最后才轮到显存。显存那层最难复现,留到最后。
病灶一:每帧 new 一个 Mesh,55 秒漏 75.6MB
AI 生成大屏代码有个高频模式:数据每帧都在变,它就顺手写了「重建」——每帧 new 一个 BufferGeometry、new 一个材质、new 一个 Mesh,add 进场景。代码长得人畜无害:
// bad.mjs:每帧重建,从不清理
for (let f = 0; f < FRAMES; f++) {                  // 3600 帧 ≈ 60 秒
  const geo = new THREE.BufferGeometry();
  geo.setAttribute('position',
    new THREE.BufferAttribute(makePoints(POINTS), 3)); // 2000 个点
  const mat = new THREE.MeshBasicMaterial({ color: Math.random() });
  scene.add(new THREE.Mesh(geo, mat));               // 只 add,不 remove
}
2000 个点的 position 是 Float32Array(6000),24KB 一个。跑 3600 帧(对应浏览器里约 60 秒),每 300 帧采样一次。最后一次采样落在第 3300 帧、也就是第 55 秒,此时已经漏了 75.6MB:
| 采样点 | 累计泄漏 |
|---|---|
| 600 帧(第 10 秒) | 13.8MB |
| 1200 帧(第 20 秒) | 27.5MB |
| 1800 帧(第 30 秒) | 41.2MB |
| 2400 帧(第 40 秒) | 55.0MB |
| 3000 帧(第 50 秒) | 68.7MB |
| 3300 帧(第 55 秒) | 75.6MB |
折算下来 1.38MB/s,和理论值 24KB×60fps = 1.44MB/s 对得上。线性外推:17 分钟 1.4GB,50 分钟摸到 4GB——64 位 Chrome 的默认堆上限就在这个量级。所谓「上线三天卡崩」,按这条曲线几个小时就够,三天都算它坚挺。
收不回去的原因不复杂:Float32Array 挂在 BufferAttribute 上,被 Mesh 引用,被 scene.children 引用,而大屏页面里的 scene 是常驻的,活到页面关闭为止。GC 能回收的只有「没有任何引用」的对象,你这条引用链从 window 一路攥到底。
第一版脚本我测错了:heapUsed 里没有 TypedArray
第一版实验我用 heapUsed 采样,60 秒只涨 11MB,和 86MB 的累计分配量对不上,差点得出「这写法没那么糟」的结论。查了才知道:V8 的 heapUsed 根本不含 TypedArray 的底层数据,那些记在 arrayBuffers 字段里。
const m = process.memoryUsage();
// rss = 进程总占用;heapUsed = JS 堆;arrayBuffers = TypedArray 底层数据
console.log(m.heapUsed / 1048576, 'MB heapUsed');
console.log(m.arrayBuffers / 1048576, 'MB arrayBuffers');换指标重跑,数字才对上。测内存泄漏只看一个数,结论可能是错的。浏览器里同理:performance.memory.usedJSHeapSize 也不是全量账本,还是 Chrome 的私有实现,别的浏览器不一定有。
对照写法:geometry 常驻,每帧只改数据
// good.mjs:常驻 geometry,每帧原地改数据
const geo = new THREE.BufferGeometry();
const attr = new THREE.BufferAttribute(new Float32Array(POINTS * 3), 3);
geo.setAttribute('position', attr);
scene.add(new THREE.Mesh(geo, mat));   // 只建一次

// 每帧
for (let i = 0; i < attr.array.length; i++) {
  attr.array[i] = attr.array[i] * 0.999 + Math.sin(i + f * 0.01) * 0.001;
}
attr.needsUpdate = true;               // 只重传数据,不新建对象
同样 3600 帧,arrayBuffers 全程 0,heapUsed 稳在 16.4MB 一动不动。修复版代码反而更短——这不是「性能优化」,是把 AI 顺手省掉的三行补回来。
病灶二:场景图只进不出,16000 个节点单次遍历 3.084ms
第二个病灶更隐蔽,因为它不涨内存,只涨时间。three 的渲染循环每帧要做一次场景图遍历,three 0.187 的 WebGLRenderer.js 第 1667 行写得很直白:
if ( scene.matrixWorldAutoUpdate === true ) scene.updateMatrixWorld();按节点规模分档实测,每档跑 30 次取中位数:
| 场景节点数 | 单次遍历耗时 |
|---|---|
| 1000 | 0.058ms |
| 2000 | 0.117ms |
| 4000 | 0.281ms |
| 8000 | 0.599ms |
| 16000 | 3.084ms |
节点涨 16 倍,遍历从 0.058ms 涨到 3.084ms,16000 那档还出现超线性跳变——不止是 8000 档的两倍。0.06ms 看着不要紧,但它发生在每帧只有 16.7ms 预算的主线程上,而且是纯 CPU 计算,显卡再好也帮不上忙。
还有个采样细节值得记一笔:100 档首跑出过 0.137ms 的怪数据(比 500 档还慢),复跑才发现是第一个场景吃了 JIT 预热。测性能,第一组样本别直接采信。
scene.children.length 只数一层,要用 traverse
大屏上真正把节点堆起来的往往不是 Mesh,而是滚动数据标注、告警 sprite、动态图例——很多 AI 实现都是「来一个 add 一个」,最后全在同一个遍历里交税。而 scene.children.length 只数第一层,一个 Group 里塞一万个孩子,这个数照样是 1。
// 只数一层,容易低估
console.log(scene.children.length);

// 数全量
let n = 0;
scene.traverse(() => n++);
console.log('节点总数', n);
静态节点别再陪跑矩阵更新
摆好就不动的楼块、模型、装饰,默认也在每帧的矩阵更新里陪跑。节点设 matrixAutoUpdate = false、手动 updateMatrix() 一次;或者在场景层面设 matrixWorldAutoUpdate = false 自己控节奏。这招官方文档写着,但 AI 生成的代码里我几乎没见过它出现。
病灶三:dispose 只广播了一个事件,显存那边才刚开工
AI 生成的代码里 dispose 也常出现,但位置经常不对,或者被当成「调了就安全」的护身符。three 的 dispose 源码就三行:
// three/src/core/BufferGeometry.js
dispose() {
  this.dispatchEvent({ type: 'dispose' });
}
它不做释放,只广播一个事件。真正删 VBO、删着色器程序的,是渲染器内部监听这个事件的那段代码。
三组对照:remove 有用,dispose 在堆上看不出来
三组各 300 个 Mesh(每组 position 数据约 3.6MB),跑完强制 GC,看堆里剩什么:
| 组 | 做法 | build 增量 | 强制 GC 后回收 |
|---|---|---|---|
| A 留在场景 | 只 add,不 remove | +4.5MB | 0.1MB |
| B remove 不 dispose | 断开引用 | +4.4MB | 4.3MB |
| C remove + dispose | 成对执行 | +5.4MB | 5.4MB |
B 和 C 在 JS 堆上没差别。原因很清楚:remove 断开引用,JS 堆就回收了;而 GPU 侧资源,只有在 dispose 事件被渲染器收到之后才删。dispose 的价值在显存那一侧,在堆上看它,永远看不出效果。
更绕的是:没被渲染过的对象,渲染器那边什么都没建,dispose 无事可做。所以「我明明 dispose 了」经常是错觉——要么对象从没进过渲染流程,要么事件根本没到渲染器手里。
dispose 最容易挂错的地方
图层切换时把旧图层 remove 了,dispose 却挂在组件卸载的生命周期里。SPA 里那个钩子可能几个小时都不触发,显存就在中间悄悄往上堆。正确写法是成对出现,并且集中成一个函数,别散落在各个回调里:
function release(obj) {
  obj.parent?.remove(obj);
  obj.geometry?.dispose();
  if (Array.isArray(obj.material)) {
    obj.material.forEach(m => m.dispose());
  } else {
    obj.material?.dispose();
  }
}
material 那条数组分支不是防御性编程——multi-material 的 Mesh 真的会传数组,漏一个就漏一份显存。
AI 不会写的另外三行清理(长驻大屏才要命)
一、渲染循环被注册了两次
React StrictMode 双挂载、HMR 热更新、路由切回来重新 init,都会让 requestAnimationFrame 叠加。两条循环 = 一帧渲染两次 = 遍历、排序、提交全翻倍,而内存和节点数都看不出异常——这是「明明没泄漏但就是卡」的常见来源。
用 renderer.setAnimationLoop(fn) 代替手写 rAF:它内部只有一个循环,重复调用是替换不是叠加,停的时候传 null。官方注释也建议所有动画循环都走这个方法,别手写 requestAnimationFrame。
二、贴图没 dispose,geometry 数看着却正常
renderer.info.memory 里 textures 和 geometries 是分开计数的。CanvasTexture 撤下来不 dispose,照样占显存,但你在几何体计数上看不出任何异常。另外,texture.needsUpdate = true 是「重传数据」,跟释放是两件事——很多人把它当成了清理。
三、卸载顺序错了,WebGL 上下文留在后台
Chrome 单个标签页同时活跃的 WebGL 上下文大约 16 个,超了会丢掉最老的那个,控制台警告是 Too many active WebGL contexts. Oldest context will be lost.。SPA 里来回切几次页面不主动释放,旧上下文就一直挂着。顺序别写反:
renderer.setAnimationLoop(null);      // 1. 先停循环
scene.traverse(o => { if (o.isMesh) release(o); }); // 2. 再逐个释放
renderer.dispose();                   // 3. 清渲染器内部缓存
renderer.forceContextLoss();          // 4. 主动丢掉 GL 上下文
五分钟体检脚本:贴到控制台,看斜率不看绝对值
只在开发和验收环境用。先在业务代码里把两个对象挂出来(生产别挂):
window.__probe = { scene, renderer }; // 仅开发/验收环境然后贴这段,让它跑 60 秒,别切标签页:
(function watch(seconds = 60) {
  const { scene, renderer } = window.__probe;
  const rows = [];
  const t0 = performance.now();
  const count = () => { let n = 0; scene.traverse(() => n++); return n; };

  const timer = setInterval(() => {
    rows.push({
      s: Math.round((performance.now() - t0) / 1000),
      nodes: count(),
      geo: renderer.info.memory.geometries,
      tex: renderer.info.memory.textures,
      calls: renderer.info.render.calls,   // 单帧 draw call,每帧自动清零
      heapMB: performance.memory
        ? +(performance.memory.usedJSHeapSize / 1048576).toFixed(1) : null
    });
  }, 5000);

  setTimeout(() => {
    clearInterval(timer);
    console.table(rows);
    const a = rows[0], b = rows[rows.length - 1];
    console.log('净增节点', b.nodes - a.nodes,
                '/ 净增几何体', b.geo - a.geo,
                '/ 净增贴图', b.tex - a.tex);
  }, seconds * 1000);
})();看首尾差,不看某一刻的绝对值。info.render.calls 是单帧 draw call 数(autoReset 默认开,每帧结束清零),不是累计值——想统计多帧得自己把 autoReset 关掉再手动 reset()。
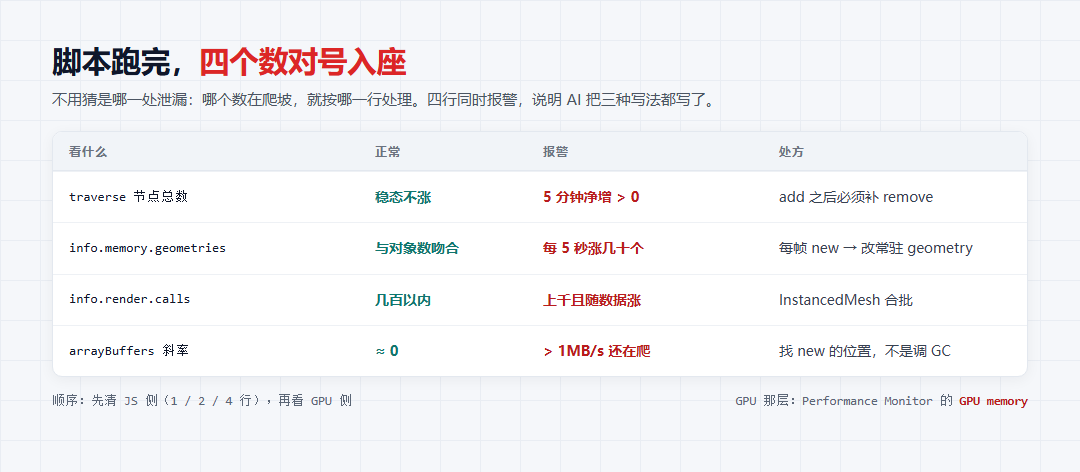
四个数怎么判:一张表对号入座
| 看什么 | 正常 | 报警 | 处方 |
|---|---|---|---|
traverse 节点总数 | 稳态不涨 | 5 分钟净增 > 0 | add 之后必须补 remove |
info.memory.geometries | 与对象数吻合 | 每 5 秒涨几十个 | 每帧 new → 改常驻 geometry |
info.render.calls | 几百以内 | 上千且随数据涨 | InstancedMesh 合批 |
arrayBuffers 斜率 | ≈ 0 | > 1MB/s 还在爬 | 找 new 的位置,不是调 GC |
顺序别倒:先把 JS 侧的账清完,一半「玄学卡顿」在这里就终结了。GPU 那层最后再看,DevTools 的 Performance Monitor 面板里有 GPU memory 一项,挂一晚上看它爬不爬。
常见翻车报错与急救清单
| 现象 | 十有八九是 | 一行验证 | 处理 |
|---|---|---|---|
白屏 + WebGL context lost | 显存被吃爆 | info.memory.geometries | release 全场景 + forceContextLoss |
| 内存阶梯上升,GC 后不回落 | 每帧 new 对象 | arrayBuffers 斜率 | 常驻 geometry + needsUpdate |
| 帧率随时间下降,内存平稳 | 节点膨胀 | traverse 计数 | remove + 关 matrixAutoUpdate |
| 调了 dispose,几何体计数不降 | 对象从没被渲染过 | 前后比 info.memory | 确认渲染过一次再释放 |
| 切路由后风扇还转 | 渲染循环没停 | 页面切走看 CPU 占用 | setAnimationLoop(null) |
| 进出页面几次后越来越慢 | WebGL 上下文泄漏 | 看是否有 Too many contexts 警告 | dispose + forceContextLoss |
| 改了 InstancedMesh 矩阵画面不动 | 没置脏 | instanceMatrix.needsUpdate | 改完矩阵设为 true |
| 换贴图不生效、撤贴图显存不降 | 把 needsUpdate 当 dispose | info.memory.textures | 换图置脏,撤图 dispose |
让 AI 下次直接写对:提示词补三句,验收加四条
指望模型自己想到「这块屏要开 7×24」不现实,但把约束写进提示词,命中率会明显不一样。我现在固定加这三句:
- 数据每帧变化时禁止新建 geometry / material,复用常驻对象并置
needsUpdate。 - 所有下线对象走同一个 release 函数:先 remove 再 dispose,material 要兼容数组。
- 同类对象超过 200 个用 InstancedMesh,标注类对象按时钟批量清理。
验收清单也固定四条:控制台 5 分钟节点净增为 0;info.memory.geometries 与对象数吻合;单帧 draw call 有明确上限;切走路由后风扇停转。这四条比「看着不卡」有用得多。
什么情况别走这条路(三条劝退边界)
- 页面生命周期只有几小时:活动页、投放页、展会屏,浏览器关掉就整锅回收,别为它加一套资源管理,改造风险大于收益。
- 对象总数长期几百以内:InstancedMesh 的合批收益抵不过改造风险,先把 dispose 写对、把每帧 new 干掉就够。
- 每个实例样式都不同:一个 InstancedMesh 共享一份材质,硬套会把你逼进
instanceColor的窄路。拆图层 + 按时钟批量清理更现实。
三个实验脚本两百来行,本地跑一遍几分钟,数据都能复现。有点意外的是,这些病灶全是最基础的 API 用法,没有一个是冷知识——但它们凑在一起,刚好能解释「上线三天卡崩」的完整过程。
AI 把「从 0 到 1」的门槛降到了脚踝,「从 1 到 100」的性能悬崖还是得自己爬。同一条线上的两件事可以接着看:《AI 写的代码不敢直接合并:验证三件套》、《AI 生成网页一眼塑料感?unslop 去 AI 味实测》。
最后留个问题:你手上那块大屏,控制台里 traverse 出来是多少个节点?卡在第几秒、报的什么错,把机型和那行数字丢评论区,我帮你判是三种病里的哪一种。
登录后可点赞、收藏与反馈。


