AI 写的代码不敢直接合并:照抄 Claude Code 团队的验证三件套,单人项目半天配好
Claude Code 团队 90% 代码由 AI 写和审,靠的是验证闭环而非模型聪明。单人项目可照搬的三件套:/verify 自动跑应用、三轮修不好交给人、评审规则锁进改不到的分支,附 8 条翻车急救清单。
这几天全网都在转同一个数字:Claude Code 团队约 90% 的代码由 Claude 写、也由 Claude 审(Addy Osmani 2026-11-16 在 claude.dev 发文,本人数过的原文口径)。但转发的人几乎都不写后半句:Anthropic 敢这么干,前提不是模型聪明,而是有一套验证链路在替人盯着。照抄主流教程里「提示词写好、大胆信任」的用法,AI 一句「改完了」你就点合并,翻车只是时间问题。
好消息是,这套链路里最值钱的三样——verify skill、三轮上限、REVIEW.md——全部是 Claude Code 的现成机制,不是 Anthropic 的内部工具。本文按投入从小到大排好落地顺序,单人项目半天能配好:从 v2.1.286 起,配置完成后提交前验证自动执行,不再依赖你记得提醒。
先把丑话说在前面:原文只给做法、没给效果数字,两个被疯传的数字其实另有出处(文末有专节拆解)。文中所有机制均已核对 2026-11-20 在线的官方文档与 11-16 原博客,涉及版本的行为以官方文档标注为准。
为什么「AI 说改完了」不能直接信?同一个脑子既写又验是根源
写代码的和判断「代码写没写对」的是同一个模型,提示词循环里等于它自己给自己打分。原文给过一个很直白的判断:没有验证闭环,你同时只能跑一两个 Claude,因为每样产出都得亲手查;有了验证闭环,才能并行跑几十个甚至上百个。验证层的另一层价值是让检查本身变便宜——测试、基准、规格、端到端运行都可以让 agent 生成,生成后作为普通程序反复跑,几乎不额外烧 token。
先看清两种用法的差距在哪:
| 环节 | 主流教程的用法 | Claude Code 团队的做法 |
|---|---|---|
| 怎么算「改完了」 | AI 自己说完成了 | 把应用真跑起来,按真实用户流程确认 |
| 检查谁写 | 没有,或让 AI 顺手写几个测试 | 代码负责人写检查并持续调,直到它报的问题就是自己会挑的那些 |
| 修不好怎么办 | 让 AI 再试一次,试到通过为止 | 同一项检查连续三轮没过,停下来叫人,并写明为什么叫人 |
| 评审规则 | 全靠模型自觉 | REVIEW.md 放在改动改不到的分支上 |
| 出过的事故 | 没有沉淀 | 39 条可靠性清单,diff 命中才查 |
把官方博客和文档里的做法归拢成三步,落地顺序和投入如下:
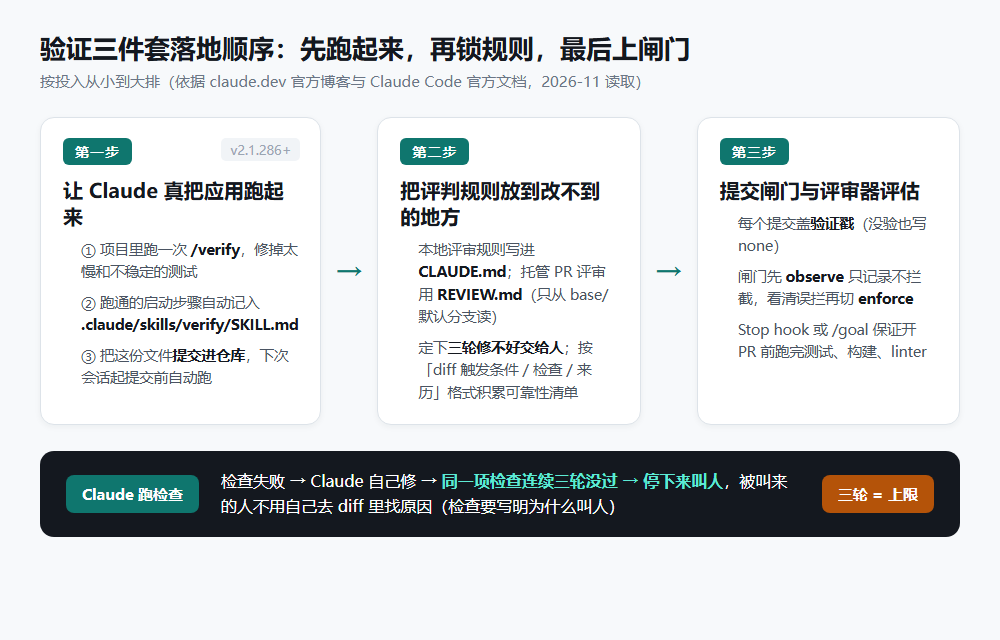
第一步:让 Claude 真把应用跑起来——/verify 的三步落地
原文的类比是:没人会不在模拟器里试一下就发布 iOS 改动,对 Claude 也一样。团队的用法是让 Claude 像 QA 一样测整个应用——网页改动用 Claude 的 Chrome 扩展,移动端用 iOS/Android MCP,桌面应用用 computer use,后端就在本地把服务跑起来。原文说 Anthropic 几乎所有改动都这么测。
第 1 步:项目里先跑一次 /verify。自带的 /verify 不用配置,按项目类型(CLI、server、TUI、浏览器应用)和 README、package.json、Makefile 推断启动方式,构建并运行应用确认改动生效,不退回到跑测试或类型检查。项目需要数据库、env 文件、图形界面或多步构建时推断就不可靠,这时先跑 /run-skill-generator:它从干净环境把应用跑起来,把有效的安装命令、环境变量、启动脚本录成 run-<name> 的项目 skill。
第 2 步:把跑通的步骤提交进仓库。/verify 在没有现成步骤时,会把跑通的步骤写进仓库根目录的 .claude/skills/verify/SKILL.md(monorepo 写到被改动的包目录),在仓库根目录时会替换自带的 /verify。Claude 只在这份文件把某次运行带错时才改它,所以可以直接提交进仓库、不怕每会话产生 diff。
第 3 步:等它自动生效。从 v2.1.286 起,会话开始时如果存在名为 verify 或 simplify 的 skill,内置提交指令会要求 Claude 每次提交前先跑它(只改文档或测试的提交除外)。最容易翻车的是来源:自带的 /verify、插件里的 skill、claude.ai 账号同步来的 skill 都不算数,必须是项目、个人、企业目录或 .claude/commands/ 下的同名文件。另外两个条件:skill 没被 disable-model-invocation 关掉、没关掉 includeGitInstructions。由于是会话开始时检查,配置完要开新会话才生效。
第二步:把「修不好」写死——三轮上限与 39 条可靠性清单
没人能读完所有改动,团队就让失败决定哪些改动需要人:Claude 跑检查,失败了自己修;同一项检查连续三轮还没过,停下来把人叫进来。配套要求是,检查把人叫来时要写明为什么——被叫来的人不用再去 diff 里自己找原因。
该查哪些风险,由一份 39 条的可靠性清单决定。每条由三部分组成,这个格式是最值得照搬的部分:
| 组成部分 | 要求 | 原文的例子 |
|---|---|---|
| 触发条件 | 必须写成能从 diff 判断的事实 | 改了会话存储或消息类型 |
| 检查 | 命中触发条件才执行 | --resume 能加载旧会话记录,新加的字段要能被旧记录安全加载(旧记录里没有这个字段) |
| 来历 | 记录促成这条的事故或 PR | 当时的故障单 |
Claude 读 diff 后只核对触发条件命中的条目,通常 3 到 10 条——没人需要背下历史上出过哪些事故。漏掉的 bug 也有固定入口变成新规则:在至少两个 PR 里出现、且能从 diff 识别的模式才算候选,然后由三个 agent 试着推翻,最后由人在 PR 里审批;已知事故关联的 PR 会拿三个找 bug 的 agent 重放,至少两个找到才算可检测,如果在小 diff 上也漏掉了,就写进 REVIEW.md。顺带一条铁律:flaky 测试不许跳过、不许加 sleep、不许重试到通过,找不到根因就删掉这个测试并写下原因——不稳定的测试会把 agent 教成重跑碰运气,而不是修代码。
第三步:把评判规则放到 AI 改不到的地方
这一步是整套流程的底线:一个改动如果能修改评判它的检查,这个检查就失效了。落到 Claude Code 上是两套文件、两条读取规则:
- 本地 /code-review 命令读 CLAUDE.md,不读 REVIEW.md。想让本地评审也遵守的规则,写进 CLAUDE.md(项目通用背景也放这里)。
- 托管的 PR 评审服务读 base/默认分支上的 REVIEW.md,从不读 PR 自己的改动。要改评审行为,得先把 REVIEW.md 的修改合并进去;它同时也读 CLAUDE.md。
三类指令只有在默认分支受保护时才被执行:降低严重级别、排除路径或问题类别、限制 Nit 数量。子目录里也可以放 REVIEW.md 为该目录追加检查,但 test / tests / __tests__ / fixtures / example / demo / generated / vendor / node_modules 等目录名及其以下不生效(整名匹配,integration-tests 不算 tests),子目录文件共享 150,000 字节上限(不含根文件)。规则多了可以在根 REVIEW.md 里用单独一行 @文件名 引入:文件必须放仓库根目录、文件名精确匹配,最多 8 个、合计不超过 150,000 字节、Markdown 链接不超过 64 条,超限整份跳过。
一份能直接抄的 REVIEW.md 骨架(规则内容换成自己项目的):
# 评审说明

## 什么算 Important
只有会导致行为错误、数据泄露或无法回滚的问题算 Important。
命名、风格、重构建议最多算 Nit。违反 CLAUDE.md 一律算 Important。

## Nit 上限
每次评审最多报 3 条 Nit。

## 不要报
- CI 已经检查的 lint、格式、类型错误
- src/generated/ 下的生成代码和 lock 文件

## 每次都要查
- 改了接口返回结构的,要同步更新接口文档
- 用户能看到的报错文案里不能出现内部错误码

## 证据要求
判断代码行为有问题时,必须给出 file:line 证据,不能凭函数名推断。

## 总结格式
先写发现了几个问题;没有需要修的,直接写没有。
多轮评审和验证要互相衔接而不是各查各的:每一轮都带上前几轮和以往失败的上下文,原文的说法是这样更便宜、也找得更多。评审结果只对当时的提交有效——评审进行中有人推了新提交,这次评审就作废,原话是「A passing review on an out-of-date commit means nothing」。
提交闸门:先 observe 再 enforce,被拦两次自动放行
团队给自己仓库的每个提交盖一个验证戳,写明这个提交是怎么验证的——没验证也要写成 none,这样才能查出哪些提交漏了。闸门三档:off 不启用;observe 只记录本来会被拦下的提交,用来复查误拦、不影响任何人;enforce 真拦,但提交信息里可以写明为什么没验证,而且同一个会话里被拦过两次,下一次就放行——原文给的理由很实在:Claude Code 也不完美,别让它卡死。
想保证开 PR 前跑完测试、构建和 linter,官方给两个工具,场景不同:
| Stop hook | /goal | |
|---|---|---|
| 作用范围 | 设置文件里配置,范围内所有会话 | 只在当前会话生效 |
| 本质 | Claude 每次结束响应时触发的 hook | 会话级 prompt-based Stop hook 的封装 |
| 怎么拦 | 脚本做确定性检查,返回 decision: "block" 或退出码 2,Claude 就继续干活 | 条件最长 4000 字符,每个回合结束由配置的 small fast model 判定「未达成 / 达成 / 不可能」 |
| 关键边界 | Stop/SubagentStop 的 hook 挂了,Claude 自己修不了,要人管 | 判定模型不跑命令、不读文件,只看 Claude 在对话里摆出的证据 |
用 /goal 时记得在条件里写兜底,例如 /goal all tests pass and lint is clean, or stop after 20 turns;判定模型连续多回合没看到工具调用会自动停循环,但显式上限更保险。取消用 /goal clear。
常见翻车与急救清单
按出现频率排,前三个是我认为单人项目最容易中的:
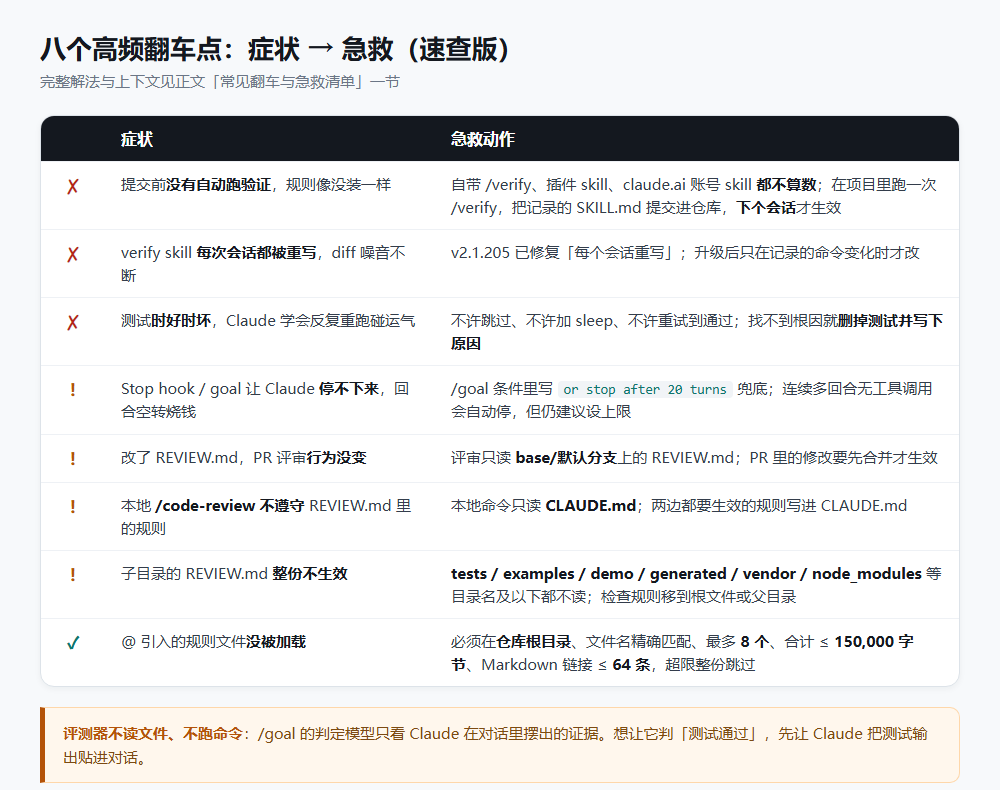
| # | 症状 | 急救 |
|---|---|---|
| 1 | 提交前没有自动跑验证,配置像没装一样 | 自带 /verify、插件 skill、claude.ai 账号 skill 不算来源;在项目里跑一次 /verify,把记录的 SKILL.md 提交进仓库,开新会话才生效 |
| 2 | verify skill 每次会话被重写,diff 噪音不断 | 旧版已知问题,v2.1.205 修复为只在记录的命令变化时改写,升级即可 |
| 3 | 测试时好时坏,Claude 学会反复重跑碰运气 | 禁止跳过、加 sleep、重试到通过;找不到根因就删测试并写下原因 |
| 4 | Stop hook / goal 让 Claude 停不下来,回合空转烧 token | 条件里写 or stop after 20 turns 兜底;/goal 连续多回合无工具调用会自动停 |
| 5 | 改了 REVIEW.md,PR 评审行为没变 | 评审只读 base/默认分支上的副本,PR 里的修改要先合并才生效 |
| 6 | 本地 /code-review 不遵守 REVIEW.md | 本地命令只读 CLAUDE.md;两边都要生效的规则写进 CLAUDE.md |
| 7 | 子目录 REVIEW.md 整份不生效 | tests / examples / demo / generated / vendor / node_modules 等目录名及以下不读;规则移到根文件或父目录 |
| 8 | @ 引入的规则文件没被加载 | 必须在仓库根目录、文件名精确匹配、最多 8 个、合计不超过 150,000 字节、Markdown 链接不超过 64 条,超限整份跳过 |
两个被疯传的数字,引用前先看清出处
- 「任务成功率最多高 10 个点」:出自 2026-04 Claude Managed Agents 发布文,是结构化文件生成任务的内部测试——单独的评分 agent 按 rubric 检查结果,对比普通提示词循环,难题上提升最大。这不是 Claude Code 团队在自己代码库上测的。
- 「结果好两到三倍」:Claude Code 创建者 Boris Cherny 的个人估计,原话就是估计口径。
- 39 条清单、verify skill、REVIEW.md、提交闸门:原文没有给任何故障率、误拦率之类的数字,闸门的具体实现也没公开。别把「90% 代码由 AI 写」直接等价成「AI 写的代码质量没问题」,等价的前提是整套验证链路在跑。
什么项目别照搬:三类劝退边界
- 一次性脚本和纯原型:验证链路本身要维护(SKILL.md、REVIEW.md、清单都要定期清理),跑完就删的项目不值得配。
- 没有可运行入口的纯库:/verify 推断不了「没有 demo、没有启动命令」的项目,先补一个能跑起来的入口再谈验证。
- 分支保护形同虚设的团队:降级、排除、Nit 上限三类指令要默认分支受保护才执行,没有保护习惯的团队等于白写,先去把分支保护开了。
反过来,最划算的场景是:有明确启动入口的 web / 后端 / 桌面项目、单人或两三人小团队、以及想同时带多个 Claude 干活的人。相关的配套做法之前写过两篇可以一起用:AGENTS.md 三层知识库解决「换个 agent 就得从头交代项目」,危险命令闸解决「验证通过但手滑删库」——验证闭环管对错,命令闸管安全,两层不冲突。
写在最后
这套流程的终点,是把人的工作从「逐行读 diff」变成「定义什么叫做完,然后检查证据」——这也是一个人能同时带几十个 Claude 的前提。落地不用一口气吃完:先用一个下午把 /verify 配出来、SKILL.md 提交进仓库,其余的按投入从小到大慢慢加。
你的项目卡在哪一步?是 /verify 推断不出启动方式,还是 flaky 测试把 Claude 教坏了?评论区报一下项目类型和 Claude Code 版本,我帮你看配置。
登录后可点赞、收藏与反馈。


