USB4 多机拼算力跑 235B:18.5 tok/s 实测,门槛不在内存在你的 USB4 口
微软 RDMA over USB4 预览拆解:三台 128GB 跑 235B 拿到 18.5 tok/s,但每台机要 N−1 个 USB4 口、测试签名得关 Secure Boot,ND 起不来还会静默退回 TCP。
11 月 19 日微软放出的 RDMA over USB4 开发者预览,一晚上被转成了「两台电脑插根线就能跑 235B」。真去翻自己那两台机器的人,多半先撞上三件不写在标题里的事:Windows 侧那个 Build 还标着 coming soon,第二台机器没有第二个 USB4 口,开了测试签名得先把 Secure Boot 关掉。
这条路是真的。微软实验室里三台各 128GB 统一内存的锐龙 AI Max 迷你主机,40Gbps USB4 全互联,跑 4 位量化的 Qwen3-235B-A22B,解码 18.5 tok/s;AMD 自测 21.98 tok/s,提示词处理 117.98 tok/s。Intel 用四台 64GB 的酷睿 Ultra 系列 3 跑 GPT-OSS-120B,1K 上下文 54.2 tok/s,首个 token 1.2 秒。
但把数字抄进购物清单之前,先算三笔账:内存、端口、拓扑。三笔里有两笔跟预算无关,跟你机箱后面有几个 USB4 口有关。下面按「能跑多大 → 要几个口 → 现在能不能装 → 六步开起来 → 怎么确认真的走了 RDMA」拆,末尾一张报错对照表。
先算能跑多大:4 位权重不是把内存加起来就行
GGUF 的 Q4_K_M 大约 0.55~0.6 字节/参数,含量化缩放和少量保留精度的层。按这个口径粗算:120B 约 66GB,235B 约 130GB。这是算术,不是官方数字,实际大小以模型仓库里的文件为准。
真正会翻车的是「合计内存」这个算法。三台 64GB 不是 192GB 可用:每台要留操作系统、驱动、运行时和 Windows 的提交余量;张量并行按层切,切完每台的份额要能装进它自己的内存,最先崩的永远是最小的那台。
| 集群 | 合计内存 | 扣掉系统与运行时 | 4 位权重能装下的量级 | 现实结论 |
|---|---|---|---|---|
| 2×32GB | 64GB | 约 54GB | 70B 级(约 40GB) | 120B 别想,容量和余量都不够 |
| 3×32GB | 96GB | 约 84GB | 120B 容量上勉强 | 官方没有这一档实测,不建议赌 |
| 2×64GB | 128GB | 约 116GB | 120B 容量够 | 官方只公布了 3 台和 4 台的数字 |
| 3×64GB | 192GB | 约 176GB | 120B 宽裕 | Intel 同款配置 |
| 3×128GB | 384GB | 约 360GB | 235B | 微软与 AMD 同款配置 |
还有一层:最慢的那台决定整体速度。每生成一个 token,所有机器都要同步交换一次数据,快的只能等着。所以别拿 128GB 主力机配一台 32GB 旧本凑数——省下的钱会变成等待时间。
选模型也有讲究。官方演示的两个都是 MoE:Qwen3-235B-A22B 每 token 只激活 22B,GPT-OSS-120B 只激活 5.1B。稠密模型切张量并行,每层都要 all-reduce,通信量跟着激活参数涨;MoE 每 token 只过一部分专家,跨机交换少得多。在这类拼机上,先挑 MoE,再挑稠密,这条比看总参数重要。
决定集群规模的是 USB4 口数量,不是内存
官方给的门槛很硬:N 台机器,每台要 N−1 个 USB4 口;每两台之间一根线直连,全互联,不要菊花链。三台集群就是三角形三条边,每台两个口。
| 集群 | 每台要几个口 | 需要几根线 | 拓扑 | 现实里谁有 |
|---|---|---|---|---|
| 2 台 | 1 | 1 | 点对点 | 绝大多数带 USB4 的轻薄本 |
| 3 台 | 2 | 3 | 三角形全互联 | 两个 USB4 口的迷你主机 |
| 4 台 | 3 | 6 | 四面体全互联 | 基本要工作站主板 |
这条直接筛掉了大部分轻薄本:它们只有一个雷电/USB4 口,插上充电器或扩展坞就没了。想上三台,得有像锐龙 AI Max 那批迷你主机一样带两个口的机器。
扩展坞不算。官方描述是「由 Windows 管理的 USB4 口 + 每对直连」,扩展坞串出来的口既不是直连,也绕不开菊花链那条禁令。买线之前先数口,这比看内存重要。
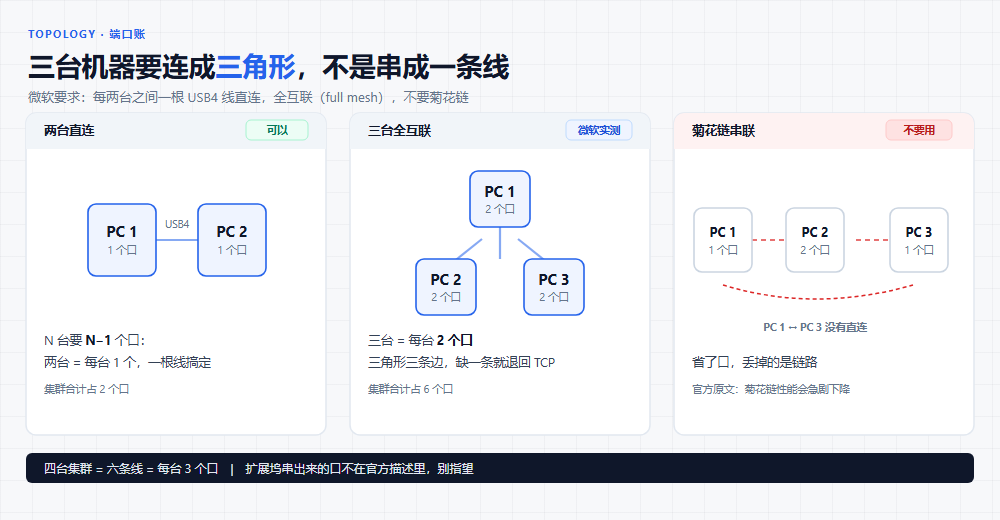
菊花链为什么不行?PC 1 和 PC 3 之间没有直连,张量并行要交换的数据得从中间那台转一手,延迟直接翻倍。官方原话是性能会急剧下降,实测配置里也没给菊花链留位置。
现在到底能不能装:三样东西的到位时间不一样
- Windows Build:截至 11 月 20 日仍标着 coming soon,要 Windows Insider 的 Experimental 通道(Future Platforms)。官方说未来几周更新博客补安装步骤。
- NetworkDirect provider:已开源,含示例代码和链路测试工具。
- llama.cpp 分支:已开源,仓库是
microsoft/llama.cpp-nd-usb4,注意默认分支是master不是main。
所以这个时点能做的三件事很明确:编译、读代码、把拓扑和线材备好。真要跑通,得等那个 Build。
判断别人是不是真跑通,有个土办法:让他贴两样东西——Windows 版本号,和每台机器上的 NetworkDirect activated: 日志。仓库里验证过的组合是 Windows 29704.1002 配 NetworkDirect provider 的 d93ad88 提交。只贴一张「HTTP 200」的截图,说明不了任何事。
六步开起来:注册表、测试签名、静态 IP、ndping、编译、起服务
第一步:打开跨域 RDMA 开关
管理员命令提示符执行,然后重启:
reg add HKLM\SYSTEM\CurrentControlSet\Services\Usb4HostRouter\Parameters /v EnableInterDomainRdma /t REG_DWORD /d 1 /f这是官方给的唯一开关,默认关闭。没有它,USB4 那条链路只是普通的主机间网络。
第二步:开测试签名,代价是关掉 Secure Boot
bcdedit /set testsigning on测试签名和 Secure Boot 互斥,得进固件把 Secure Boot 关掉。跑完预览再改回来:
bcdedit /set testsigning off这一条决定了别拿日常主力机试。官方在「已知限制」里写得很直接:预览需要测试签名,请用专门的测试机,而不是你天天用的那台。
第三步:全互联接线
三台三根线,每两台之间一根,不要串成一条链。线材走 40Gbps 就够;80Gbps(雷电 5)延迟一样、带宽翻倍,长上下文提示词会快一些,但不改变能不能跑。
第四步:每个 USB4 网卡配静态 IPv4,每对连接一个子网
不要用 DHCP。三台的示例:1↔2 走 10.10.12.0/24,1↔3 走 10.10.13.0/24,2↔3 走 10.10.23.0/24。同一对的两端在同一子网,不同对不要挤在一个网段,否则路由会把流量带回错误的网卡。
第五步:ndping 逐条验链路
provider 仓库自带链路测试工具。三台机器三条链路,每条都要单独打一次——一条不通,那对机器之间的层就只能走 TCP,而它不会报错。
第六步:编译带 ND 的 llama.cpp,再起 worker 和 coordinator
git clone https://github.com/microsoft/llama.cpp-nd-usb4.git
cd llama.cpp-nd-usb4
cmake -S . -B build-nd -DGGML_RPC=ON -DGGML_RPC_ND=ON \
  -DGGML_RPC_ND_SDK=C:/sdk/NetworkDirect \
  -DGGML_VULKAN=ON -DLLAMA_OPENSSL=OFF
cmake --build build-nd --config Release \
  --target llama-server ggml-rpc-server --parallel 4
两个前提别漏:NetworkDirect SDK 要先拉源码,它只是编译依赖,不是驱动;上游的安装包和 release 里没有这些功能,必须自己编。
worker 端,每台机器各起一个:
ggml-rpc-server.exe -H 10.10.12.2 -p 50052coordinator 端:
llama-server.exe -m Qwen3-235B-A22B-Q4_K_M-00001-of-00003.gguf \
  --rpc 10.10.12.2:50052,10.10.13.2:50052 \
--split-mode tensor --tensor-split 1,1,1 -ngl 999模型是多分片的话,-m 只传第一个分片,其余同目录自动找。所有机器必须部署同一份二进制:这个分支的私有 RPC 协议是 128.4.0 / NDBOUND2,跟上游 v10 不兼容,混版本会直接失败。
最阴的一步:ND 没起来,它会静默退回 TCP
没有安装 NetworkDirect provider,或者适配器打不开,两端会静默留在 TCP 上。启动成功、TCP 握手成功,都不能证明 ND 激活了。
—— microsoft/llama.cpp-nd-usb4 仓库文档
这段话是整份文档里最该被截图转发的一段。表现是:服务起来了、HTTP 200、token 也在出,只是速度跟单机差不多。你以为在跑 RDMA,其实数据走的是同一根线上的 TCP。
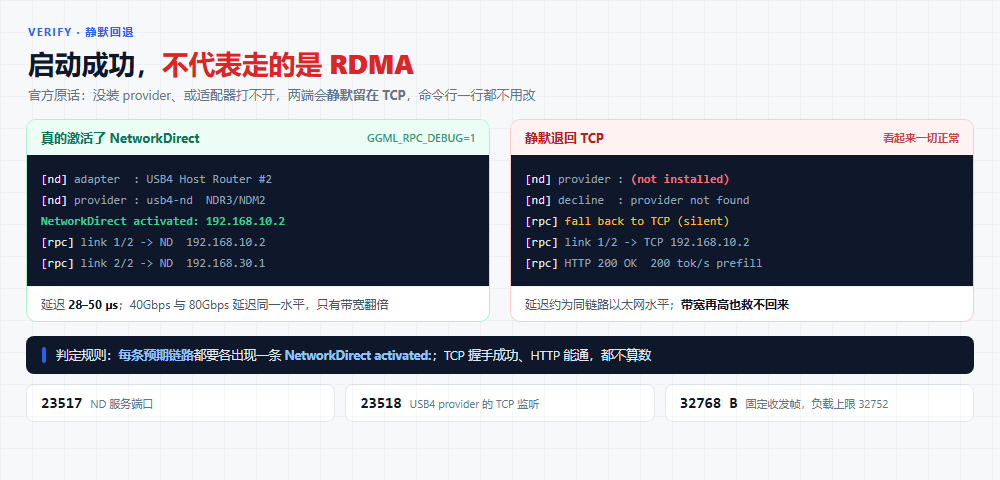
判定标准只有一条:每条预期链路各出现一次 NetworkDirect activated:。三台机器三条链路,就是每台机器上两条。只看到一两条,说明剩下的在走 TCP。
三个必查项
- GGML_ND_ADDR:RDMA 网卡和 TCP 网卡不是同一张时,两端都要把它设成 RDMA 网卡的 IPv4,否则握手会在错的网卡上挑路。
- GGML_RPC_DEBUG=1:两端都设;客户端还要加
-lv 5,不然这些日志会被全局日志级别过滤掉,等于没开。 - 协议版本:全机同一提交、同一二进制。128.4.0 / NDBOUND2 与 128.3.3 / NDBOUND1 无法互联,报错里不会告诉你版本号。
另外两个数字先记住:ND 服务端口 23517,USB4 provider 的连接管理监听在 23518。防火墙要放行的是这两个,别为了省事整套关掉——RPC 链路没有认证,官方明确要求只绑在可信网络的指定网卡上。
常见翻车报错与急救清单
| 现象 | 真实原因 | 怎么救 |
|---|---|---|
| 服务正常、token 在出,速度跟单机差不多 | ND 没激活,静默走了 TCP | 查 NetworkDirect activated:;设 GGML_ND_ADDR 后重启两端 |
| 两端日志里一条 activated 都没有 | provider 没装,或版本与内核不匹配 | 装对应版本 provider,先跑 ndping 确认链路 |
| 三台机器只看到两条 activated | PC 1↔PC 3 那条没接,或不在一张网 | 补线、补静态 IP,不能靠中间那台转发 |
| 换成 80Gbps 线,tok/s 没涨 | 瓶颈是延迟不是带宽 | 别再换线;查拓扑是否全互联、worker 数是否对 |
| 开机报 Secure Boot 错,系统进不去 | 测试签名与 Secure Boot 冲突 | 固件里关 Secure Boot;或换一台测试机 |
| 生成到一半断了,任务直接失败 | 传输层不重试,链路掉了就掉 | 应用侧重连;长任务切段,别指望它自愈 |
| 加载模型时内存耗尽 | 上下文开太大,或每台分到的层超出余量 | 降 -c、减层数、换更小的模型 |
| 两端版本不一致,握手直接失败 | RPC 协议 128.4.0 / NDBOUND2 不兼容旧版 | 全机部署同一份 build,校验 SHA256 |
三类人劝退边界
写完流程,得说清楚这活不该谁干。
- 只有一个 USB4 口的轻薄本:两台是你的人身上限。两台 32GB 合计 64GB,最多到 70B 级,120B 在容量上就不够。这个收益不如直接用单机 NPU 或核显,那条路的坑我在锐龙 AI 薄本跑本地智能体:卡人的不是显存,是驱动和内存里拆过。
- 日常主力机:测试签名要关 Secure Boot,传输层不重试,RPC 无认证。这三条里任何一条都不适合放在天天用的机器上。
- 要 7×24 稳定推理:这是开发者预览,不是生产方案。同样的钱租卡更省心,续约前该算的账在GPU 租金涨了:Hopper 续约最高翻倍,中小团队续约前先做这四步里。
反过来说,谁适合现在动手:手上有 2~3 台同规格、带两个 USB4 口的统一内存迷你主机,愿意自己编译,跑的是离线批处理或长任务,不怕中途断链重来。这批人现在就可以把拓扑、线材、编译环境备好,等 Build 一发就能上。
最后把口径钉死:18.5 tok/s 是微软实验室的数字,AMD 自测在 22 左右,两者都跑在 4 位量化、特定上下文长度上。仓库里那段历史成绩写的是 1655 输入 / 128 输出 token、不含预热、不复用提示词缓存,并明确说合并进新上游后要重新验证。功耗、噪音、两台机器跑 120B 的表现,官方一个字都没给。
单机那条路的坑在驱动和内存,不在显卡型号;多机这条路的坑换成了端口和拓扑。两条路的共同点是:广告里的数字都能复现,但你得先满足它没写的那些条件。
你手里是几台什么机器、每台几个 USB4 口?把配置和卡住的那一步写在评论区,我按拓扑帮你算这一组到底能不能拼、能拼到多大。
登录后可点赞、收藏与反馈。


