257 集视频教程做成 Agent Skill:SKILL.md 只留一万字,其余拆进 14 个文件
257 集视频字幕做成一个 Agent Skill:SKILL.md 只留 1 万字判断顺序,其余 5.6 万字拆进 14 个按需文件。两个脚本的逐行注释、两种流派的取舍表、八条翻车急救都在这里。
11 月 20 日,IT之家报道了一个叫 sakurai-skill 的仓库:日本开发者 kociden 把樱井政博 YouTube 频道《桜井政博のゲーム作るには》全 257 集本編的字幕,做成了一个 Agent Skill。仓库 11 月 12 日建,到报道这天已经 490 star、43 fork。
值得抄的不是「樱井」,是它的目录结构。SKILL.md 只有 10,099 字符,剩下 5.6 万字拆进 references/ 的 14 个文件,模型每次只读其中一个。而全网教程都在教你「新建 SKILL.md,把规则一条条写进去」——素材一多,这条路当场断:单文件塞不下,硬塞进去模型抓不到重点,每次触发先把六万字拖进上下文。
下面把它拆成可复制的五步:字幕怎么洗、编号为什么必须先定死、分类怎么自动分文件、SKILL.md 里到底该留什么,外加八条翻车急救。你手里的 B 站合集、公众号专栏、内部 SOP 都能套。
一个 SKILL.md 装下全部,素材一多就断
Agent Skills 的加载分三级,这决定了文件该怎么切:启动时只把每个技能的 name 和 description 放进系统提示;模型判断「这次相关」,才把整份 SKILL.md 读进上下文;SKILL.md 里点名的附加文件,模型按需自己走去读。
Anthropic 那篇讲 Agent Skills 的工程博客把第三级说得直白:附加文件让「能打包进技能的上下文量实际上是无限的」。但无限有个前提——前两级必须小。把 257 集全写进 SKILL.md,等于把按需检索改成每次全量加载。
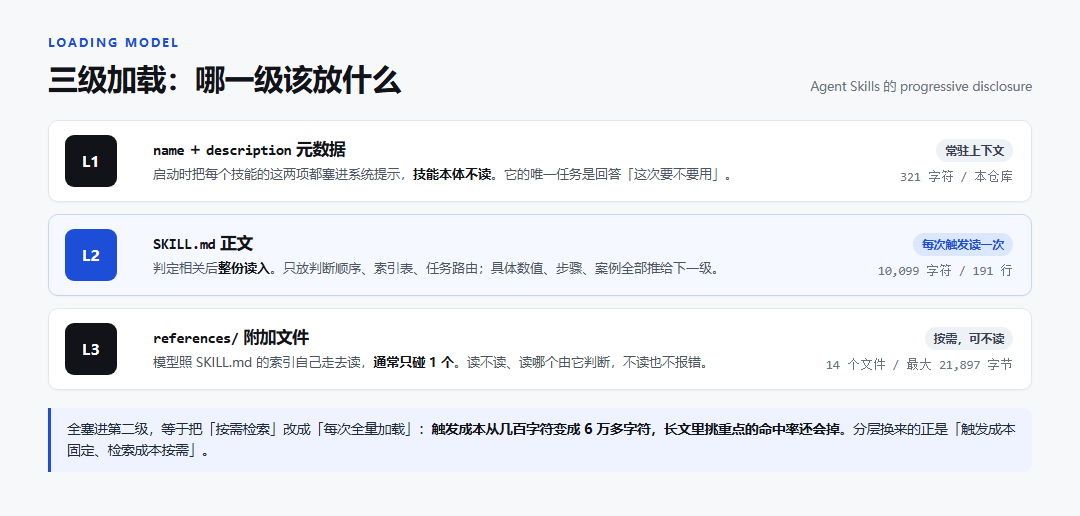
一份六万字的 SKILL.md 带来的不是「知识更全」,是三个具体后果:
- 触发成本固定抬高:只要判定相关就整份读进去,哪怕你只问一句「跳跃手感怎么调」。
- 注意力被摊薄:正文里九成是和你当前问题无关的集数,模型在长文里挑重点的命中率会掉。
- 改一处要重读全文:补一集新内容,SKILL.md 变长一截,之前调好的结构和语气全被打乱。
判断标准只有一条:SKILL.md 是目录和判断顺序,不是资料本体。本体放 references,让模型自己走去拿。
成品解剖:10,099 字符的正文和 14 个文件
把仓库 clone 下来数一遍,wc -m 和 grep -c 就能复现:
| 项目 | 实测值 | 说明 |
|---|---|---|
| SKILL.md | 10,099 字符 / 27,265 字节 / 191 行 | 14 章判断顺序 + 14 行索引表 + 任务路由 |
| description | 321 字符 | 把「什么时候用」写满,含用户原话 |
| references/ | 14 个文件,合计 56,162 字符 / 157,339 字节 | 按分类拆,条目带视频通号 |
| 带编号的要点 | 248 条 | 格式为 ## 006 标题【分类】 |
| 最大单文件 | gameplay.md,29 条 / 21,897 字节 | 游戏性、难度、奖励 |
| 最小单文件 | tech.md,8 条 / 5,642 字节 | 参数外置、调试模式 |
两个数字要纠正,你照抄时会踩:
一是「2.7 万字」不成立。README 写 SKILL.md 约 2.7 万字,但 27,265 是字节数,按字符算是 10,099——日文一个字符占 3 字节,作者把字节当字了。不影响使用,但你拿字节数去估 token 会差三倍。
二是 248 条不等于 257 集。14 个 references 里以 ## 数字 开头的条目一共 248 条,比本編集数少 9 条。这套流程允许摘要取舍,不追求一集不漏;要求全覆盖的话,得自己加一个「编号连续性校验」脚本。
两个流派:24 个技能,还是 1 个技能 + 14 个 references
同一批素材还有另一个仓库 kokuren333/Sakurai-Skills,比 kociden 早一个多月发布,方向完全相反:
| 维度 | kokuren333(体系派) | kociden(轻量派) |
|---|---|---|
| 技能数量 | 24 个任务技能 + 路由 | 1 个 |
| 条目组织 | 177 条衍生原则 + catalog.json(825 KB)+ 17 份清单 + 6 个测试 | 248 条要点平铺进 14 个 md |
| 溯源方式 | 原文 / 泛化 / 推演三层标记 | 每条带视频通号 001–259 |
| 语言 | 英语为主 | 日语 |
| 文件数 | 287 个 | 28 个 |
| Star(11-20) | 10 | 490 |
怎么选:个人随手问、只要一个能加载的顾问,选轻量派——改起来只动一个目录,模型读一次就够;团队要把评审固化成工序,选体系派——24 个技能按阶段单独触发,还有清单和测试兜底。
Star 差距别当质量结论。kociden 在 X 上发了一条 100 秒演示,样例游戏能直接在网页里玩,传播效率本来就高一个量级。选型看使用场景,不看 star。
第一步:把字幕洗成「一集一段」
仓库的输入约定有三个:tools/list.tsv(视频 id、标题、时长)、tools/raw/{vid}.ja-orig.srv1(YouTube 字幕 XML)、一个输出目录。清洗脚本的核心就这些:
for i, vid in enumerate(order):
    if "まとめ" in titles[vid][0]:      # 跳过「总结」类合集
        continue
    n += 1                              # 编号写在判断之外:缺字幕也占号
    ...
    xml = f.read_text(encoding="utf-8")
    parts = [html.unescape(html.unescape(t))
             for t in re.findall(r"<text[^>]*>(.*?)</text>", xml, re.S)]
    body = "".join(p.replace("\n", "").strip() for p in parts)
    body = re.sub(r"\[[^\]]*\]", "", body)   # 去掉 [音楽] [拍手]
    body = re.sub(r"\s+", " ", body)
    (out_dir / f"{n:03d}_{vid}.txt").write_text(...)
三个细节决定成败:
- unescape 两次:YouTube 字幕是转义过两层的,少解一次就会留下
'这类残渣,摘要里全是乱码。 - 一集压成一段:去掉时间戳和换行,257 集变成一份连续文本。比带时间轴的 srt 省一大截 token,摘要也更容易抓主线。
- 别上 Whisper:官方或自动字幕已经有了,257 次转写又慢又没必要;确实没字幕的集,脚本往 stderr 打一行日志,别静默跳过。
第二步:编号先定死,再写摘要
上面代码里 n += 1 的位置,是整套流程最容易被改坏的一行——它在「有没有字幕」判断的外面。这一集没字幕,也照样占一个号。
反过来做(先筛出有字幕的,再按顺序编号)会怎样:三个月后补到一集旧视频,前面所有编号整体后移,你写过的「参见 #006」全部指向别的视频,而且是静默错位,不报错、不报警。作者在注释里专门写了「番号を固定する」,就是防这个。
编号定了,摘要格式也要定死,一条只放一个判断:
## 006 リスクとリターン【ゲーム性】
- ゲーム性=駆け引き=リスクとリターン。…
- 例(マリオ):敵に近づくほどリスク増、ジャンプ踏みで初めてリターン。…
这一行同时干三件事:给人看、给下一步的分类脚本当锚点、给模型当引用凭据。正文 3 到 8 条,每条必须落到具体数值、作品名或操作——写成「要重视手感」这种形容词,等于没写。
第三步:让脚本按【分类】把摘要分文件
257 集摘要不可能手动摆进 14 个文件。build_refs.py 干四件事:按编号切块、去重、读标题里的【分类】映射到文件名、排序写盘。
CATS = {"ゲーム性": ("gameplay", "…"), "企画・ゲーム設計": ("planning", "…"), …}
blocks = re.split(r"(?m)^(?=## \d{3} )", text)   # 前瞻断言切块,标题不被吞掉
for b in blocks:
    m = re.match(r"## (\d{3}) (.*)", b)
    num, title = m.groups()
    if num in seen: continue                    # 同一集多份笔记:留先出现的
    seen.add(num)
    key = CATS.get(re.search(r"【(.+?)】", title).group(1)) or MISC
groups.setdefault(key, []).append((num, b))两个设计值得照搬:兜底分类——对不上任何分类、或标注「知见少」的进 misc,脚本不会崩;先到先得去重——同一集被两次摘要时保留第一份,references 里不会出现重复编号。
分类一共 13 个加 1 个 misc,这个数量不是随手定的:模型一次只读一两个文件,分类太多等于让它猜。
第四步:SKILL.md 里只留判断顺序和索引表
打开那份 191 行的正文,结构极简:frontmatter 只放 name 和 321 字符的 description;接着一张 14 行索引表,每行是「文件名 + 里面有什么」;再往下 14 章原则摘要,每章 5 到 10 条判断句;最后一节「使い方」,把常见任务映射到章节。
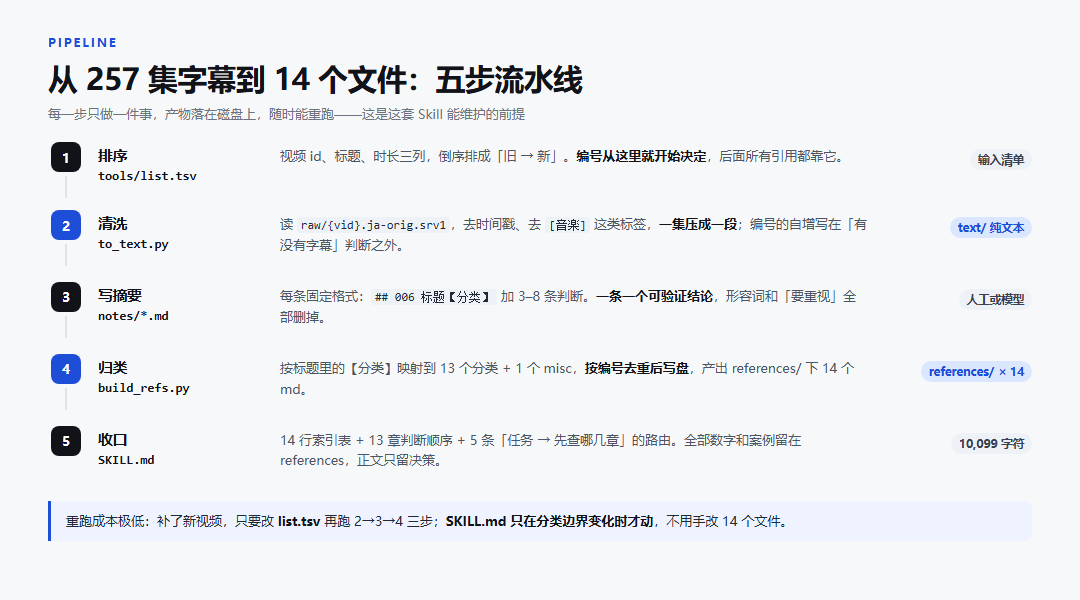
最后那节最容易被忽略。它写的是排查顺序,比如「被说手感弱 → 先查 hitstop,再查 hitmark、音头、画面震动」,并标注哪些情况才需要去翻 references。没有这一节,模型读完 14 章会平均用力;有了它,模型知道先查哪三章。
索引表旁边还有一句必须写的话:全部を読まない。必要なカテゴリだけ(别全读,只读需要的分类)。这不是给人看的礼貌提醒,是给模型的显式约束。
第五步:description 要写用户的原话
321 个字符里,作者把使用者可能说出口的抱怨全列了:面白くない、手応えがない、もっさり、地味、難しすぎ / 簡単すぎ、遊ばれない,末尾还加一句「有人说『桜井さんならどうする』时必用」。
因为第一级只加载 metadata,触发与否全看这段字。写成「游戏设计原则合集」,只有用户说出「游戏设计」才会命中;写成上面那样,用户抱怨「这个跳跃很飘」也能命中。中文场景照搬这个思路:把「太塑料」「像 PPT」「点半天没反应」塞进去,比堆术语有用。
规范上限是 name 不超过 64 字符、description 不超过 1024 字符,321 离上限还远——不是让你写长,是让你把场景写满。触发率的排查清单在《Agent Skill 装了不触发:九成卡在 description》里已经拆过。
换你的素材:三条路线
| 素材类型 | 清洗方式 | 编号规则 |
|---|---|---|
| B 站 / YouTube 合集 | 官方或自动字幕(srv1、vtt)→ 去时间戳、去 [音楽] 类标签 | 按发布顺序 001–NNN |
| 公众号 / 专栏 | 导出 markdown,一篇一节 | 按发布时间,或「年-月-序号」 |
| 内部 SOP / PDF 手册 | 按章节切,保留原章节号 | 章-节,如 3.2.1 |
三条路线的共同点只有一句:先把编号规则写死,再动摘要。编号是这套东西的身份证,改一次全库失效。
两个经验值:素材低于 3 万字(约 30 集视频、50 篇短文)别分层,单文件就够,分层是过度设计;分类控制在 15 个以内,超过就该合并。项目级记忆怎么分层,可以接着看《换个 Agent 就得从头交代项目?AGENTS.md 三层知识库》。
常见翻车与急救清单
| 现象 | 大概率原因 | 处理 |
|---|---|---|
| 装了技能但不触发 | description 只写主题,没写场景 | 把用户原话、报错词、同义抱怨补进去 |
| 触发了但答得空泛 | SKILL.md 里堆了资料本体,没有判断顺序 | 正文只留结论与取舍,数值推给 references |
| 一次把 14 个文件全读了 | 索引表只写文件名,没写边界 | 每行补「什么时候读它、什么时候不用」 |
| 编号整体错位 | 编号在过滤之后才自增 | 自增语句放到过滤之外,缺集也占号 |
| references 出现重复条目 | 多份笔记合并时没去重 | 按编号做集合去重,先到先得 |
| 摘要全是形容词 | 没约束每条带数值 | 模板写死「一条一个可验证判断」 |
| 中日混排后引用对不上 | 标题翻译了,编号没对齐 | 标题保留原文,摘要用自己的语言 |
| 想商用被版权拦住 | 非官方 fan-made、仓库无 LICENSE、内容是 AI 摘要 | 先只自用;对外发布前确认授权 |
这套做法的边界
三类场景劝退:
- 素材不到 3 万字:一个 SKILL.md 装得下,分层只会多出读文件的往返。
- 需要逐字引用、法务或合规场景:中间层是 AI 摘要,会失真,不能当原文。仓库自己在 README 里也写明「内容是 AI 摘要,不是樱井本人发言」。
- 客户端没有文件读取能力:references 靠模型主动读文件,纯聊天窗口、不能访问目录的客户端用不上这套结构。
还有一个成本要认:分层换来按需加载,代价是模型可能不去读。索引表写得含糊,它就直接拿 SKILL.md 里的摘要回答,答案停在「有道理但没细节」。这也是为什么第四步那张表比正文更重要。
样例游戏是个不错的旁证:作者让另一个 Agent 拿着这套技能评审自己做的 Godot 游戏,出了 13 条带视频编号的修改意见,采纳了 11 条。能指回第几集,才是这套结构真正的价值。
回到开头:这份仓库值得抄的不是樱井的方法论,而是大素材怎么变成可检索的技能——一集一段、编号先定、分类分文件、正文只留索引和判断顺序。257 集能拿到 490 star,靠的是这份结构。
你手里准备做成 Skill 的素材是多少集、多少篇?卡在清洗字幕、编号错位还是压根不触发——评论区报素材类型和数量,我按这五步帮你排一遍。
登录后可点赞、收藏与反馈。


