个人学习小站
SIGNAL DESK
2026
LIVE
--:--:--
反馈
首页
/
KV cache
全部
AI模型
人工智能
SEO优化
灵感&想法
Tag
#KV cache
共 1 篇内容
tag
长上下文
本地部署
vLLM
人工智能
11-22
3 小时前
约 16 分钟
8 阅读
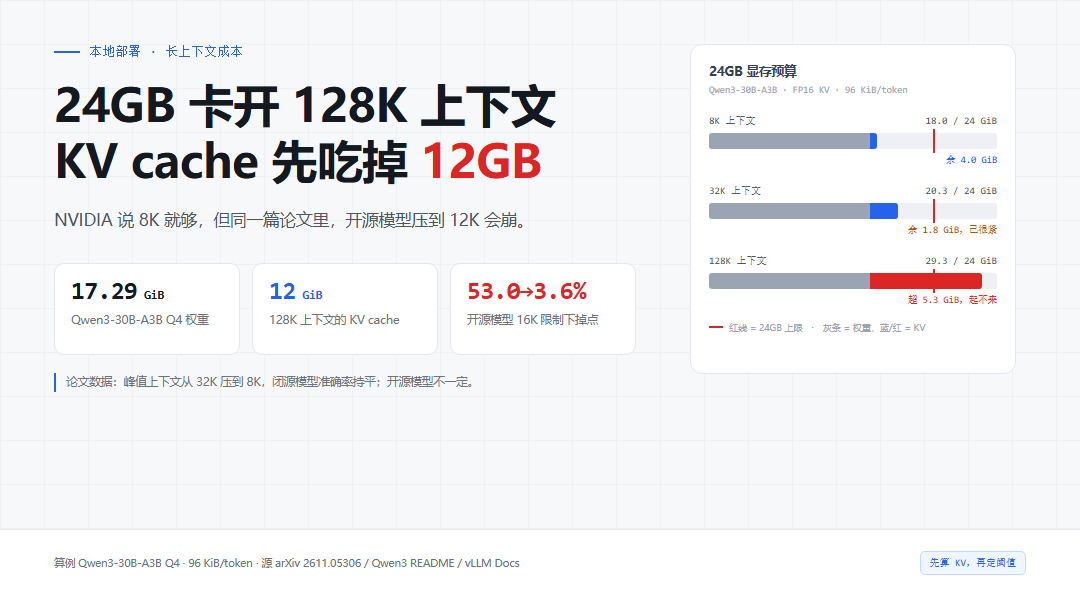
24GB 单卡开 128K:KV cache 先吃掉 12GB,压缩阈值别照抄 12K
按 Qwen3-30B-A3B 的 config.json 算清 24GB 卡的 KV cache 上限,再给 vLLM / llama.cpp / Ollama 的阈值与 11 条报错急救。