24GB 单卡开 128K:KV cache 先吃掉 12GB,压缩阈值别照抄 12K
按 Qwen3-30B-A3B 的 config.json 算清 24GB 卡的 KV cache 上限,再给 vLLM / llama.cpp / Ollama 的阈值与 11 条报错急救。
你搜「vLLM 128K 上下文」,前十条教程都会让你把 --max-model-len 写成 131072。照抄的人,很多会在启动阶段撞上一行 ValueError:权重装下了,KV cache 装不下。
更反常识的是,NVIDIA 研究团队 11 月 3 日挂上 arXiv 的《You don't need long context》说:把上下文从 128K 压到 8K,闭源前沿模型的准确率几乎不变,单 token 生成成本还能降 3.6–7 倍。但同一篇论文的附录里,Qwen3 Coder Next 在 16K 限制下从 53.0% 掉到 3.6%——照抄 12K 压缩,本地开源模型可能直接崩。
这篇不站队。只做一件事:按你手上的 24GB 卡,把「能开多长」算清楚,再给一套 vLLM / llama.cpp / Ollama 都能落地的阈值与急救清单。算例用 Qwen3-30B-A3B,所有数字都能拿 config.json 复算;论文的吞吐与准确率数字,则明确标为作者在 H100 与 DGX Spark 上的测量。
为什么 24GB 卡开 128K 会直接起不来?先算 KV cache
模型卡上的 128K 是「训练时见过」,不是「你的卡装得下」。推理时显存要同时放三样东西:权重、KV cache、激活与运行时开销。权重是固定值,KV cache 随上下文线性增长,后者才是长上下文真正的账单。
每个 token 的 KV cache 大小,只由四个参数决定:层数、KV 头数、头维、精度。公式不复杂:
KV bytes/token = 2 × 层数 × KV 头数 × 头维 × 每元素字节数
# 2 是 K 和 V 两份;FP16 每元素 2 字节,FP8 是 1 字节
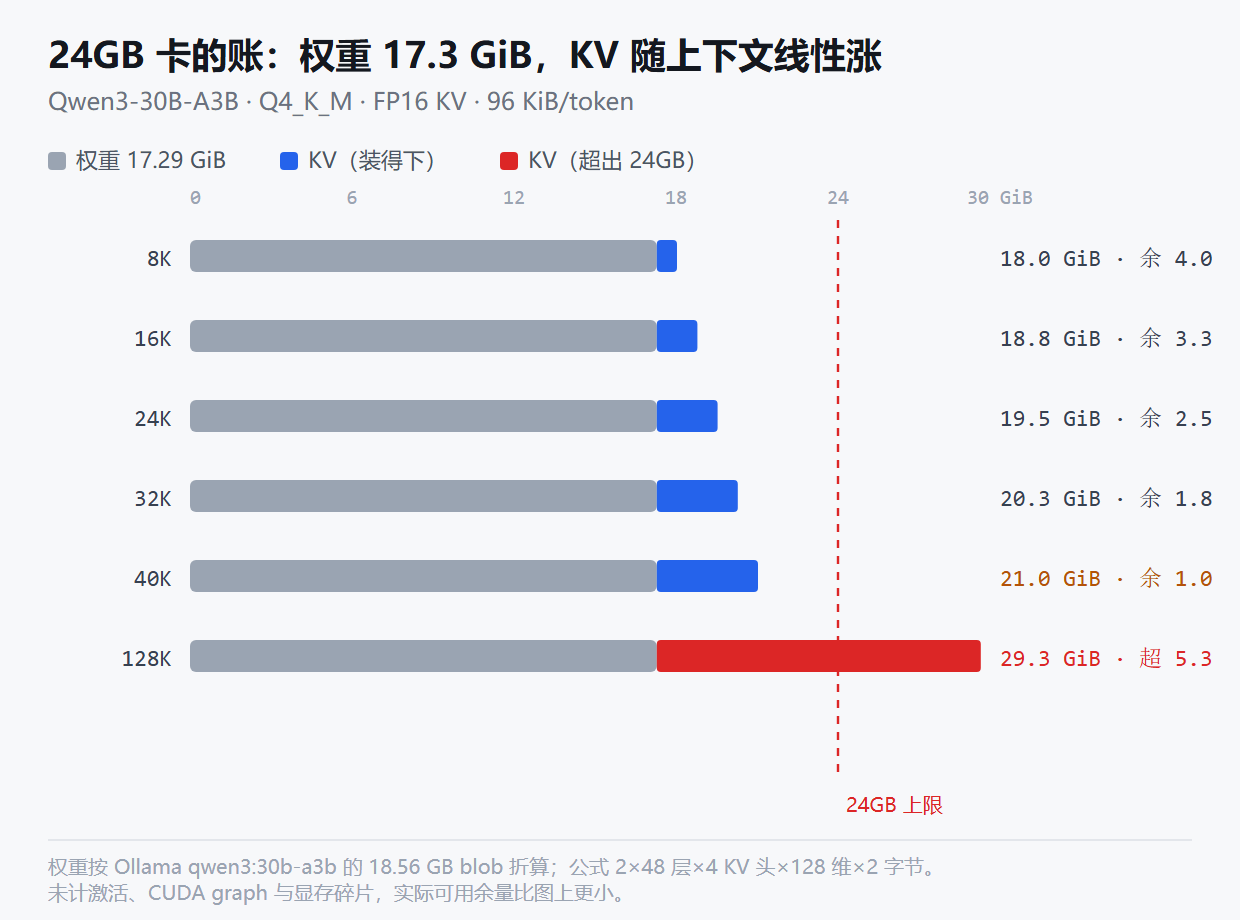
拿 Qwen3-30B-A3B 举例。它的 config.json 写得很清楚:48 层、4 个 KV 头、头维 128。代入公式,FP16 下每个 token 是 96 KiB。这个数字乘上上下文长度,就是 KV cache 的硬开销:
import json
cfg = json.load(open("config.json"))
L, kvh, hd = cfg["num_hidden_layers"], cfg["num_key_value_heads"], cfg["head_dim"]
per_token = 2 * L * kvh * hd * 2          # K/V × 48 层 × 4 头 × 128 维 × 2 字节
for n in (8192, 32768, 131072):
    print(n, round(per_token * n / 1073741824, 2), "GiB")  # 1073741824 = 1024^3
# 8192 0.75 GiB / 32768 3.0 GiB / 131072 12.0 GiB
再看权重。Ollama 的 qwen3:30b-a3b 模型 blob 是 18.56 GB,折算 17.29 GiB。一张 24GB 卡按 vLLM 常用的 --gpu-memory-utilization 0.92 算,可用预算是 22.08 GiB。把权重和不同上下文的 KV 加起来:
| 上下文 | KV(FP16) | 权重 + KV | 22.08 GiB 预算下余量 |
|---|---|---|---|
| 8K | 0.75 GiB | 18.04 GiB | 4.04 GiB |
| 16K | 1.50 GiB | 18.79 GiB | 3.29 GiB |
| 24K | 2.25 GiB | 19.54 GiB | 2.54 GiB |
| 32K | 3.00 GiB | 20.29 GiB | 1.79 GiB |
| 40,960 | 3.75 GiB | 21.04 GiB | 1.04 GiB |
| 65,536 | 6.00 GiB | 23.29 GiB | −1.21 GiB |
| 131,072 | 12.00 GiB | 29.29 GiB | −7.21 GiB |
128K 不是「慢一点」,是总量直接超了 7 GiB。 表里最后两列的余量还没扣激活、CUDA graph 和显存碎片;余量掉到 1 GiB 以下,基本等于起不来,或者一起来就在 warmup 阶段 OOM。
vLLM 会在启动时做一次 sanity check。老版本 V0 的报错原文是:
ValueError: The model's max seq len (4096) is larger than the maximum number of
tokens that can be stored in KV cache (3584). Try increasing gpu_memory_utilization
or decreasing max_model_len when initializing the engine.
新版本会算得更细,直接把「一个满长请求需要多少 KV」和「实际剩多少」都打出来:
ValueError: To serve at least one request with the model's max seq len (100352),
(3.21 GiB KV cache is needed, which is larger than the available KV cache memory
(3.06 GiB). Try increasing `gpu_memory_utilization` or decreasing `max_model_len` ...看到这行不要先怀疑驱动。它说的是预算问题:要么把 --max-model-len 降下来,要么把更多显存让给 KV,要么换更省 KV 的模型。三条路,后文逐条给命令。
同样 24GB,为什么 8B 模型的 KV 比 30B MoE 还大?
很多人以为「参数越小,上下文越省」。这只对权重成立。KV cache 看的是层数、KV 头数、头维,以及一个容易被忽略的字段:layer_types——有多少层是真正的全注意力。
| 模型 | 全注意力层 | KV/token | 128K KV |
|---|---|---|---|
| Qwen3-30B-A3B | 48 | 96 KiB | 12.0 GiB |
| Qwen3.6-27B | 16 / 64 | 64 KiB | 8.0 GiB |
| Llama 3.1 8B | 32 | 128 KiB | 16.0 GiB |
这张表有两个反直觉结论。第一,8B 的 KV 单价比 30B MoE 更贵:Llama 3.1 8B 每 token 128 KiB,是 Qwen3-30B-A3B 的 1.33 倍。第二,8B 反而更可能开得动 128K:它的权重只有 4.6 GiB,128K KV 16 GiB,合计 20.6 GiB,24GB 卡勉强装得下;30B MoE 的权重已经 17.3 GiB,再加 12 GiB KV 就 29.3 GiB,没有任何余地。
Qwen3.6-27B 是另一种思路:64 层里只有 16 层是全注意力,其余是线性注意力,KV 只按 16 层算,所以每 token 64 KiB,比 30B-A3B 还低。它的 max_position_embeddings 是 262,144,但 128K KV 也要 8 GiB,权重按 Q4 约 14 GiB,合计 22 GiB,属于「能起但很紧」。
Qwen3 官方 README 写的是:原生 32K,
config.json的 40,960 是给输出预留后的值;131K 要 YaRN,factor4.0。官方同时提醒,静态 YaRN 会伤短文本,平均上下文不超过 32K 时不建议开。
所以选型别只看参数量。先打开 config.json,看 num_key_value_heads、head_dim、layer_types,再算你自己的卡能不能装下「权重 + 目标上下文的 KV」。这一步比看任何跑分都准。
NVIDIA 这篇《You don't need long context》到底测了什么
论文是 arXiv:2611.05306,2026 年 11 月 3 日提交,31 页、8 张图,12 位 NVIDIA Research 作者。它没有否定长上下文的存在价值,而是问了一个更实际的问题:完成那些「看起来需要长上下文」的任务,真的需要把全部历史一直放在窗口里吗?
作者把任务分成两类:长程任务(agent 要连续做很多步)和长输入任务(一次给很多文档)。然后对比三种上下文策略:
- 全量历史:每一步都带着之前所有消息和工具输出。
- EoCC(对话末尾压缩):历史到阈值时,让模型写一份摘要,带着摘要和原始任务重新开一段对话。
- SAC(单动作压缩):每段上下文只执行一个动作,写一份状态描述,然后丢掉全部历史,下一步从状态描述继续。
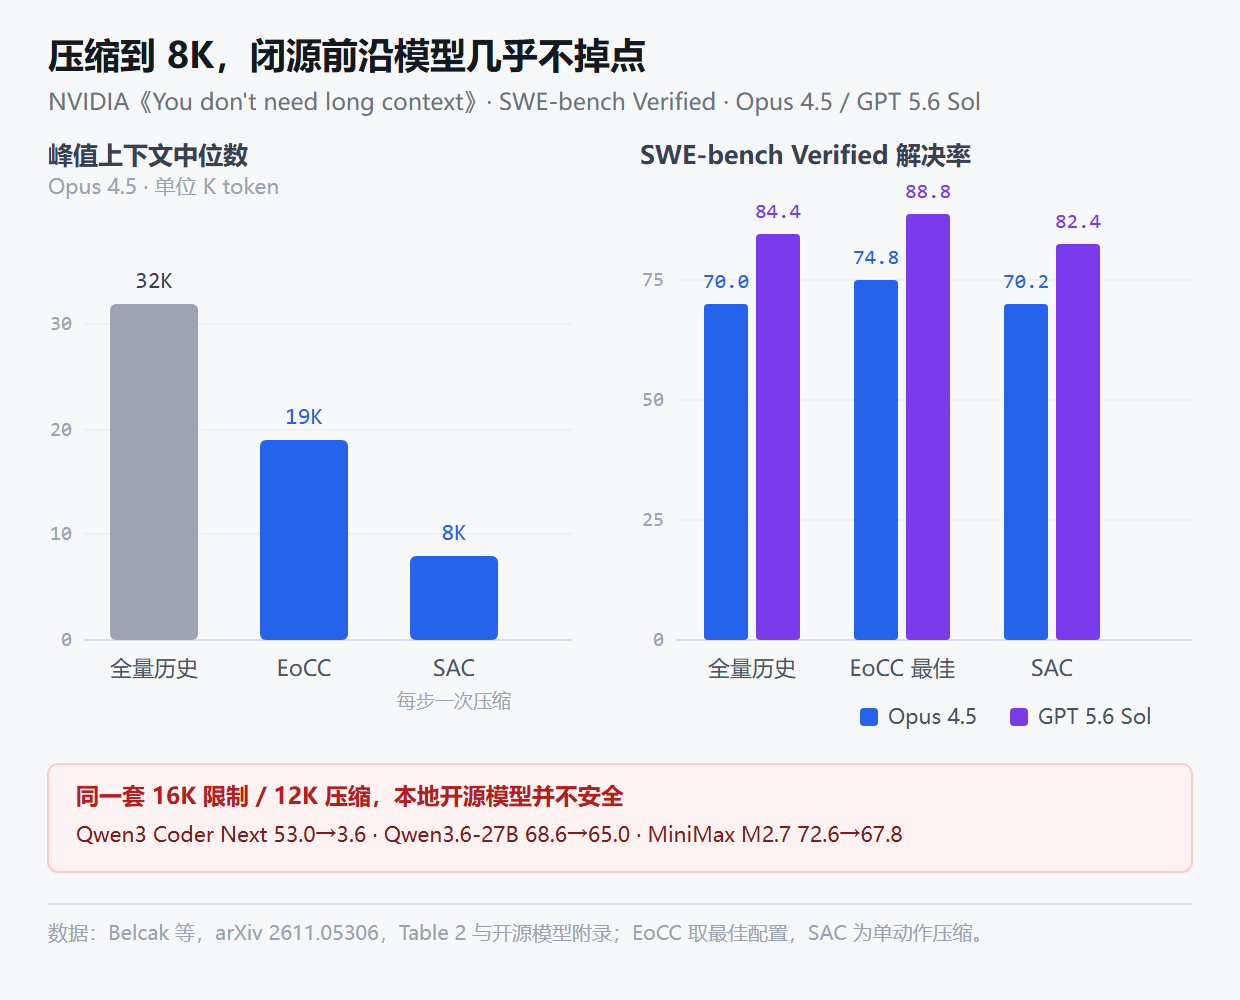
测试覆盖 13 个基准,包括 SWE-bench Verified、Terminal-Bench 2.1、FRAMES、τ²-bench,以及 LongBench v2、LOONG、AA-LCR、RULER、BABILong。主实验用 Claude Opus 4.5 和 GPT 5.6 Sol;上下文上限从 128K 一路压到 16K,最紧的一档在 12K 触发压缩。
| 策略 | 峰值上下文中位数 | Opus 4.5 | GPT 5.6 Sol |
|---|---|---|---|
| 全量历史 | 32K | 70.0% | 84.4% |
| EoCC 最佳配置 | 19K | 74.8% | 88.8% |
| SAC | 7–9K | 70.2% | 82.4% |
数字很扎眼:Opus 4.5 用 EoCC 把峰值上下文从 32K 压到 19K,SWE-bench 反而从 70.0% 升到 74.8%;SAC 把峰值压到 8K 左右,Opus 基本持平,GPT 5.6 Sol 掉 2 个点。22 组压缩配置里,每个模型最多只有 5 组掉超过 2 个点。
成本侧,作者用 vLLM 在 H100 上测了 256K 与 16K 的差距:同样生成一个输出 token,256K 窗口的成本是 16K 窗口的 3.6 倍(GLM 5.2)、5.6 倍(Kimi K2.6)、7 倍(Qwen 3 Coder Next)。估算的整体服务成本下降 2.2–8.8 倍。在 DGX Spark 上,长上下文的生成延迟大约是短上下文的两倍。
反常识:压缩对闭源模型几乎无损,对本地开源模型可能崩
论文最该被本地部署者记住的,不是「8K 就够」,而是附录里那张开源模型表。五个量化后的本地模型,在 16K 限制 / 12K 压缩下全部掉点,而且不是掉一两个点:
| 模型 | 全量历史 | 16K 限制 / 12K 压缩 | 变化 |
|---|---|---|---|
| Qwen3 Coder Next | 53.0% | 3.6% | −49.4 个点 |
| Qwen3.6-27B | 68.6% | 65.0% | −3.6 个点 |
| MiniMax M2.7 | 72.6% | 67.8% | −4.8 个点 |
Qwen3 Coder Next 几乎是从「能修一半 bug」掉到「基本不会修」。作者给的归因很具体:这个模型的工作轨迹太长,压缩之后留给实际任务的预算太少,它在两次压缩之间还没干完一件事,就又被压了一次。
这解释了一个很多人踩过的坑:你在 API 上试 12K 压缩觉得很香,搬到本地 30B 级开源模型上,同样的阈值可能直接把 agent 干废。 闭源前沿模型更会写「交接单」,小模型更容易把摘要写成流水账,把真正有用的文件路径、测试命令、失败原因挤掉。
论文自己也留了边界:它没有说所有任务都能压到 8K;像「记住第 i 次抛硬币的结果」这种需要逐字召回的任务,有损压缩一定会失败。作者的建议是把完整历史留在磁盘上,让 agent 需要时去搜,而不是指望摘要记住一切。
主流云端方案 vs 24GB 单卡:哪些经验能搬,哪些不能
| 维度 | 云端 1M 上下文 | 24GB 单卡自建 | 落地判断 |
|---|---|---|---|
| 上下文上限 | 模型卡写多少就能开多少 | 32K 原生,131K 要 YaRN,还要看 KV | 别把模型卡当显存预算 |
| 成本结构 | 按 token 计费,长上下文单价不变但总算力更贵 | 买卡 + 电费,闲置也花钱 | 低负载时自建不一定便宜 |
| 压缩代价 | 闭源前沿模型几乎无损 | 开源小模型可能掉几十个点 | 先用自己的任务做 A/B |
| 失败模式 | 账单变高、延迟变长 | 启动 ValueError、warmup OOM、preemption | 看启动日志,不要猜 |
| 长文档 | 直接塞进 prompt | 文件 + grep 选读更稳 | 选读优于摘要 |
| 并发 | 弹性扩容 | 单卡排队,KV 被并发切碎 | 先降 max-num-seqs |
能搬的经验是「压缩 + 选读」这两个动作;不能搬的是「闭源模型对压缩的容忍度」。同一套 12K 阈值,在 Opus 4.5 上是省钱的技巧,在 Qwen3 Coder Next 上是性能事故。 本地部署必须自己校准,校准成本也就是跑十几道你真实任务的题。
vLLM 四步:把 max-model-len 压到装得下
第一步:先让 vLLM 自己报一次上限
不要一上来就写 131072。第一次启动用 auto,让引擎按当前显存算出「最长能装多少」,日志会打印 Auto-fit max_model_len: reduced from … to …。这个数字比任何教程都贴合你的卡。
vllm serve Qwen/Qwen3-30B-A3B \
  --max-model-len auto \
  --gpu-memory-utilization 0.92 \
  --max-num-seqs 1 \
--port 8000启动后盯两行日志:GPU KV cache size: … tokens 和 Maximum concurrency for … tokens per request: …x。前者是 KV 池总共能装多少 token,后者是按某个长度算能并发几条。这两个数字才是你卡的真实上限。
第二步:按真实负载定一个固定值
把 auto 报出来的值,减掉 10–15% 的余量,写死。--max-model-len 算的是「输入 + 输出」的总和,不是只有 prompt;如果你要留 4K 输出,32K 的窗口实际只有 28K 给输入。24GB 卡 + 30B-A3B Q4,建议从 24K 起步:
vllm serve Qwen/Qwen3-30B-A3B \
  --max-model-len 24576 \
  --gpu-memory-utilization 0.92 \
  --max-num-seqs 1 \
  --max-num-batched-tokens 4096 \
--port 8000四个参数各管一件事:max-model-len 是单请求上限;gpu-memory-utilization 是总预算比例;max-num-seqs 1 是把并发压到单用户,避免 KV 被切碎;max-num-batched-tokens 限制一次 prefill 的 token 数,防止长 prompt 把激活峰值顶爆。
第三步:KV 还是不够,再动 FP8
--kv-cache-dtype fp8 把每元素从 2 字节降到 1 字节,理论上 KV 减半。但它不是万能钥匙:FP8 需要显卡和后端支持,而且某些情况下会切到 FlashInfer,反而让可用 KV 变少。24GB 卡上,30B-A3B 即使开 FP8,128K 也要 6 GiB KV,加 17.3 GiB 权重还是 23.3 GiB,超过 22.08 GiB 的预算——仍然起不来。
# Ada/Hopper 可以先试;30 系先跑 bf16,确认启动日志没回退再开
vllm serve Qwen/Qwen3-30B-A3B \
  --max-model-len 24576 \
  --gpu-memory-utilization 0.92 \
  --kv-cache-dtype fp8 \
  --max-num-seqs 1 \
  --port 8000
第四步:用日志验收,不要用体感
服务起来不等于配置对了。看三件事:启动日志里的 KV token 数是否大于 max-model-len;请求高峰有没有 preempted by PreemptionMode.RECOMPUTE 警告;nvidia-smi 的显存是否长期贴着上限。出现 preemption 不是内存泄漏,是 KV 池被并发或长请求吃满了,先降 max-model-len 或 max-num-seqs。
llama.cpp / Ollama 用户怎么对齐同一套预算
llama.cpp:-c 是总预算,-ctk/-ctv 是 KV 精度
llama.cpp 的 -c(--ctx-size)就是上下文总预算,和 vLLM 的 max-model-len 一个意思。量化 KV 用 -ctk q8_0 -ctv q8_0,但V cache 量化强制要求 flash attention;当前构建在 -fa auto 下会自动打开,显式写 -fa off 会报 quantized V cache requires flash_attn to be enabled。
llama-server -m qwen3-30b-a3b-q4_k_m.gguf \
  -c 24576 -ngl 99 -fa on \
  -ctk q8_0 -ctv q8_0 \
  --host 0.0.0.0 --port 8080
注意 q8_0 不是「正好一半」。因为每个 32 元素的块还要存一个 16 位 scale,实际是 FP16 的 53.1%,不是 50%。做预算时按 53% 估,别按 50% 估,边缘配置就差这一点。
Ollama:默认上下文不是一个固定数字
Ollama 官方两个页面的口径并不一致:FAQ 还写着「默认 4096」,context length 页则说按显存分档——24 GiB 以下 4K、24–48 GiB 32K、48 GiB 以上 256K(v0.15.5 起)。所以不要猜默认值,跑 ollama ps 看 CONTEXT 列,那才是模型实际加载的窗口。
OLLAMA_CONTEXT_LENGTH=24576 \
OLLAMA_FLASH_ATTENTION=1 \
OLLAMA_KV_CACHE_TYPE=q8_0 \
ollama serve

ollama ps   # 看 CONTEXT 与 PROCESSOR 两列
还有两个静默坑。第一,请求里的 num_ctx 优先级高于服务端环境变量,Open WebUI 这类前端经常自带 num_ctx,你改了服务端也不生效。第二,Ollama 超长时不会报错,它会静默丢掉最旧的 token;表现不是崩溃,而是「聊着聊着忘了系统提示」。看到这种行为,先查 CONTEXT,不要先怀疑模型。
压缩阈值怎么定:12K 不是万能数字
把「窗口上限」和「工作集阈值」分开看。窗口上限是 --max-model-len / -c,决定显存;工作集阈值是 agent 什么时候触发压缩,决定准确率。两者可以不一样:窗口开 64K,不代表要等 64K 才压缩。
| 硬件 / 模型 | 窗口上限 | 建议压缩阈值 | 依据 |
|---|---|---|---|
| 24GB + Qwen3-30B-A3B Q4 | 24K | 20K | KV 2.25 GiB,余量 2.5 GiB |
| 24GB + Qwen3.6-27B Q4 | 64K | 48K | KV 4 GiB,权重约 14 GiB |
| 24GB + Llama 3.1 8B Q4 | 128K | 32K | KV 16 GiB,权重 4.6 GiB,能装但并发基本为零 |
| 48–64GB 单卡 | 128K | 48K | 给并发和激活留余量 |
| 128GB 统一内存(DGX Spark 类) | 128K | 32K | 长上下文延迟约 2 倍,agent 不必等满 |
这张表是按显存算的上限,不是速度或准确率最优值;真正的阈值要用你自己的 10–20 道题 A/B 一次。
阈值不是拍脑袋,要按模型脾气调。Qwen3 Coder Next 这种「话多、轨迹长」的模型,12K 压缩会把它压死;Qwen3.6-27B、MiniMax M2.7 在同样条件下只掉 3–5 个点。判断方法很简单:拿 10–20 道你真实会遇到的题,分别在「全量」「目标阈值」「更紧一档」下跑一遍,比较完成率和重复劳动次数。准确率掉超过 5 个点,或者 agent 开始重复已经做过的事,就说明阈值太紧。
压缩提示词也别写成「总结一下上文」。论文里效果最好的是交接单,固定七项:
原始目标(逐字拷贝,不要改写)
已验证的事实(带文件路径 / 命令 / 输出摘要)
关键文件与结果(只写路径和结论,不贴全文)
已经做过的改动(文件 + 改了什么)
死路(试过但失败的方向,避免重复)
剩余工作(按优先级列)
下一步(一个具体动作,不要写「继续排查」)
这七项里,「死路」最容易被省略,也最值钱。没有它,压缩后的 agent 会把失败的方案再试一遍,你看到的现象是「越压越慢」。
长文档别塞上下文:文件 + grep 比摘要更省
论文对长输入任务的处理不是「压缩」,而是「选择性读取」:把整份文档存成文件,agent 用 grep、head、sed 取需要的片段,只把片段放进上下文。这个动作把「长输入」转换成了「多步长程任务」,每一段的上下文都很短。
# 先定位,再读窗口,不要把整份文件 cat 进 prompt
rg -n "违约金|管辖|自动续约" docs/contracts/2026-*.md

# 只取命中的上下文窗口
sed -n '120,180p' docs/contracts/acme-2026.md
效果比「让模型总结全文」更好:NIAH 大海捞针,Opus 4.5 从 60% 提到 100%,两个模型都到 100%;AA-LCR 从 65% 提到 84%;LOONG 从 70.1% 提到 79.3%,全对率从 38.9% 提到 53.4%;RULER 从 62.5% 提到 95.7%。作者的原话大意是:主要收益不是「把读过的内容总结好」,而是「一开始就只读该读的」。
落地时给 agent 一个固定目录,比让它自由发挥可靠:
docs/            # 原始文档,只读,不塞进 prompt
notes/state.md   # 当前任务状态(交接单)
notes/decisions.md
notes/dead-ends.md
src/             # 代码仓库
每次压缩只更新 state.md,原始文档永远留在 docs/。这样即使摘要丢了细节,agent 还能回去搜。论文的建议也是这个方向:完整历史留在磁盘,上下文只保留「去哪找」的线索。
常见翻车报错与急救清单
| 现象 | 大概率原因 | 处理 |
|---|---|---|
max seq len … larger than … KV cache | max-model-len 超过 KV 池容量 | 降到日志给的估计值;或提高 gpu-memory-utilization;或开 FP8 KV / 多卡 TP |
To serve at least one request … KV cache is needed | 新版 vLLM 的同一类预算检查 | 同上;先试 --max-model-len auto 拿到可行值 |
| 启动 warmup 阶段 CUDA OOM | 激活峰值 + CUDA graph 超预算 | --max-num-seqs 1、--max-num-batched-tokens 2048、--enforce-eager |
服务能起,日志反复 preempted | KV 池被长请求或并发吃满 | 降 max-model-len 或 max-num-seqs;不是内存泄漏 |
| 128K 能起,但输出重复/跑题 | 没开 YaRN,或静态 YaRN factor 不对 | 加 --rope-scaling factor 4.0;短任务别开 |
| 开了 YaRN,短问答反而变差 | 静态缩放伤了短文本 | 关掉 YaRN;或把 factor 降到 2.0 |
| Ollama 聊一会儿就忘系统提示 | CONTEXT 太小,或前端 num_ctx 覆盖 | ollama ps 看 CONTEXT;设 OLLAMA_CONTEXT_LENGTH 或 Modelfile |
-ctv q8_0 启动失败 | 没开 flash attention | 加 -fa on;或先只量化 K(-ctk q8_0) |
| 压缩后 agent 重复劳动 | 摘要没写「死路」和「下一步」 | 换成交接单七项模板;阈值放宽 8K |
| FP8 KV 后答案变差 / 后端回退 | 显卡或 attention backend 不支持 | 换回 bf16;检查启动日志的 attention backend |
| 请求 400:input + max_tokens 超限 | max-model-len 是输入+输出总和 | 把 max_tokens 算进预算,或降 prompt 长度 |
什么时候该用长上下文,什么时候别硬上
该用长上下文:需要逐字召回的单文档任务,比如合同条款比对、论文公式核对、音频时间轴对齐;或者工具链根本没法做检索的一次性分析。这些任务压缩会丢细节,直接给全文更稳。
别硬上:多小时的 coding agent、海量日志排查、24GB 卡跑 30B 级模型、开源模型且输出很啰嗦的场景。这些场景的瓶颈不是「模型看不看得见」,而是「看完要花多少 KV、压缩后还记不记得住」。
论文的边界也要说清楚:主实验用的是 Claude Opus 4.5 和 GPT 5.6 Sol,都是闭源前沿模型,而且不是最新一代(Opus 5.5 / GPT-6.1 Sol 已出);开源模型只在附录里测了五个量化版本,样本不大。作者提出的 SSSM(语义状态空间模型)还只是一个概念,没有训练出模型。它证明的是「压缩在很多时候够用」,不是「长上下文没用」。
如果你只想记一句话:先算 KV,再定窗口;先做交接单,再谈压缩;12K 是论文的最紧一档,不是你的默认值。 24GB 卡上,Qwen3-30B-A3B 从 24K 起步,比抄一个 131072 靠谱得多。
登录后可点赞、收藏与反馈。


